Arhitectură, instalare și separarea datelor
Cum sunt legate componentele AI Hub, cum este instalată platforma (SaaS), ce se poate rula la client (on-premise și edge) și cum sunt separate sau partajate datele între organizații, proiecte și roluri. Pagina răspunde și cerințelor rămase deschise la demonstrația din 2023.
Arhitectura logică
| Sistem C.4 | Aplicații | Pagina |
|---|---|---|
| Data Augmentation – Tagging | Data Studio, adaptoarele de format, rapoartele BI de cost și calitate | Data Augmentation |
| Human-Attention Marketplace | sesiunile de augmentare din portal, auditul, rapoartele de atenție umană | Marketplace |
| Training and Operating Model Factory | portalul, backend-ul, MLOps, MLflow | Model Factory |
| Core Stack | autentificarea unică, API-ul de inferență, exemplele de integrare | Core Stack |
| Librărie Algoritmi | registrul MLflow, modelele, aplicațiile video, biometrie, senzori | Librărie |
Instalarea SaaS (cea care rulează azi)
AI Hub rulează ca serviciu (SaaS) pentru toate organizațiile: o singură instalare, accesată prin internet, cu conturi și proiecte separate.
| Strat | Ce rulează | Detalii |
|---|---|---|
| Acces | nginx cu TLS pe fiecare subdomeniu; serviciile ascultă doar pe 127.0.0.1 | firewall: porturile 22, 80, 443, 2022 |
| Autentificare | serviciul SSO (cookie pe .onprem.ai-hub.cloud), JWT pentru API-ul backend, chei API pentru API-ul de inferență |
Autentificare unică |
| Aplicații | backend Symfony (php-fpm), Data Studio, ZenML, MLflow, Metabase, API de inferență, video, bio, senzori | containere Docker (docker-compose) |
| Date | PostgreSQL (backend, Data Studio, MLflow), MySQL (ZenML), MinIO S3 și registry Docker în k3s, SQLite în aplicațiile demo | secretele de acces sunt doar pe server, într-un fișier cu acces restricționat |
| Calcul | 6× NVIDIA A40 48 GB, alocate pe servicii (tabelul din diagramă) | antrenările rulează ca containere pe GPU-ul alocat |
Instalarea la client (on-premise) și procesarea la margine (edge)
Ce există azi pentru rularea în afara instalării SaaS:
| Variantă | Ce rulează la client | Ce rămâne în AI Hub | Stare |
|---|---|---|---|
| Edge video | clientul edge: detecție SSDlite pe CPU, urmărire, regula de linie, potrivirea specimenelor primite din cloud | primește doar evenimente și embedding-uri (nu cadre video), le publică și le caută | funcțional demonstrat (dispozitivul edge-demo-01) |
| Biometrie pe dispozitiv | detecția, embedding-ul și potrivirea feței, în browser; cheia dispozitivului | doar hash-ul șablonului și verificarea semnăturii | funcțional (fluxurile cu camera netestate cu cameră reală) |
| Modele la client | modelele din librărie (inclusiv Whisper RO v5 și Gemma 3 4B pentru extracție) rulate de API-ul de inferență pe serverul clientului; modelele antrenate la client rămân la client | nimic | funcțional incluse în pachetul on-premise: 16 modele servite și librăria MLflow (20 de modele, 30 de versiuni) |
| Aplicațiile clientului | exemplele Core Stack (Python, PHP, Java, C++) în infrastructura clientului | API-ul de inferență, apelat cu cheie API | funcțional |
| Date la furnizor | setul de date rămâne pe serverul furnizorului, cu extensia AI Hub (link semnat, contorizarea traficului, raport către AI Hub) | metadatele setului, accesul pe proiect și traseul datelor | funcțional demonstrat cu supplier-demo.onprem.ai-hub.cloud, un server de furnizor simulat (găzduit tot pe serverul AI Hub) |
| Platforma întreagă la client | toate serviciile, pe serverul clientului, instalate offline din pachet | nimic | funcțional pachetul de instalare on-premise, testat pe un server separat (detalii mai jos) |
Pachetul de instalare on-premise
Pachetul on-premise instalează toată platforma pe un singur server cu GPU, fără să descarce nimic din internet: portalul, API-ul platformei, autentificarea unică, Data Studio, MLOps (ZenML), MLflow cu librăria de modele, BI (Metabase), API-ul de inferență cu cele 16 modele, analiza video, identificarea biometrică, senzorii, re-antrenarea automată, joburile programate (anonimizarea GDPR a încărcărilor, prognoza atenției umane) și această documentație.
| Conținut | Detalii |
|---|---|
| Imagini Docker | 25 de imagini în 4 arhive (platformă, aplicații, antrenare, joburi), încărcate local |
| Cod și site-uri | serviciile AI Hub, portalul (build-ul de producție), dashboard-ul MLOps, documentația |
| Modele | modelele servite de API-ul de inferență, modelele aplicațiilor (față, video, senzori), modelele de bază pentru antrenare (Whisper, TrOCR, CLIP, Gemma 3 1B) |
| Baze de date | schema platformei cu datele de referință (roluri, permisiuni, tipuri de date), schema rapoartelor BI; fără date ale clienților SaaS |
| Conținut | dashboard-urile BI (5 dashboard-uri, 26 de întrebări), librăria MLflow (20 de modele, 30 de versiuni, cu metricile de evaluare) |
| Integritate | MANIFEST.sha256 cu sumele de control ale celor peste 1.400 de fișiere, verificat la fiecare instalare |
Dimensiunea pachetului: 38 GB. Cerințe: Linux x86-64, Docker ≥ 24 cu pluginul compose, driver NVIDIA și NVIDIA Container Toolkit, 1–3 GPU (48 GB recomandat), minim 64 GB RAM, DNS pentru domeniul ales și subdomeniile lui.
Instalarea (sudo ./install.sh aihub.conf) se face în 9 pași, fiecare verificat:
- verificarea cerințelor (Docker, GPU, memorie, spațiu, porturi) și a integrității pachetului;
- copierea fișierelor și adaptarea codului și a site-urilor la domeniul clientului;
- încărcarea imaginilor și testul GPU din containere;
- generarea tuturor parolelor și cheilor (doar pe serverul clientului), a certificatelor TLS (CA intern sau certificatul clientului) și a configurației;
- bazele de date (PostgreSQL, MySQL) și stocarea S3 (MinIO), cu utilizatori separați pe servicii;
- pornirea platformei;
- conturile inițiale (câte unul pentru fiecare rol), dashboard-urile BI, librăria de modele și stack-ul MLOps;
- aplicațiile (API de inferență, video, biometrie, senzori, re-antrenare) și joburile programate;
- verificarea cap-coadă (
aihubctl check).
Conturile inițiale sunt scrise doar pe server, într-un fișier cu acces restricționat. Re-rularea instalării păstrează
datele și secretele, deci același pachet servește și la actualizare. Operarea curentă se face cu aihubctl
(status, check, logs, train, jobs, start, stop).
Ce rămâne la client: toate datele (baze de date, fișiere încărcate, seturi de date, artefacte, modele antrenate) sunt în directorul instalării, pe serverul clientului. Instalarea nu comunică cu AI Hub SaaS.
Testul de instalare
Testul s-a făcut pe un server „client” separat: un sistem Ubuntu 22.04 cu propriul Docker (29) și NVIDIA Container
Toolkit, fără nicio imagine sau configurare AI Hub, cu 2 GPU A40 (unul pentru inferență, unul pentru aplicații și
antrenare). Domeniul clientului: onprem.onprem.ai-hub.cloud, cu certificatele emise de CA-ul intern al instalării și
un reverse proxy în fața serverului, ca într-o rețea de firmă.
| Verificare | Rezultat |
|---|---|
Instalare pe serverul gol, din pachet (2 GPU, onprem.onprem.ai-hub.cloud) |
22 / 22 verificări automate trecute: servicii prin TLS, login, autentificare unică pe roluri, 5 baze de date, 5 dashboard-uri, 16 modele servite, inferență pe GPU. Erorile găsite la această primă instalare au fost corectate în pachet |
| Actualizare peste instalarea existentă (re-rulare cu pachetul final) | 17 minute, 22 / 22 verificări; proiectele, seturile de date și rulările MLflow au rămas neatinse |
A doua instalare de la zero, fără nicio intervenție, cu pachetul final (1 GPU pentru tot, alt domeniu: aihub.client2.test) |
22 / 22 verificări, în 2 h 19 min; din acestea, 78 de minute încărcarea imaginilor și 49 de minute migrările inițiale Metabase, pe un disc folosit în paralel de instalarea SaaS și de primul server de test |
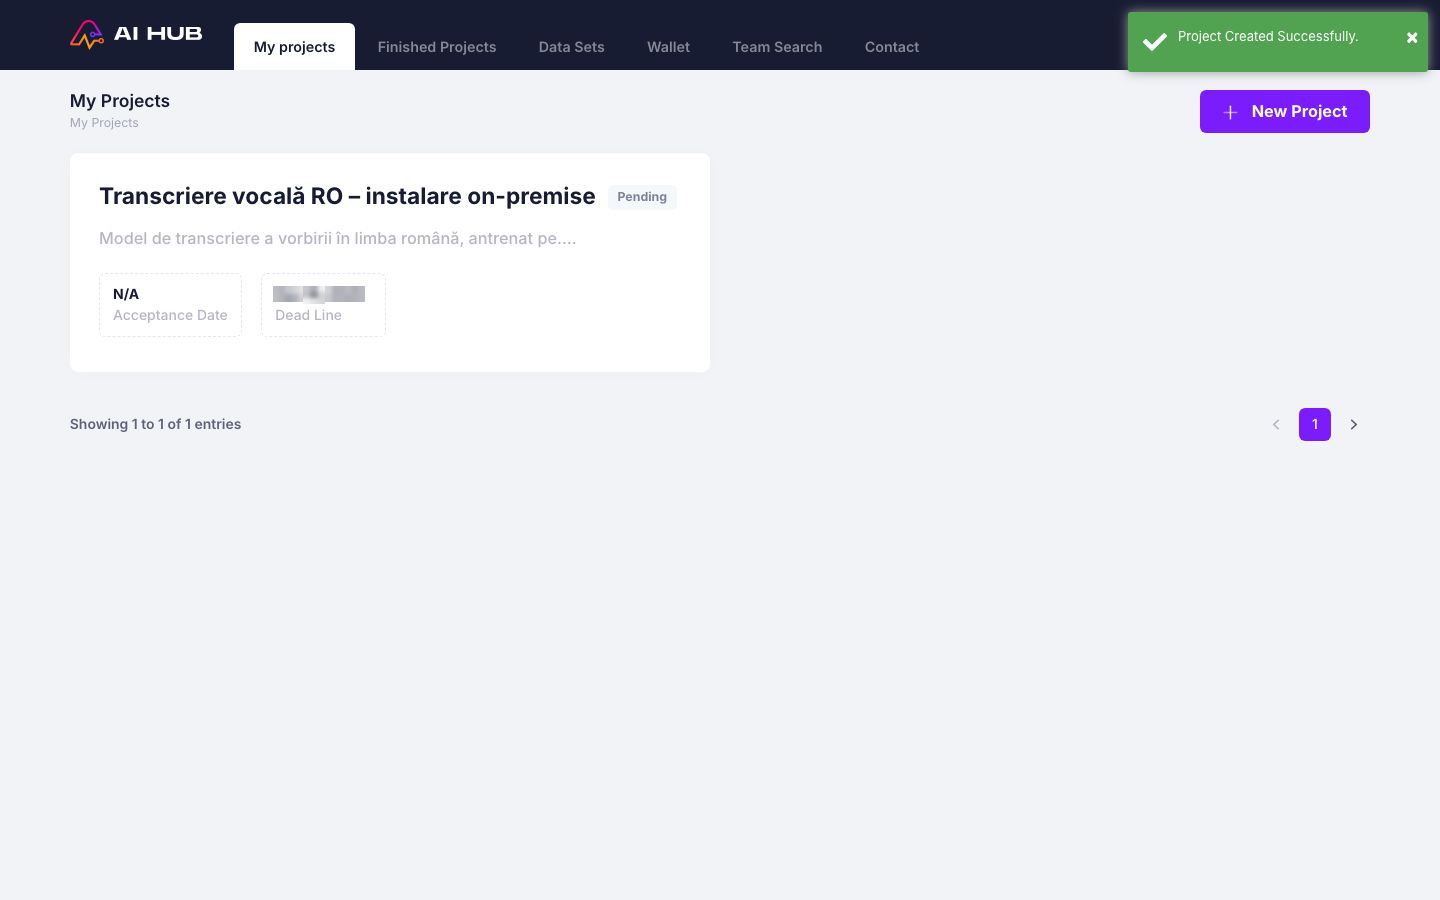
| Proiect nou în portal (Result User) | proiectul „Transcriere vocală RO – instalare on-premise”, cu echipa invitată și ținta WER ≤ 20% |
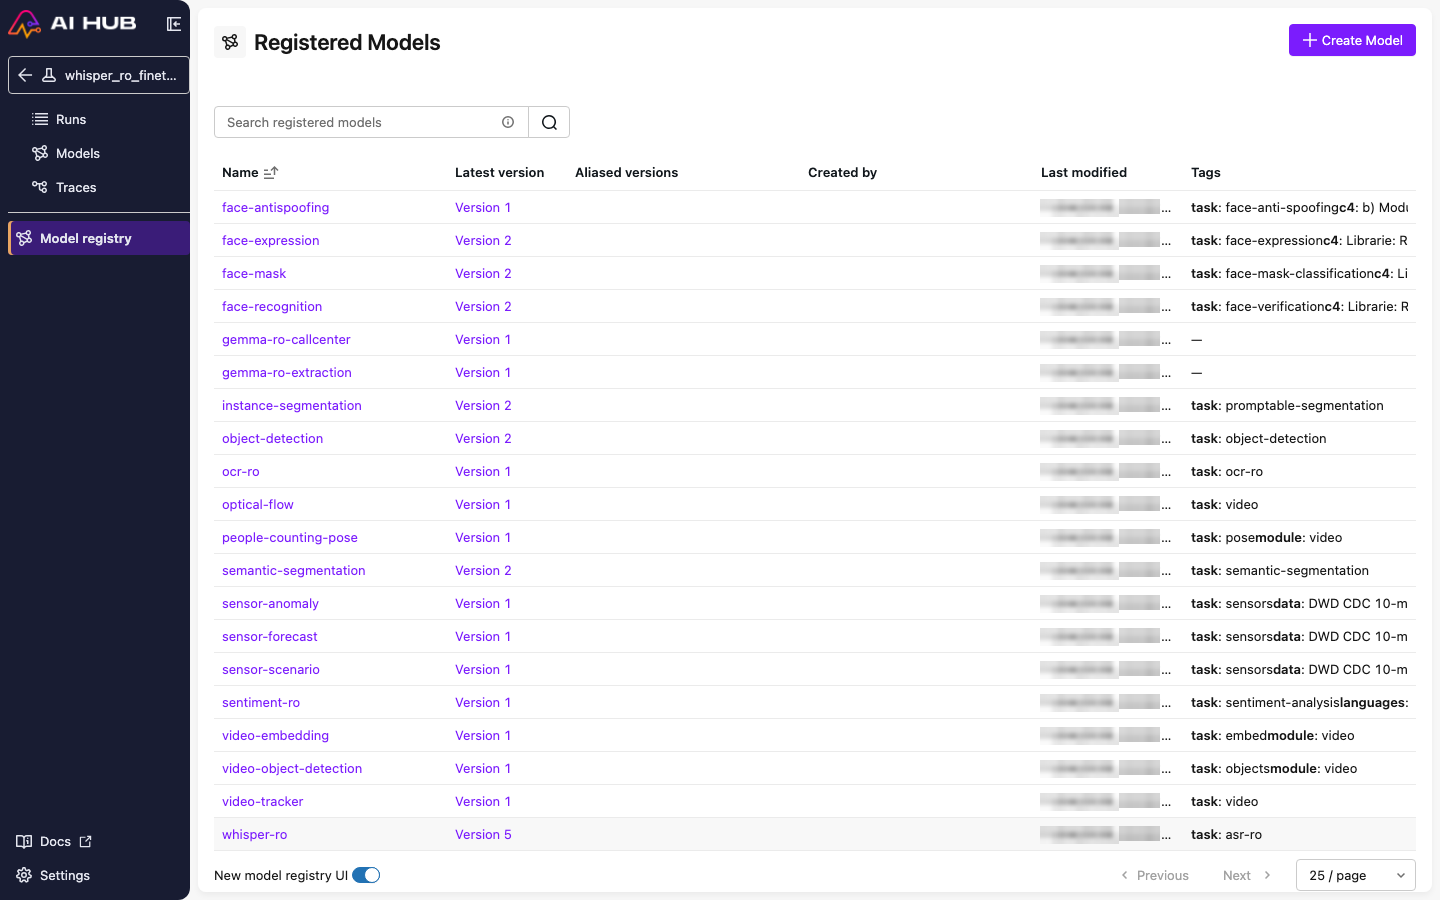
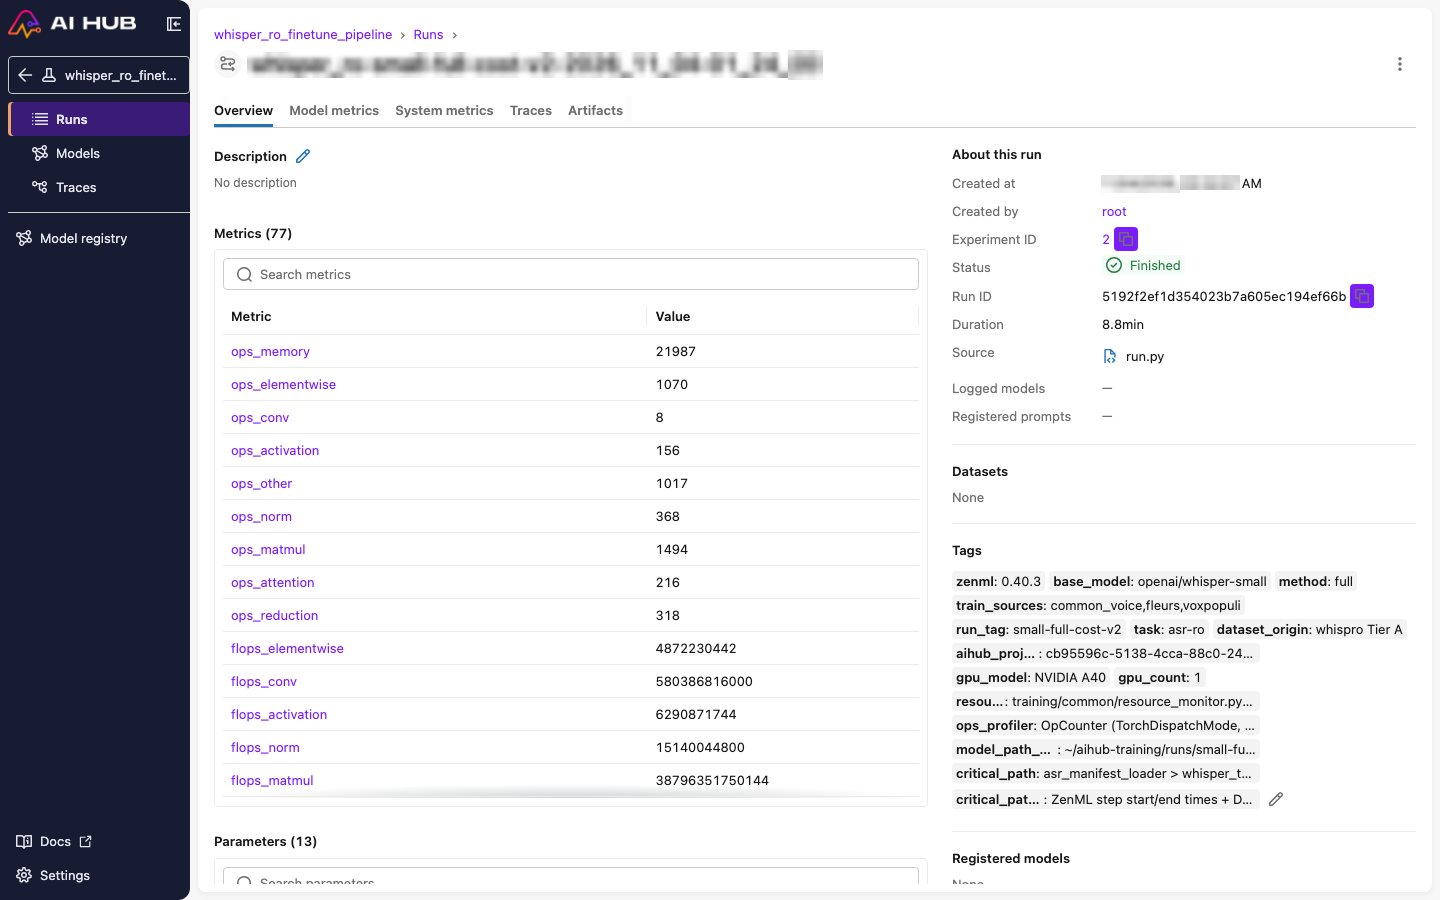
| Antrenare pe GPU-ul clientului | Whisper small, 300 de pași, 8,9 minute; WER 25,84% (FLEURS), 17,24% (Common Voice), 16,95% (VoxPopuli), media 20,01%; rularea apare în MLflow-ul și în ZenML-ul clientului, legată de proiect |
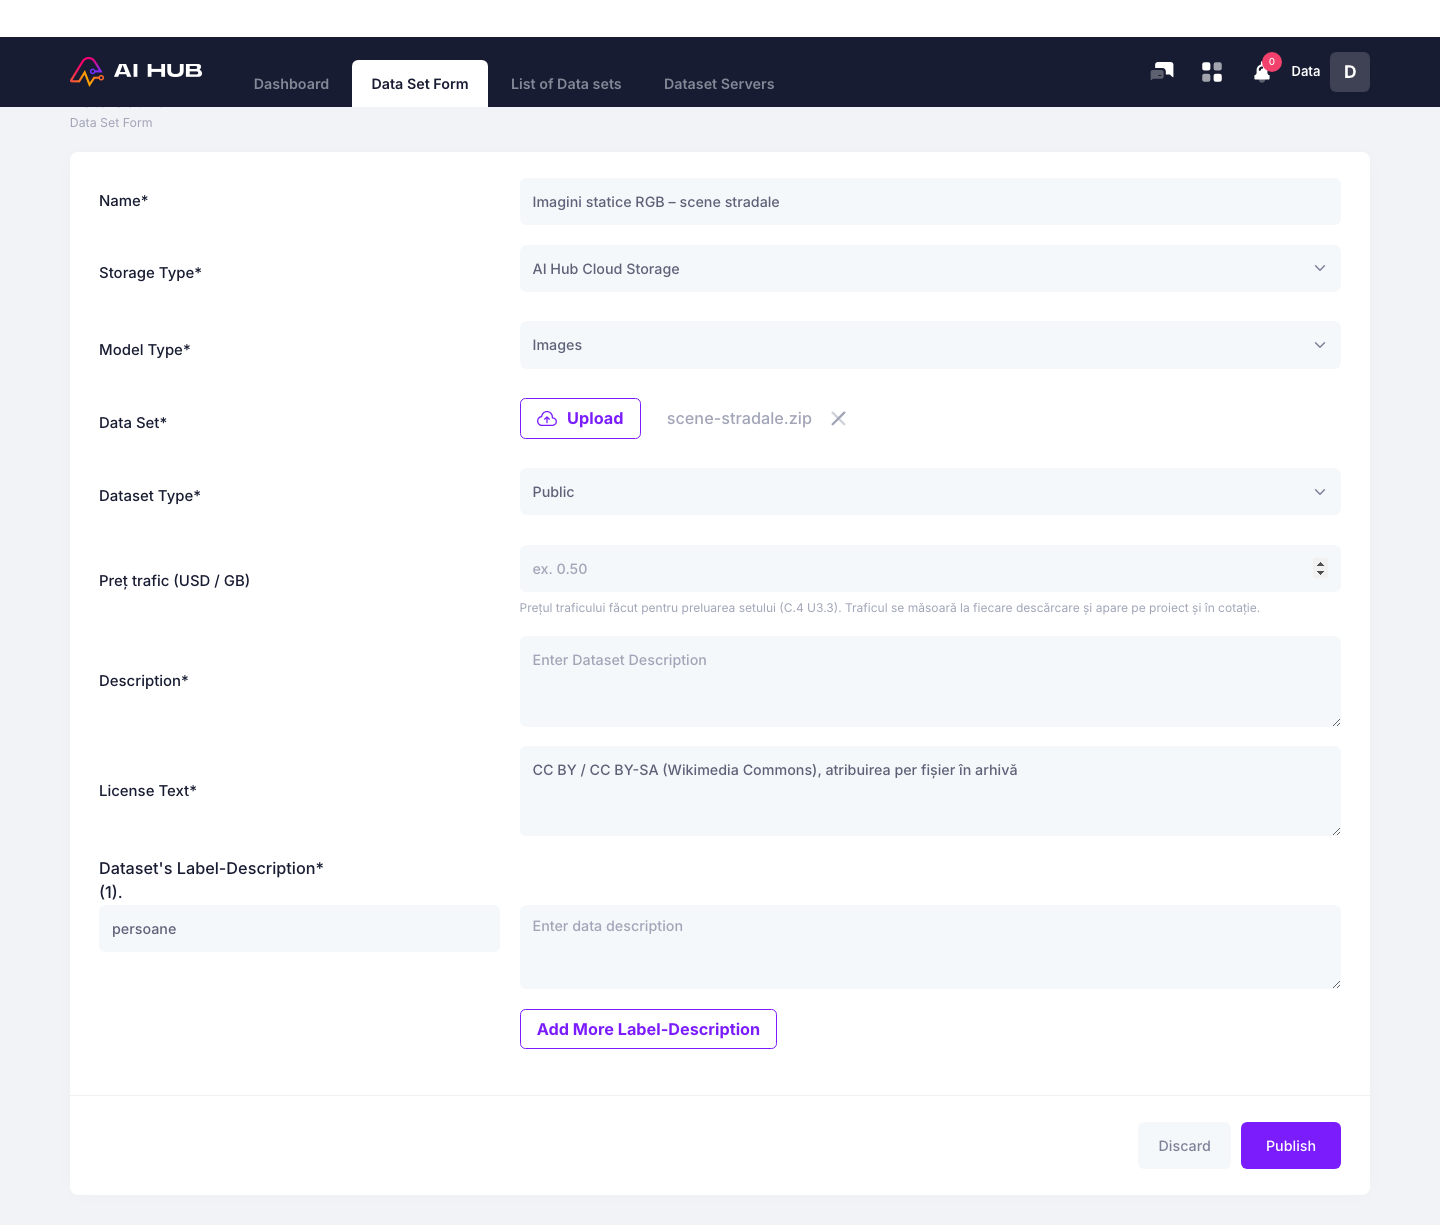
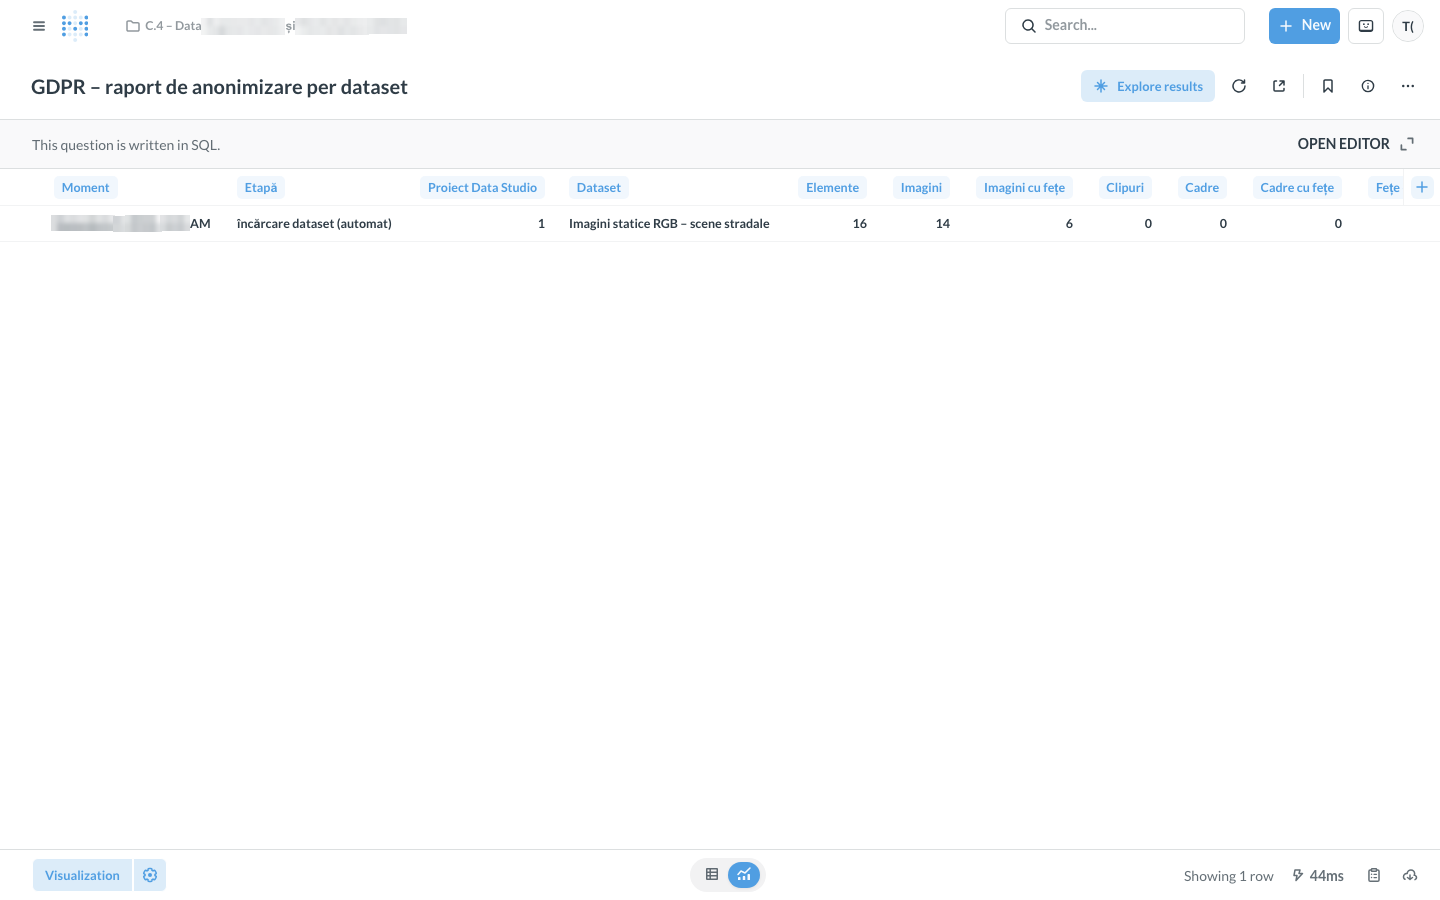
| Încărcare set de date (Data Supplier) și anonimizare GDPR automată | 14 imagini, 26 de fețe estompate, GPS eliminat din 6 imagini, raport în BI; jobul programat (la fiecare 10 minute) a procesat singur setul nou |
| Autentificare unică pe domeniul clientului | portal, Data Studio, MLflow, BI, MLOps deschise cu contul AI Hub al clientului |
Limitări
- Testul a folosit un server „client” găzduit pe aceeași mașină fizică (container cu propriul Docker și 2 GPU dedicate), nu hardware separat.
- Prima instalare durează: încărcarea imaginilor (30–80 de minute) și migrările inițiale ale bazelor Metabase și ZenML (până la o oră pe discuri încărcate) se fac o singură dată; o actualizare durează în jur de 20 de minute.
- Metabase își păstrează propriul ecran de login pentru link-urile directe la dashboard-uri; intrarea prin
metabase.<domeniu>/folosește autentificarea unică. - MinIO e construit din sursele oficiale (licență AGPL-3.0), pentru că imaginile oficiale nu mai sunt publice.
Separarea și partajarea datelor între organizații (tenanți)
În AI Hub, o organizație client corespunde unor conturi cu roluri și proiectelor create de ele. Separarea se face pe proiecte și roluri, nu pe instanțe separate ale serviciilor.
| Obiect | Cine îl vede | Mecanism |
|---|---|---|
| Proiect (descriere, buget, echipă, cereri, chat) | creatorul și membrii invitați care au acceptat | invitații pe roluri; fiecare rol are rute API proprii (/api/v1/{rol}/…) |
| Set de date – fișa din catalog | utilizatorii care caută în Marketplace | câmpurile publice: nume, tip, preț, licență, tip Public / Privat |
| Set de date – conținutul și etichetele | furnizorul și membrii proiectelor care l-au închiriat sau acceptat | Data Studio afișează doar proiectele în care utilizatorul e membru; membrii se sincronizează din portal (creator, invitați acceptați, augmentatori cu contract; set încărcat, sugerat și acceptat, închiriat, din sesiuni). Arhivele nu mai sunt publice: descărcarea se face doar prin link semnat (15 minute), după verificarea accesului prin proiect, și se înregistrează în traseul datelor. La încheierea închirierii accesul se retrage |
| Sesiune de augmentare, time log-uri | Training Operator, Project Admin, Result User, augmentatorul contractat | contract pe sesiune |
| Model ML din portal | membrii proiectului căruia i-a fost propus și creatorul | cerere de model pe proiect; editare doar de creator |
| Rulări și registru MLflow, pipeline-uri ZenML | rolurile cu acces la instrument (Training Operator, ML Model Developer, Project Admin la MLflow) | acces pe rol prin SSO; rulările au tag-ul aihub_project_id |
| Rapoarte BI | Project Admin, Training Operator, Support Specialist | acces pe rol prin SSO |
| Date biometrice | doar utilizatorul | șablon criptat legat de contul lui; ștergere la cerere |
| Tichete de suport | autorul și specialistul asignat | rute dedicate, acces doar la tichetele proprii |
Limitări
- MLflow, ZenML și Metabase sunt instanțe comune: separarea este pe rol, nu pe proiect. Un utilizator cu acces la MLflow vede toate experimentele, inclusiv ale altor proiecte.
- La încheierea unei închirieri, AI Hub retrage accesul în portal, la link-urile de descărcare și în Data Studio (sincronizare automată în câteva minute). Evenimentul este înregistrat în traseul datelor.
- Câteva proiecte Data Studio noi (163, 164) au id-uri care se suprapun cu proiecte șterse anterior, astfel că unele conturi vechi de test au acces la ele.
- Platforma nu are instanțe separate per organizație (multi-tenancy la nivel de bază de date).
Securitate și protecția datelor
| Măsură | Unde |
|---|---|
| HTTPS pe toate subdomeniile, servicii interne doar pe 127.0.0.1 | nginx, firewall |
| Autentificare unică, acces pe roluri la fiecare instrument | auth.onprem.ai-hub.cloud, auth_request în nginx |
| Audit automat al acțiunilor, cu mascarea parolelor, token-urilor și cookie-urilor | request_logs, BI dashboard-ul 4 |
| Chei și parole doar pe server, într-un fișier cu acces restricționat; niciodată în cod sau în documentație | server |
| Biometrie procesată pe dispozitiv, șablon criptat, dreptul la ștergere, dezvăluire minimă prin avatari | bio.onprem.ai-hub.cloud |
| Anonimizare GDPR la încărcare: fețe pixelate și estompate (YuNet) în imagini și cadre video, EXIF/GPS eliminat; CNP, IBAN, telefoane, e-mail, IP și nume mascate în text (NER românesc + reguli) | Data Studio, gdpr_anonymization_pipeline, BI |
| Seturi de date: arhive ne-publice, link semnat de 15 minute, traseul datelor pentru furnizor | portal, extensia de server a furnizorului |
| Video: fețe estompate în miniaturi, scopul prelucrării obligatoriu, retenție 30 de zile, jurnal de utilizare | video.onprem.ai-hub.cloud |
| Senzori: modelele nu folosesc locația | sensors.onprem.ai-hub.cloud |
| API: limite de rată, identitatea în jurnal ca amprentă, CORS fără credențiale | api.onprem.ai-hub.cloud |
Limitări
Nu există o evaluare formală de conformitate GDPR. Anonimizarea la încărcare nu acoperă numerele de înmatriculare și vocile. Câteva înregistrări vechi din jurnalul de audit (dinainte de introducerea mascării) nu au fost mascate retroactiv; nu apar în rapoarte, iar curățarea lor așteaptă acordul proprietarului datelor. Cheile API sunt statice, fără rotație automată.