Core Stack Artificial Intelligence HUB
Infrastructura software care interconectează și operează integrat modulele AI Hub (C.4, componenta 4). Un singur punct de autentificare, un API de inferență HTTPS + WebSocket care expune librăria de modele și 10 exemple de integrare în 6 tehnologii, rulate contra platformei live.
Arhitectura interconectării
| Piesă | Adresă | Rol în interconectare |
|---|---|---|
| Portal + backend Symfony | onprem.ai-hub.cloud, ai-api.onprem.ai-hub.cloud | utilizatori, roluri, proiecte, cereri; evenimente live prin Mercure (SSE) pentru chat și notificări |
| Autentificare unică (SSO) | auth.onprem.ai-hub.cloud | cookie comun pe .onprem.ai-hub.cloud, acces la instrumente pe roluri (nginx auth_request); vezi Autentificare unică |
| Data Studio | data-studio.onprem.ai-hub.cloud | date adnotate; membrii sincronizați din proiectele AI Hub |
| ZenML | mlops.onprem.ai-hub.cloud | pipeline-uri loader → trainer → evaluator, stack-ul ai-hub |
| MLflow | mlflow.onprem.ai-hub.cloud | rulări, metrici (inclusiv costul măsurat), registrul de modele |
| MinIO (S3), registry Docker, k3s | s3.onprem.ai-hub.cloud, registry.onprem.ai-hub.cloud | artefacte, date, imaginile de antrenare și ale API-ului |
| API de inferență | api.onprem.ai-hub.cloud | puntea de operare: servește modelele antrenate prin HTTPS și WebSocket celorlalte module și aplicațiilor externe; prezintă librăria (GET /v1/models) cu datele din MLflow |
Diagrama completă (logică, SaaS și on-premise) este pe pagina Arhitectură.
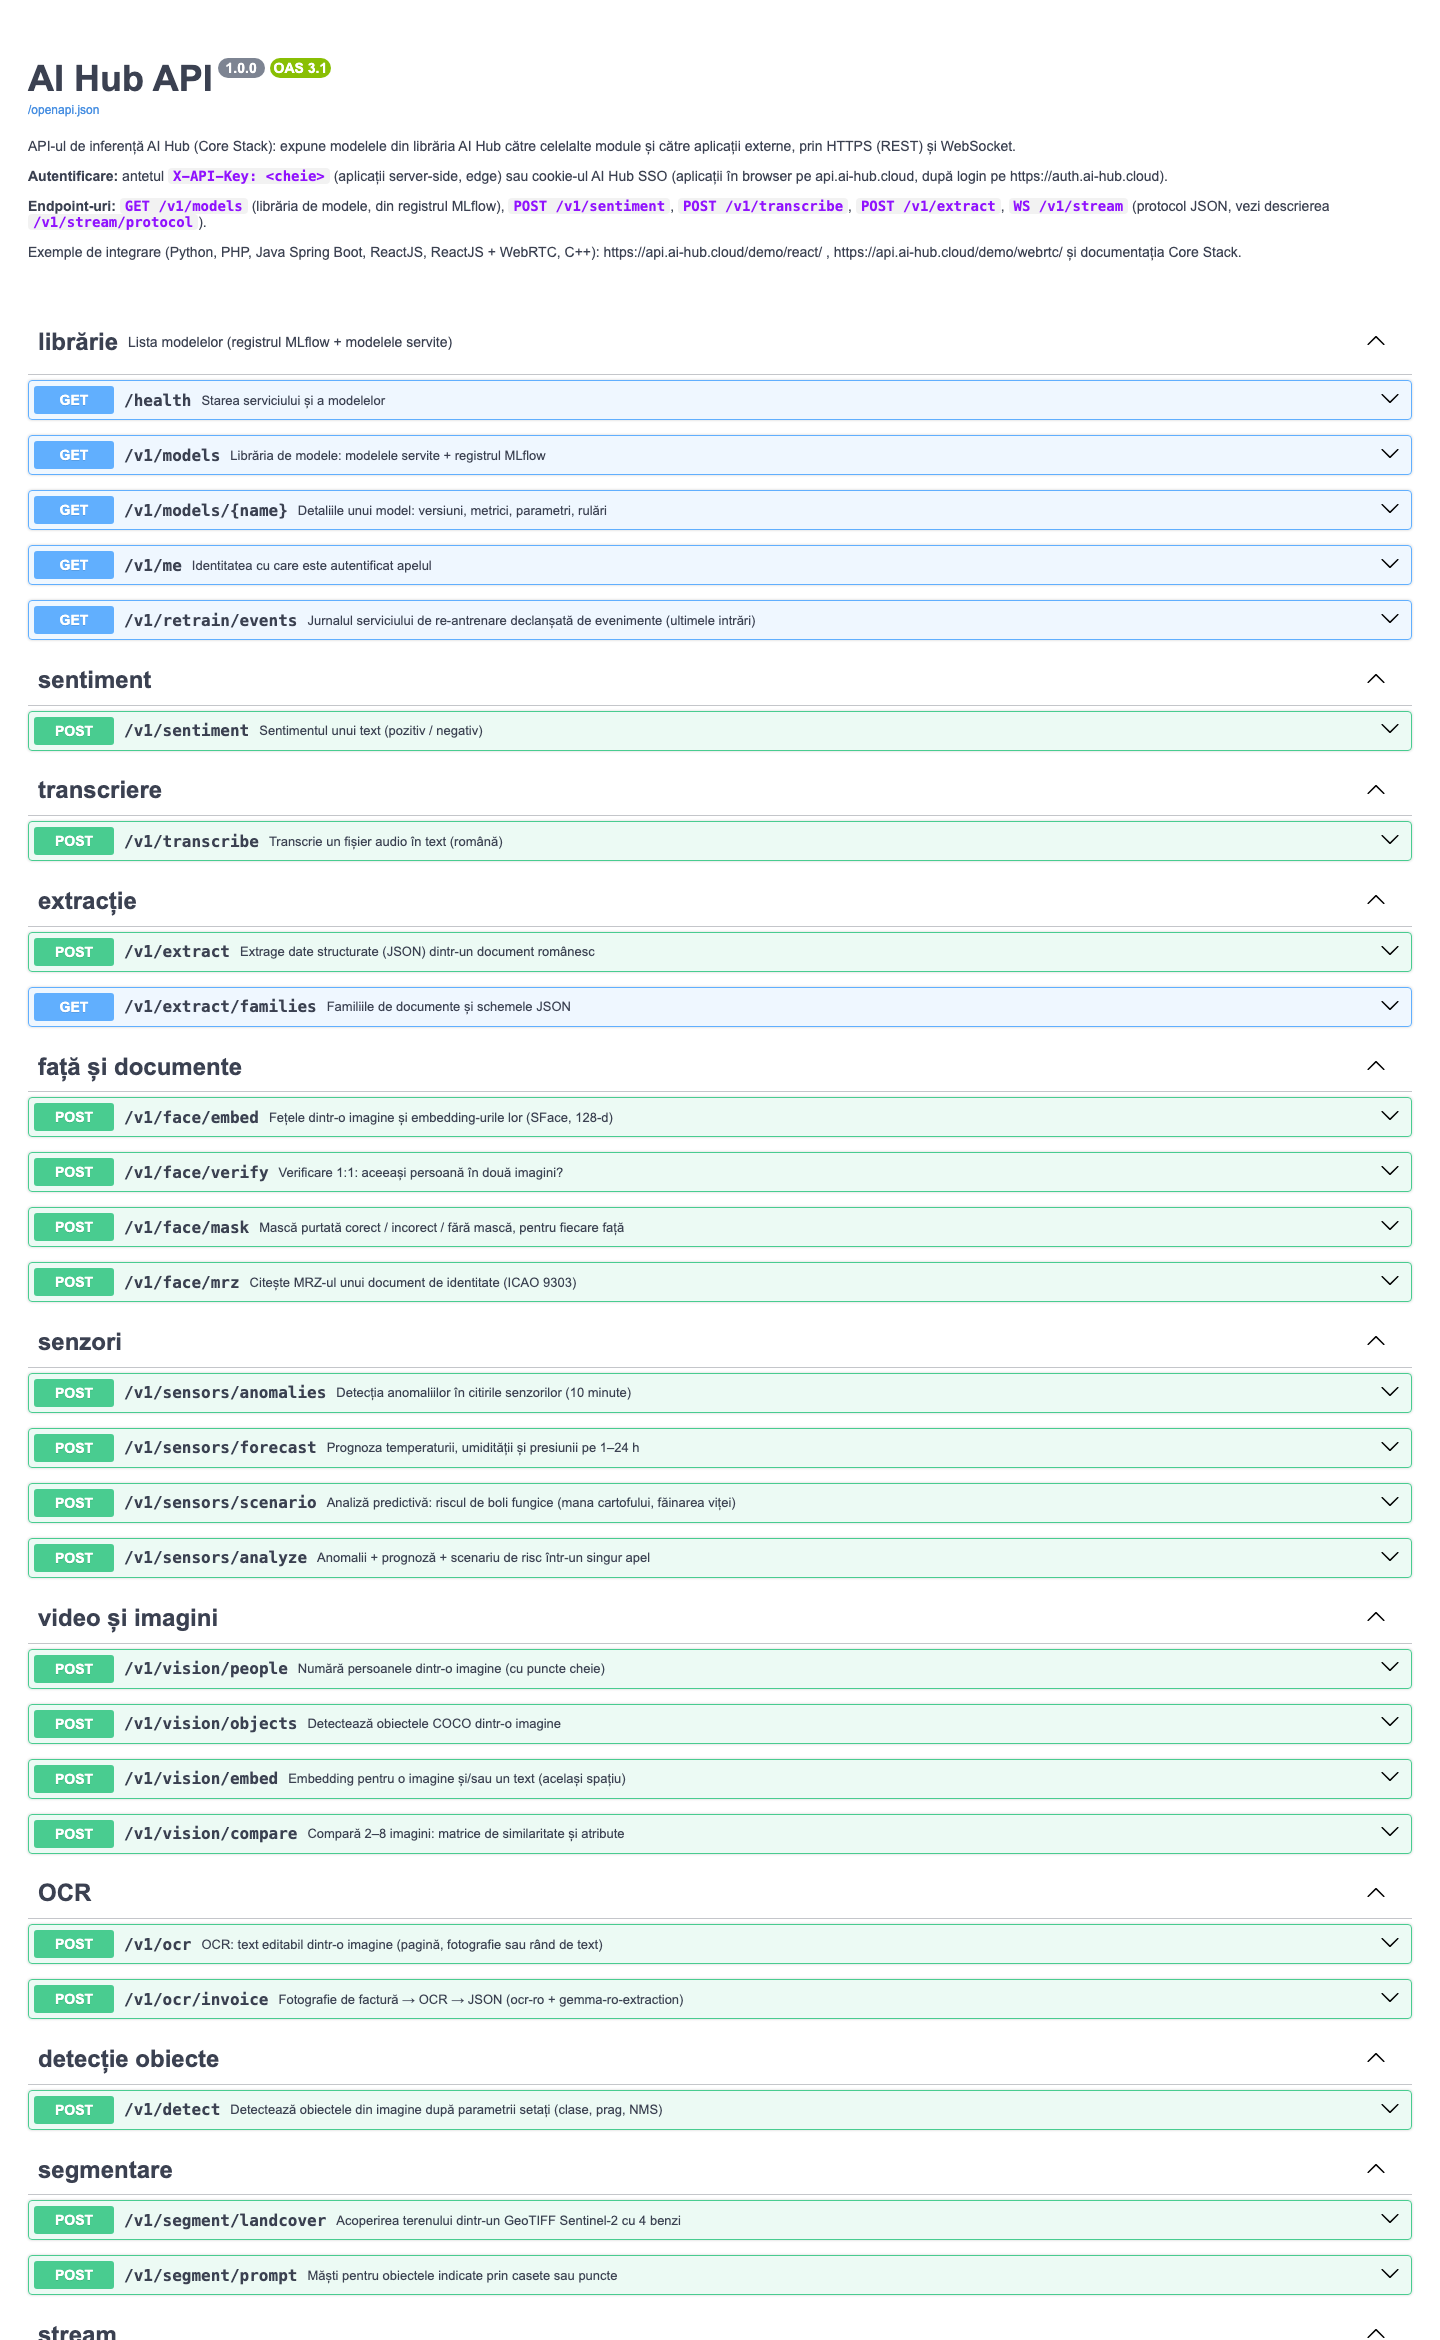
API-ul de inferență
| Metodă și cale | Descriere |
|---|---|
GET /health |
starea serviciului, a modelelor și memoria GPU |
GET /docs, GET /openapi.json |
documentația OpenAPI (Swagger UI) |
GET /v1/models, GET /v1/models/{nume} |
librăria de modele: modelele servite, versiunile din MLflow, metrici și parametri |
POST /v1/sentiment |
sentimentul unui text (română, engleză) |
POST /v1/transcribe |
transcriere audio în română (Whisper RO) |
POST /v1/extract, GET /v1/extract/families |
extracție JSON din documente românești (14 familii, inclusiv facturi) |
POST /v1/face/embed, /v1/face/verify, /v1/face/mask, /v1/face/mrz |
față: embedding și verificare 1:1, mască, citire MRZ |
POST /v1/sensors/anomalies, /forecast, /scenario, /analyze |
senzori: anomalii, prognoză, scenariu de risc |
POST /v1/vision/people, /objects, /embed, /compare |
video: numărare persoane, detecție obiecte COCO, embedding imagine/text, comparare |
POST /v1/ocr, POST /v1/ocr/invoice |
OCR documente românești (pagină, poză, rând); poză de factură → OCR → JSON |
POST /v1/detect |
detecție de obiecte cu parametri setați: classes (engleză sau română), score_threshold, iou_threshold, max_detections |
POST /v1/segment/landcover |
acoperirea terenului dintr-un GeoTIFF Sentinel-2 (4 benzi), variant=mobile|gpu |
POST /v1/segment/prompt |
măști pentru obiectele indicate prin casete sau puncte (MobileSAM / SAM ViT-H), variant=mobile|gpu |
GET /v1/retrain/events |
jurnalul serviciului de re-antrenare declanșată de evenimente |
WS /v1/stream, GET /v1/stream/protocol |
streaming text și audio (protocol JSON, cadre PCM) |
Autentificare: aplicațiile server-side și edge trimit o cheie API în antetul X-API-Key; aplicațiile din browser
găzduite pe api.onprem.ai-hub.cloud folosesc sesiunea AI Hub SSO. Cheile se obțin de la administratorul platformei.
Limite: 120 cereri/min (ușoare) și 20 cereri/min (transcriere, extracție) per identitate; 3 sesiuni WebSocket
simultane; timeout 30 s / 240 s; fiecare model rulează un singur job GPU odată. Jurnal: o linie per cerere și per
sesiune WebSocket, cu identitatea ca amprentă (cheile nu se scriu în jurnal).
Protocolul WebSocket wss://api.onprem.ai-hub.cloud/v1/stream
| Client → server | Server → client |
|---|---|
| (la conectare) | ready cu capabilitățile (text, audio, extract) și limitele |
{"type":"text","text":"…"} |
sentiment (etichetă, scor) |
{"type":"extract","family":"facturi","text":"…"} |
extraction.started, apoi extraction cu JSON-ul |
audio.start + cadre binare PCM 16 biți (8–48 kHz) |
transcript parțial (la ~1,5 s) și final (la o pauză ≥ 0,7 s sau la 20 s) |
audio.end |
ultimul segment final, apoi audio.done |
Orice mesaj poate avea un câmp meta, întors neschimbat (util pentru dispozitive edge).
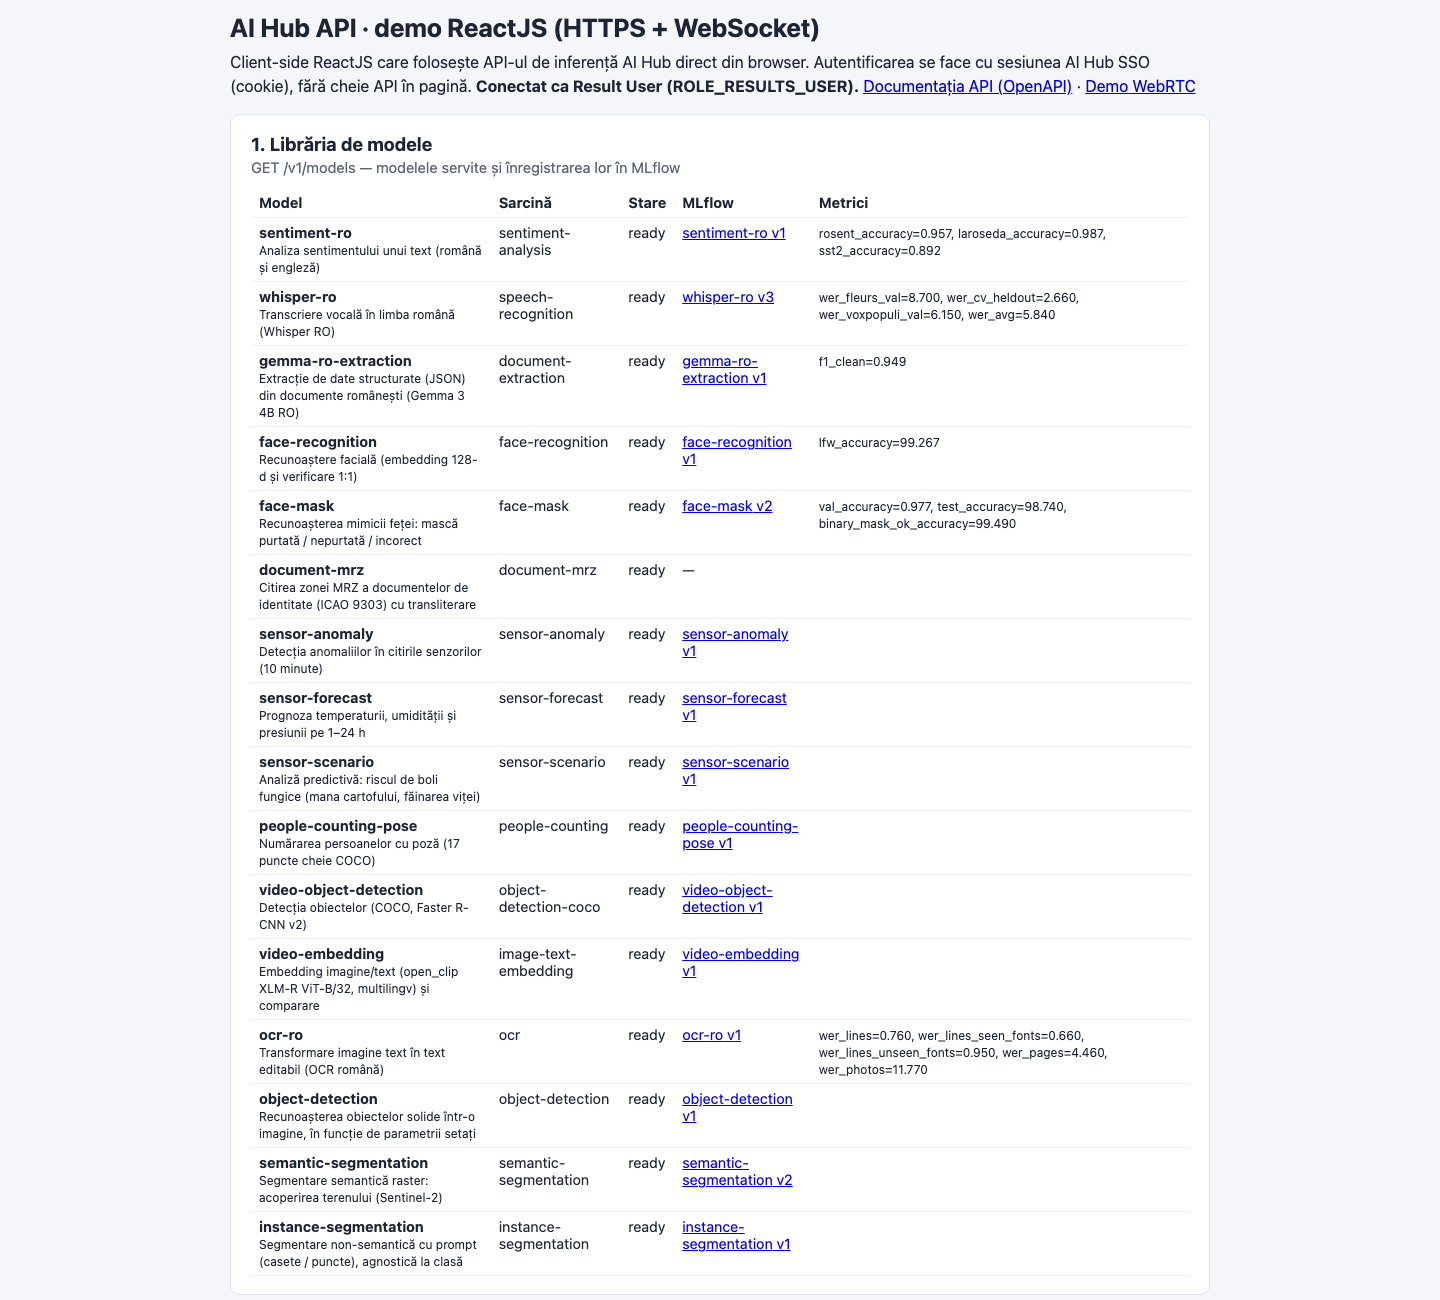
Librăria expusă prin API
GET /v1/models servește 16 modele, fiecare legat de versiunea lui din registrul MLflow, iar
secțiunea registry listează toate cele 55 de intrări ale registrului. Modelele noi se adaugă ca pluginuri (un modul
Python plus o intrare în models.yaml); un plugin care nu se încarcă nu oprește API-ul (/health raportează
degraded). Modelele celorlalte module (biometrie, senzori, video, vision) rulează neschimbate în predict workers, în
imaginea Docker a modulului lor (aceleași biblioteci ca la antrenare și evaluare), ascultând doar local; API-ul adaugă
autentificarea, limitele, jurnalul, documentația și legătura cu registrul.
| Model servit | Endpoint | Registru MLflow | Verificare live |
|---|---|---|---|
sentiment-ro |
/v1/sentiment, WS |
sentiment-ro v1 |
~17–55 ms per text |
whisper-ro |
/v1/transcribe, WS |
whisper-ro v3 |
RTF ≈ 0,05 |
gemma-ro-extraction |
/v1/extract, WS |
gemma-ro-extraction v1 |
~13 tokeni/s |
face-recognition |
/v1/face/embed, /v1/face/verify |
face-recognition v1 (SFace) |
aceeași persoană 0,807 → match; persoane diferite 0,305 → no match |
face-mask |
/v1/face/mask |
face-mask v2 |
imagine CC0 cu 5 fețe: 4 fără mască, 1 cu mască |
document-mrz |
/v1/face/mrz |
– (nu e un model antrenat) | specimen Norvegia: cifre de control valide, „Østenbyen / Åsamund Specimen” |
sensor-anomaly, sensor-forecast, sensor-scenario |
/v1/sensors/* |
v1 | Braunschweig 04.06.2026 16:10: „Scădere bruscă: temperatură aer −6.4 °C în 60 min” |
people-counting-pose, video-object-detection, video-embedding |
/v1/vision/* |
v1 | 8 persoane, GPU 165 ms; 10 persoane, 13 mașini, 3 autobuze |
ocr-ro |
/v1/ocr, /v1/ocr/invoice |
ocr-ro v1 |
factură fotografiată: 33 de rânduri; JSON valid, 31/33 câmpuri corecte (F1 0,939), 39 s |
object-detection |
/v1/detect |
object-detection v1 (SSDlite, mobil) |
implicit 6 ceșcuțe + 5 căni; score_threshold=0.3 → 6 + 6; classes=Mug → doar 6 căni |
semantic-segmentation |
/v1/segment/landcover |
v1 (mobil) / v2 (GPU) | teren agricol 0,881 față de 0,882 în harta WorldCover; 0,6–0,8 s |
instance-segmentation |
/v1/segment/prompt |
v1 MobileSAM / v2 SAM ViT-H | 5 căni din /v1/detect → 5 măști: v1 0,25 s, v2 0,67 s |
Lista completă a modelelor este pe pagina Librărie Algoritmi.
Exemplele de integrare
Cazuri de utilizare: (A) sentimentul unui text, (B) transcrierea unui fișier audio, (C) extragerea datelor
unei facturi în JSON, plus (D) streaming live prin WebSocket. Toate au README în română și au fost rulate
contra https://api.onprem.ai-hub.cloud; ieșirile reale sunt păstrate lângă cod.
| # | Exemplu | Tehnologie / protocol | Cazuri | Cod |
|---|---|---|---|---|
| 1 | python/rest_client.py |
Python, HTTPS (httpx) | librărie, A, B, C | GitLab ai-hub-client-demo-python |
| 2 | python/stream_client.py |
Python, WebSocket | A + D (audio live) | idem |
| 3 | python/relay_server.py |
Python server-side HTTP + WebSocket (aiohttp), relay spre AI Hub | A, C, D | idem |
| 4 | php/rest.php |
PHP, HTTPS (Guzzle) | librărie, A, B, C | GitLab ai-hub-client-demo-php |
| 5 | php/stream.php |
PHP, WebSocket (Ratchet/Pawl) | A + D | idem |
| 6 | java/ – AiHubClient + DemoController |
Java Spring Boot, HTTPS (RestClient) + endpoint-uri server-side | librărie, A, B, C | GitLab ai-hub-demo-javaspring |
| 7 | java/ – AiHubStreamClient |
Java Spring Boot, WebSocket | A + D | idem |
| 8 | api.onprem.ai-hub.cloud/demo/react/ | ReactJS client-side, HTTPS + WebSocket, SSO | librărie, A, B, C, chat live | arhiva documentației (core-stack/react) |
| 9 | api.onprem.ai-hub.cloud/demo/webrtc/ | ReactJS client-side, WebRTC + WebSocket, SSO | B live de la microfon + A | arhiva documentației (core-stack/webrtc) |
| 10 | cpp/main.cpp |
C++17 edge, WebSocket (IXWebSocket, TLS) | A (evenimente) + D (audio) | GitLab ai-hub-demo-cplusplus |
Repo-urile GitLab sunt în gitlab.mountsoftware.ro/mountsoftware/ai-hub/.
Rezultate reale ale exemplelor
| Caz | Rezultat |
|---|---|
| Sentiment | „Servicii excelente, revin cu drag!” → pozitiv 0,995, ~17–55 ms per text |
| Transcriere | clip FLEURS de 12,6 s → text corect în 0,35–0,74 s (RTF 0,03–0,06) |
| Extracție factură | JSON valid, 971 de tokeni în 67–74 s; 71 din 72 de câmpuri corecte (F1 0,979) |
| Streaming audio | 26,6 s de audio → 4 segmente finale, transcriere parțială la ~1,5 s |
| Relay Python | doi clienți locali primesc evenimentele produse de mesajele clientului A |
| Edge C++ | 4/4 evenimente ale dispozitivului clasificate, RTT ping 1,3 ms, 4 segmente audio |
Java Spring Boot
Exemplele 6–7: Spring Boot 3.3, RestClient prin HTTPS și StandardWebSocketClient prin WSS, plus endpoint-uri
server-side proprii (/api/sentiment, /api/transcribe) care apelează AI Hub. Rulare:
mvn -q package -DskipTests; java -jar target/aihub-spring-demo-1.0.0.jar --aihub.demo=true.
Python
Exemplele 1–3: client REST, client WebSocket și un server relay aiohttp (HTTP + WebSocket) care preia cererile propriilor
clienți și le trimite la AI Hub. Rulare: pip install -r requirements.txt, apoi python rest_client.py models.
ReactJS: HTTPS + WebSocket
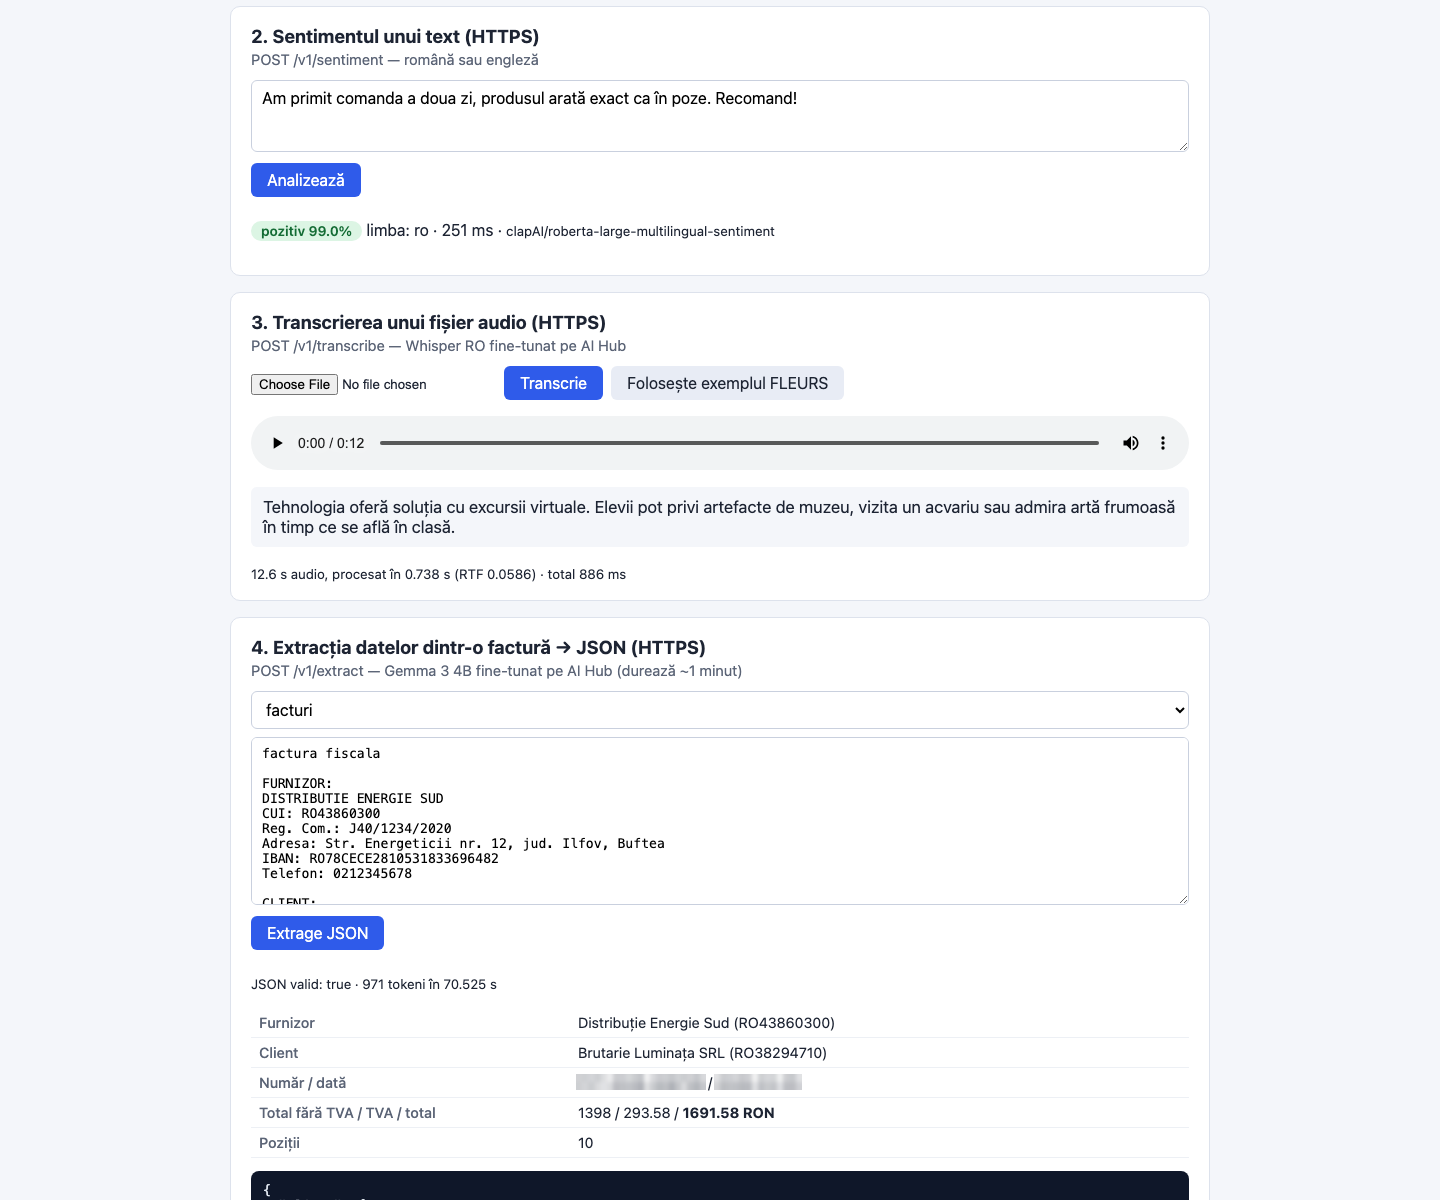
Exemplul 8 rulează în browser, cu sesiunea AI Hub (fără cheie în pagină), în 5 panouri: librăria, sentiment, transcriere, extracție factură, chat live prin WebSocket.
ReactJS: WebSocket + WebRTC
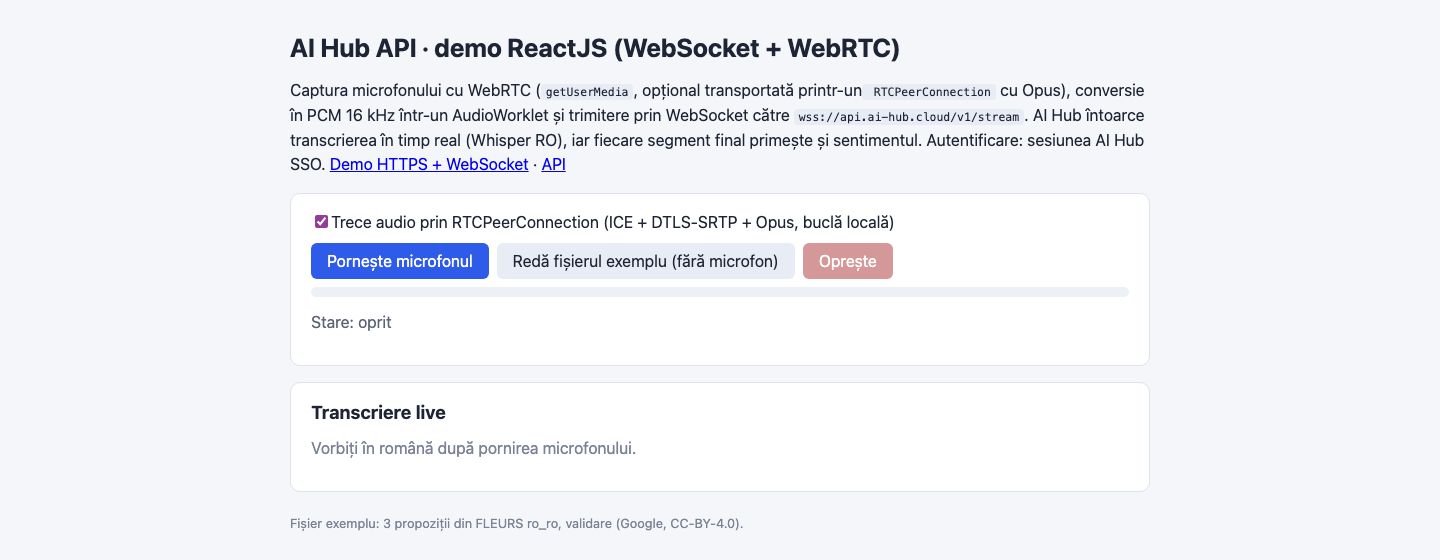
Exemplul 9: getUserMedia (procesarea audio WebRTC) → RTCPeerConnection cu Opus (buclă locală, opțional) →
AudioWorklet (PCM 16 kHz) → WebSocket → transcriere live; fiecare segment final primește și sentimentul.
C++ on-the-edge
Exemplul 10: client IXWebSocket (TLS) care trimite evenimentele dispozitivului (texte de la senzori și camere) și audio
prin WebSocket și primește rezultatele, cu câmpul meta pentru identificarea dispozitivului. Rulare:
cmake -S . -B build && cmake --build build, apoi ./build/aihub_edge_client events.txt <audio.wav> edge-gateway-01.
Cum se demonstrează
Cum se demonstrează
- Orice rol: onprem.ai-hub.cloud → Instrumente → API AI Hub (documentația OpenAPI).
- api.onprem.ai-hub.cloud/demo/react/: librăria, apoi „Analizează”, „Folosește exemplul FLEURS” + „Transcrie” și „Extrage JSON” (~70 s).
- api.onprem.ai-hub.cloud/demo/webrtc/: „Pornește microfonul” și vorbiți în română, sau „Redă fișierul exemplu”.
- Exemplele server-side și edge: din arhiva de cod, cu o cheie API primită de la administrator.
Licențe
| Componentă | Licență |
|---|---|
| API: FastAPI, Uvicorn, httpx, PyTorch, SciPy, NumPy | BSD-3 |
| transformers, accelerate | Apache-2.0 |
| ffmpeg (program extern) | LGPL/GPL |
| Exemple: httpx, websockets, IXWebSocket (BSD-3); aiohttp, Spring Boot, Playwright (Apache-2.0); Guzzle, Ratchet/Pawl, ReactPHP, React, Vite, nlohmann/json (MIT) | permisive |
| Audio exemplu: 3 propoziții FLEURS ro_ro, split de validare | CC-BY-4.0, © Google (atribuire inclusă) |
| Factura exemplu | document sintetic AI Hub (setul de test sas-demo) |
Limitări
Limitări
- Extracția este lentă: ~13 tokeni/s pe A40; o factură cu 10 poziții durează ~70 s. Cererile de extracție sunt serializate (un job GPU odată).
- Extracția normalizează uneori numele (pe factura demo, „BRUTARIA LUMINATA SRL” a devenit „Brutarie Luminața SRL”, singura greșeală din 72 de câmpuri). Modelul a fost antrenat pe documente sintetice.
- Sentimentul este transfer multilingv (modelul nu a văzut date românești la antrenare); propozițiile neutre factuale sunt adesea clasificate pozitiv.
- Streaming audio: parțialele primei secunde pot conține halucinații Whisper, corectate în segmentul final; segmentarea e pe energie (nu VAD neural); doar româna.
- WebRTC: este folosit pentru captură și, opțional, pentru transportul Opus printr-o buclă locală; transportul spre AI Hub este WebSocket (nu există server WebRTC/SFU). Verificarea automată a folosit microfonul fals al Chromium alimentat cu fișierul FLEURS, nu un microfon real; transcrierea din browser e puțin mai slabă decât pe fișier.
- Securitate: cheile API sunt statice, fără rotație automată; limitele sunt în memoria procesului.
- Scalare: un singur GPU (A40) și un singur proces pentru API; fiecare predict worker execută un singur job odată.
- Modelele modulelor:
face-recognitionservește SFace (v1); ArcFace R100 (v2) nu este expus prin API.whisper-roservește v5 (re-antrenat din corecturile din Data Studio și aprobat de Result User în portal); v3 rămâne pe disc ca versiune anterioară. - OCR pe fotografii: CER ~20% pe facturi fotografiate (3% pe scanări); primul apel după pornire încarcă detectorul (30–60 s).
- Exemplele React/WebRTC nu au un repo GitLab dedicat (
ai-hub-react-sdknu există); sunt în arhiva documentației.