Data Augmentation – Tagging
Aplicația de augmentare și etichetare a datelor (C.4, componenta 1): AI Hub Data Studio, adaptoarele de format pe CPU și GPU, costul vectorial și calitatea augmentării, seturile găzduite la furnizori și anonimizarea GDPR la încărcare.
- Ce este
- Fluxul pe platformă
- Augmentare pe mai multe tipuri de ieșire
- Formate de date suportate
- Costul vectorial al augmentării |K
- Calitatea post-validare a augmentării |Q
- Adaptoare tensoriale de format pe CPU și GPU
- Seturi de date de la furnizori: server propriu, preț de trafic, traseu
- Anonimizare GDPR la încărcare și la import
- Cum se demonstrează
- Licențe și surse
Ce este
| Componentă | Unde | Cine o folosește |
|---|---|---|
| AI Hub Data Studio (fork Label Studio 1.7) | data-studio.onprem.ai-hub.cloud, din portal: Instrumente AI Hub → Data Studio sau butonul AI Hub Data Studio de pe un dataset | Data Augmentator, Training Operator, Project Admin, Data Supplier, ML Model Developer |
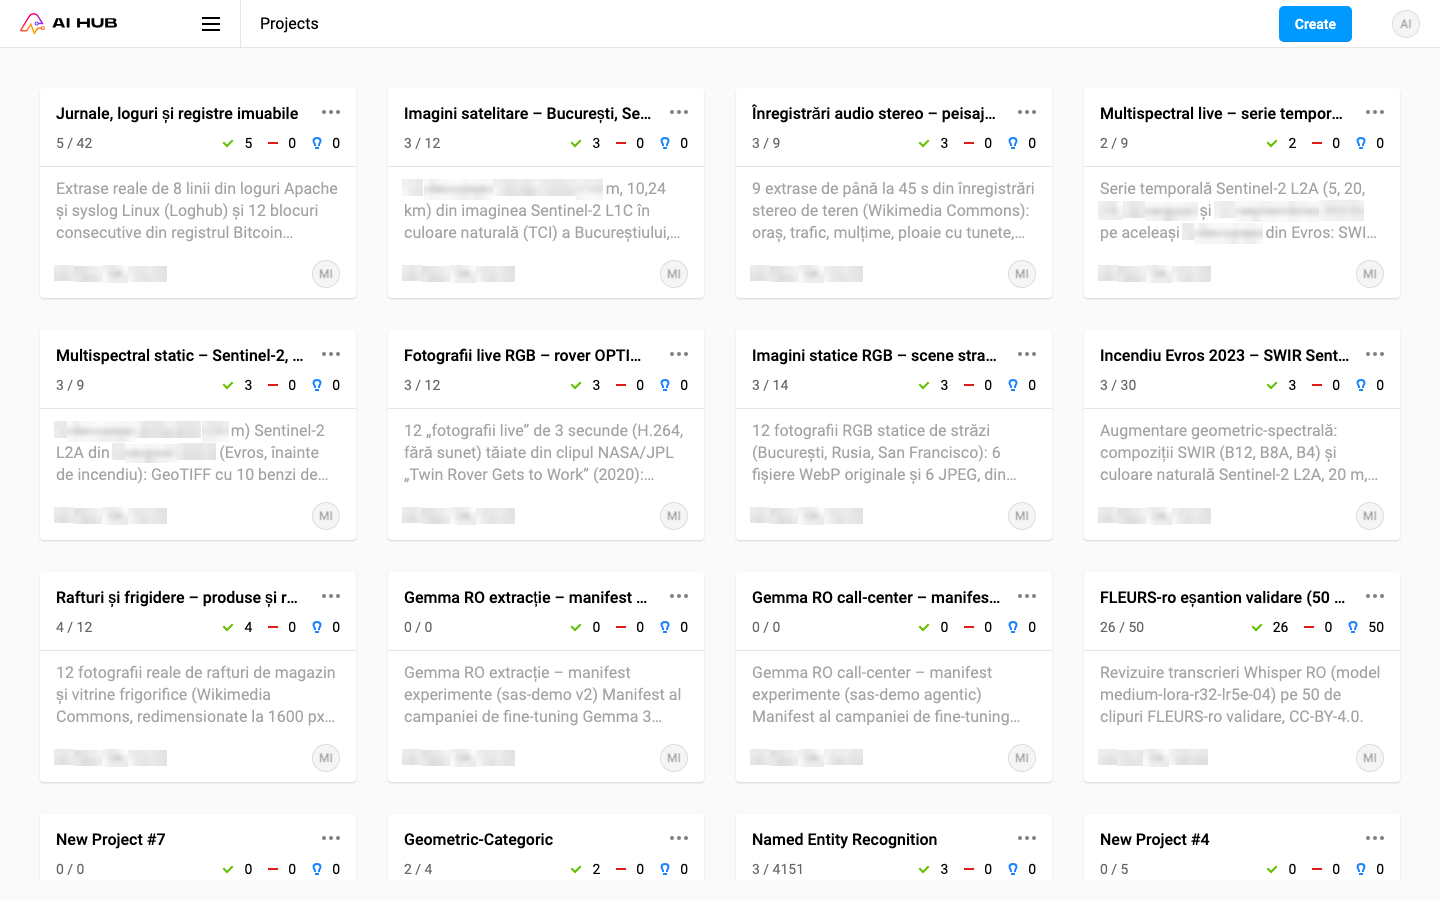
| 9 seturi de date reale, câte unul pe format C.4 | portal, Datasets / Marketplace; Data Studio, proiectele 203–211 | Data Supplier (5 seturi), Training Operator (4 seturi) |
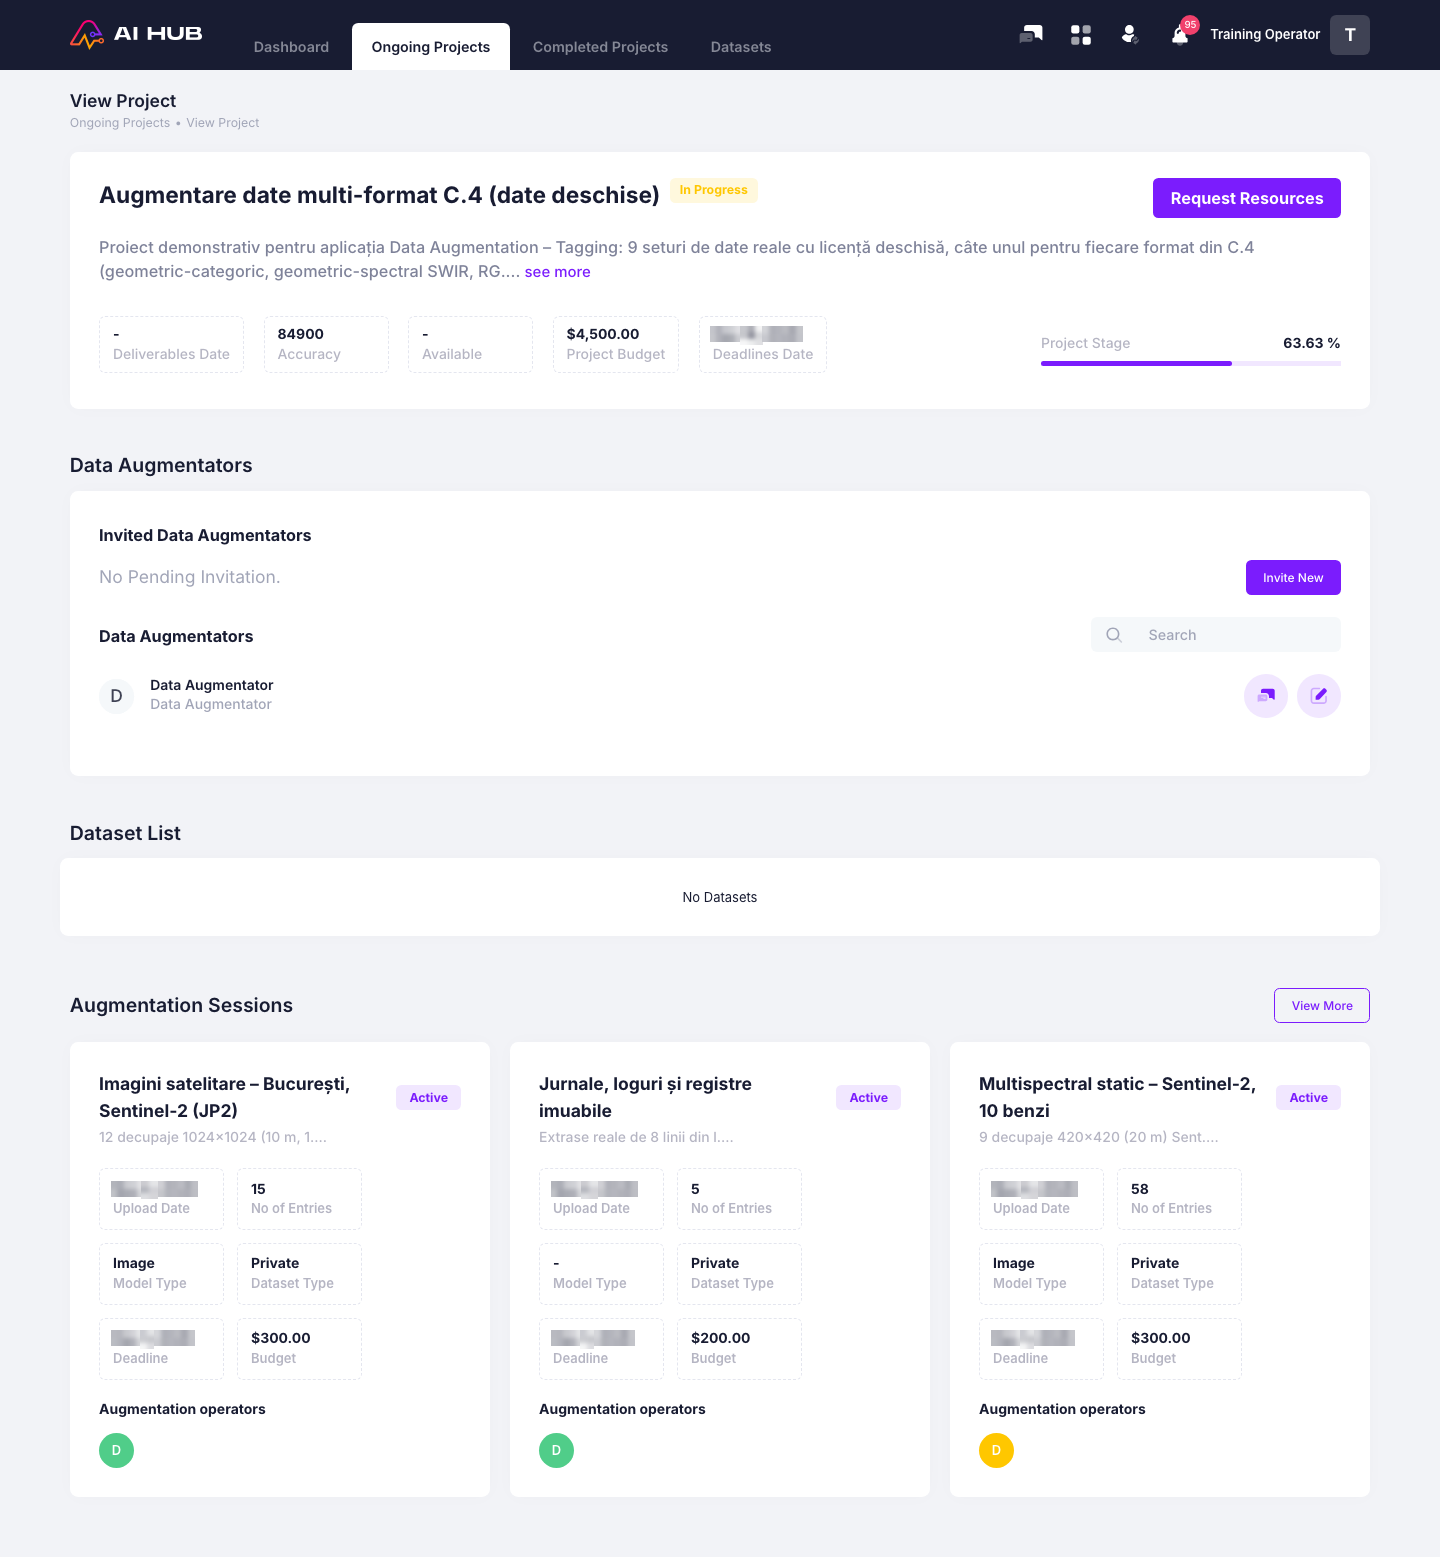
| Proiectul AI Hub „Augmentare date multi-format C.4 (date deschise)” | portal, My projects (Result User) / Ongoing Projects (Project Admin, Training Operator) | toate rolurile proiectului |
| Adaptoare de format CPU/GPU | pipeline ZenML format_adapters_pipeline, experimentul MLflow format_adapters_pipeline |
Training Operator, ML Model Developer |
| Adaptorul din calea de import în Data Studio | conversie WebP/HEIC → PNG (CPU), JPEG-2000 → PNG (GPU, nvJPEG2000), H.264 → cadre (GPU, NVDEC) | automat la pregătirea task-urilor |
| Rapoartele de cost |K și calitate |Q | BI (Metabase): dashboard-urile 1, 5 și 6, întrebările 11, 12, 15–22 | Project Admin, Training Operator, Support Specialist |
| Extensia „AI Hub dataset server”, traseul datelor | portal (Data Supplier), supplier-demo.onprem.ai-hub.cloud | Data Supplier |
| Anonimizarea GDPR la încărcare | pipeline ZenML gdpr_anonymization_pipeline, cron la 10 minute |
automat |
Data Studio afișează fiecărui utilizator doar proiectele de etichetare ale dataset-urilor din proiectele AI Hub în care este membru. Membrii se sincronizează automat din portal (la acceptarea invitației, la închirierea unui dataset și la cel mult 3 minute după, prin serviciul de autentificare unică).
Fluxul pe platformă
Seturile de date și proiectele de etichetare nu au fost create direct în Data Studio, ci pe fluxul platformei:
| Pas | Rol | Acțiune | Rezultat real |
|---|---|---|---|
| 1 | Data Supplier, Training Operator | încarcă arhivele din Data Set Form / Datasets | 9 seturi; backend-ul creează automat proiectele Data Studio 203–211 |
| 2 | Result User | creează proiectul „Augmentare date multi-format C.4 (date deschise)” și invită Project Admin și Training Operator | proiect cu buget 4.500 și termen stabilit |
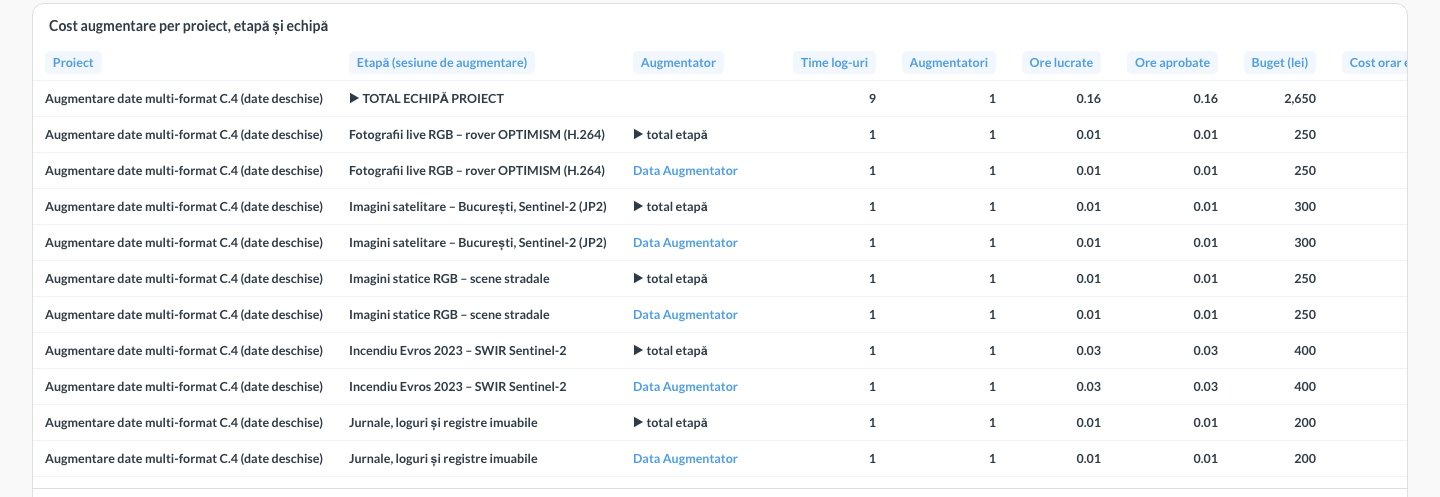
| 3 | Training Operator | invită Data Augmentator și cere 9 sesiuni de augmentare (câte una pe set, cu termen) | 9 sesiuni, bugete 200–400, total 2.650 |
| 4 | Project Admin | aprobă sesiunile din notificări | 9 sesiuni aprobate |
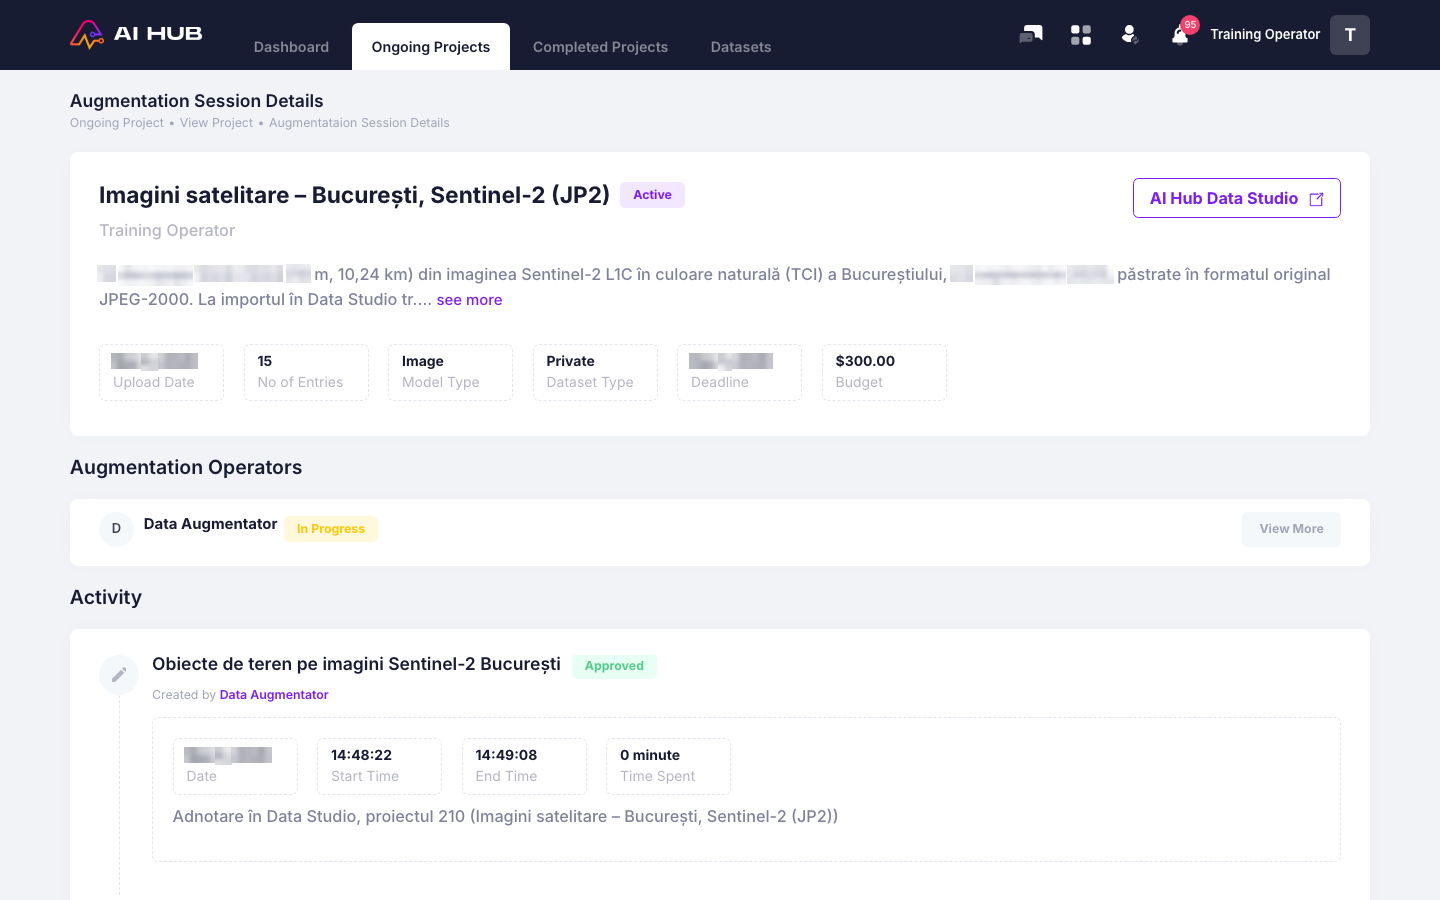
| 5 | Data Augmentator | acceptă cele 9 contracte, pornește time log-ul, adnotează în Data Studio, oprește time log-ul | 29 de adnotări, 9 time log-uri |
| 6 | Training Operator | aprobă activitatea (time log-urile) | 9 time log-uri aprobate |
Limitări
Adnotările demo au fost făcute de un agent AI care a jucat rolul de Data Augmentator, cu contul Data Augmentator. Timpii lor (8–40 s pe task, 9,4 minute în total) sunt mult mai mici decât ai unui om, deci costul orar efectiv și estimarea duratei de livrare din rapoarte sunt optimiste până la sesiuni umane reale. Adnotările audio s-au făcut pe spectrogramă și pe anvelopele stânga/dreapta, nu prin ascultare.
Augmentare pe mai multe tipuri de ieșire
Geometric-categorică: obiecte și relații
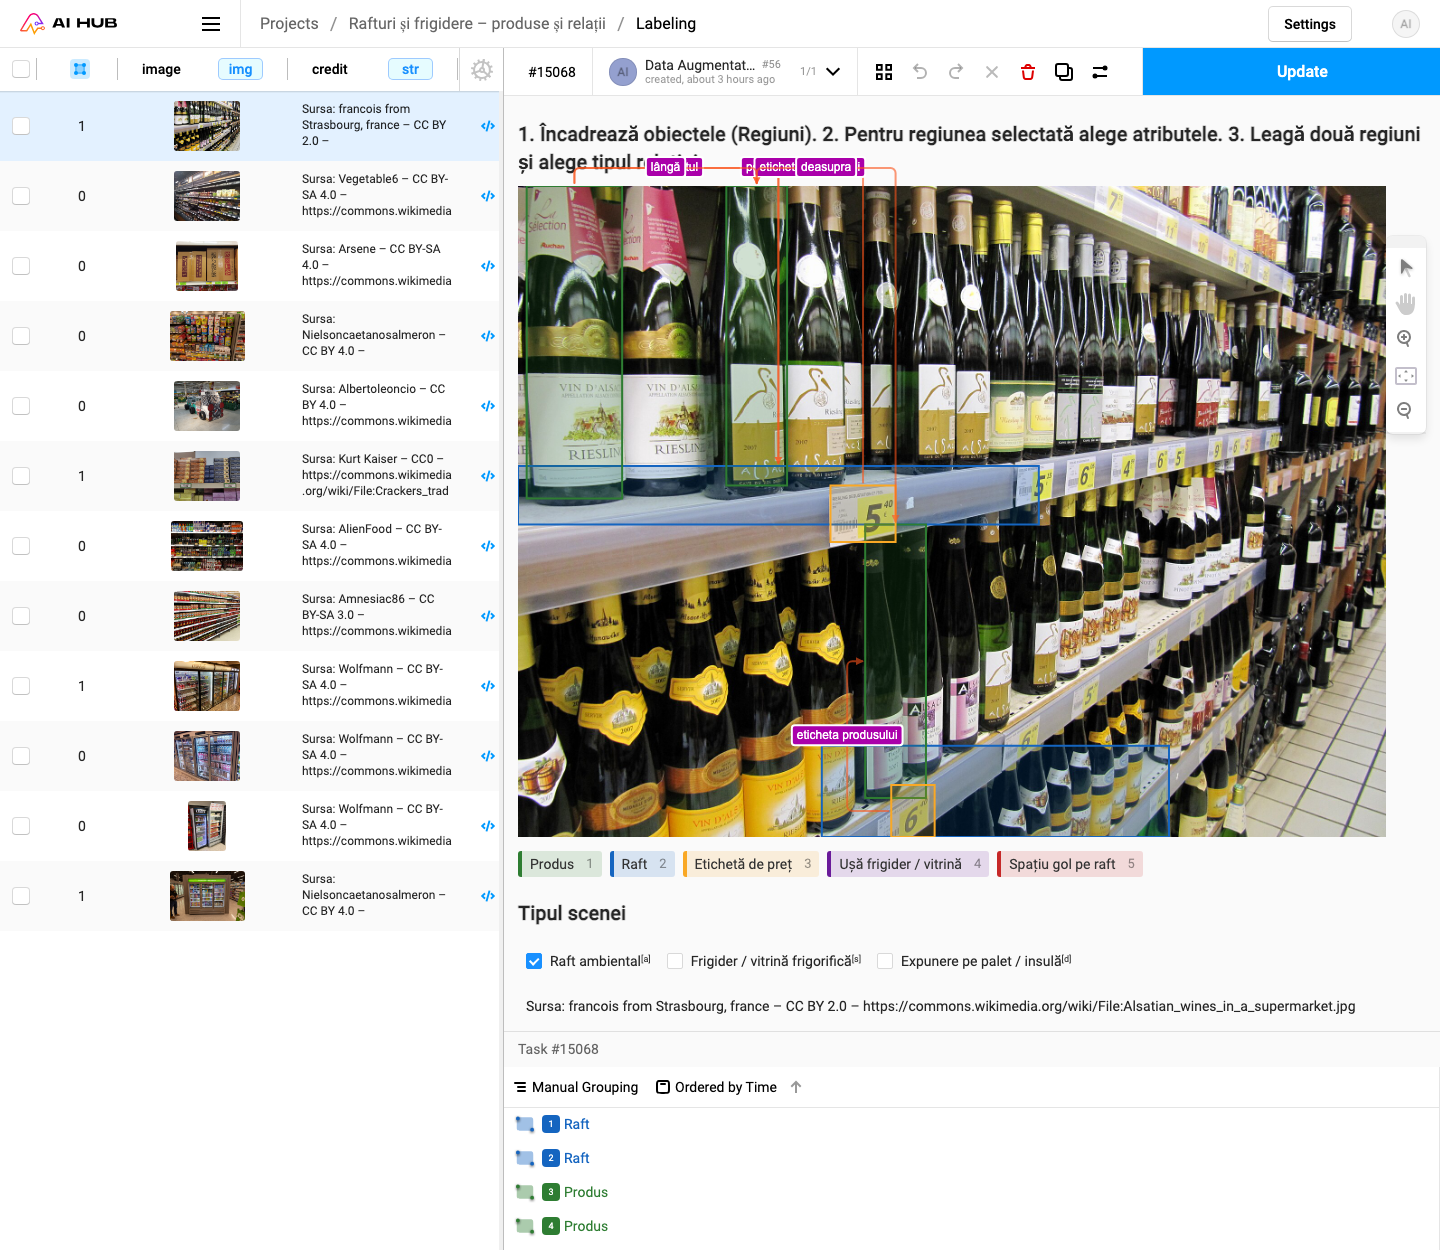
Proiectul Data Studio 203 „Rafturi și frigidere – produse și relații”: 12 fotografii reale de rafturi și vitrine frigorifice (Wikimedia Commons, licențe CC).
| Element | Valori |
|---|---|
| Regiuni (dreptunghiuri) | Produs, Raft, Etichetă de preț, Ușă frigider / vitrină, Spațiu gol pe raft |
| Atribute per regiune | stare (aliniat, dezordonat, promoție, necesită realimentare), categorie |
| Relații între regiuni | pe raftul, lângă, deasupra, eticheta produsului, în spatele |
| Clasificarea scenei | raft ambiental, frigider / vitrină frigorifică, expunere pe palet |
| Adnotare reală | 4 imagini: 32 de dreptunghiuri, 31 de relații, 37 de alegeri |
Geometric-spectrală: SWIR și NIR
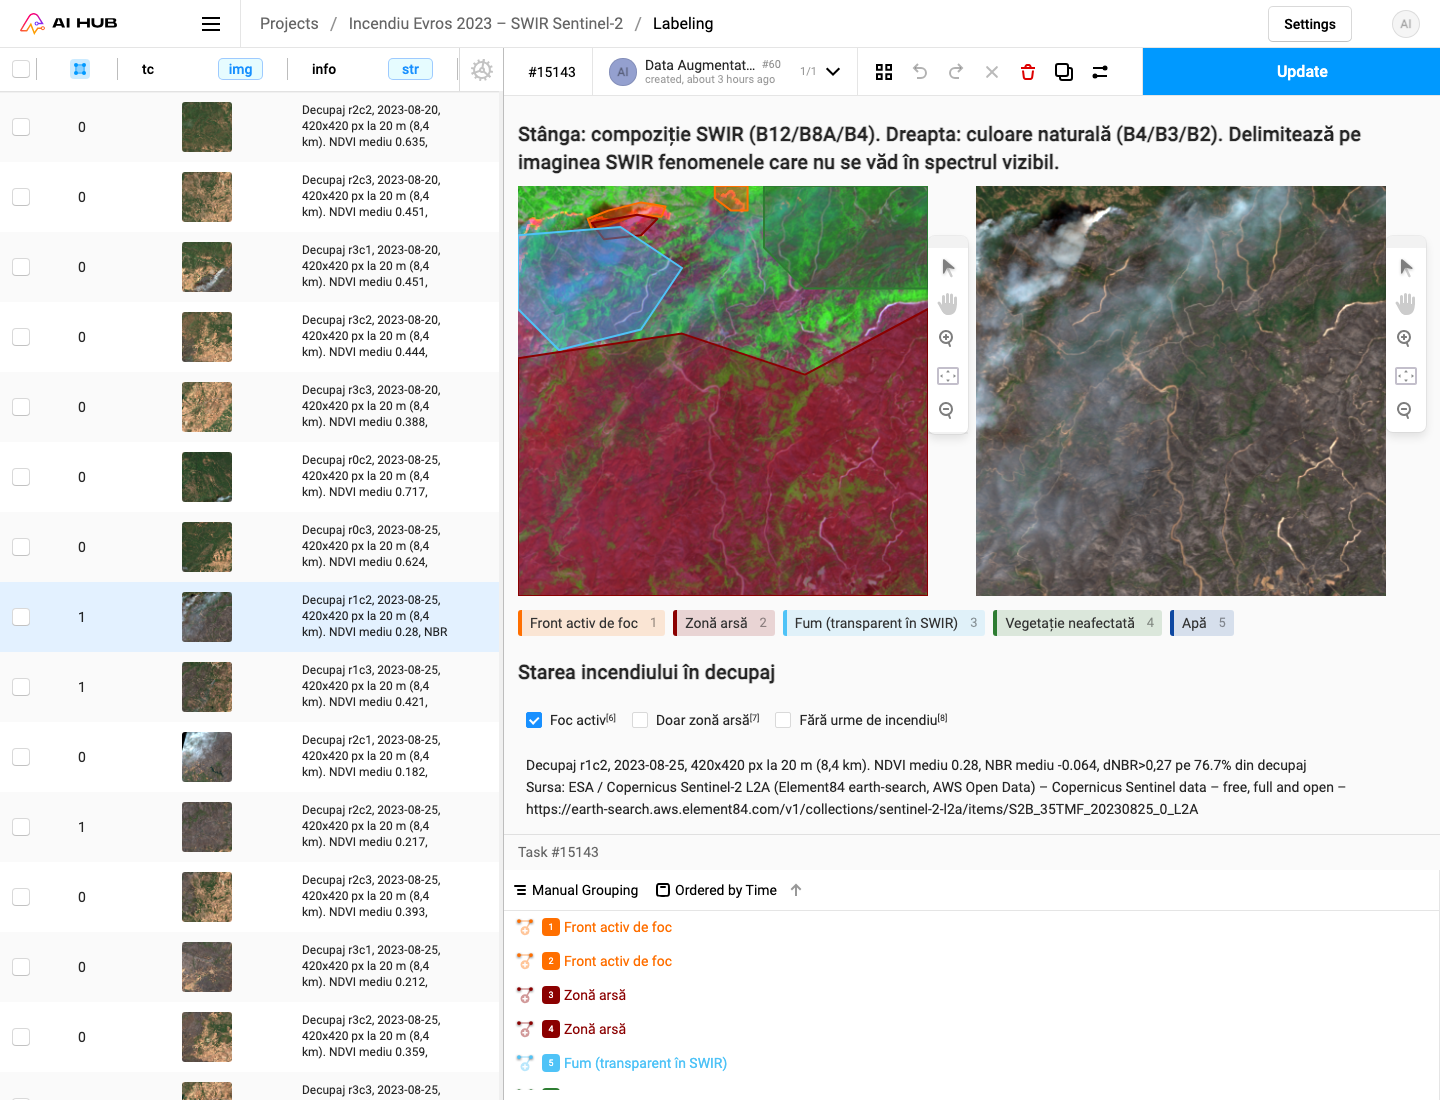
Proiectul 204 „Incendiu Evros 2023 – SWIR Sentinel-2”: 30 de task-uri (10 decupaje × 3 date: 20, 25 și 30 august 2023) peste incendiul Evros/Dadia. Adnotatorul vede compoziția SWIR (B12/B8A/B4) lângă culoarea naturală: frontul activ de foc, zona arsă și fumul (transparent în SWIR) apar doar în SWIR. Etichete poligonale: Front activ de foc, Zonă arsă, Fum, Vegetație neafectată, Apă, plus starea incendiului. Adnotare reală: 3 decupaje, 14 poligoane.
Formate de date suportate
| Format C.4 | Proiect Data Studio | Date reale | Task-uri | Adnotate |
|---|---|---|---|---|
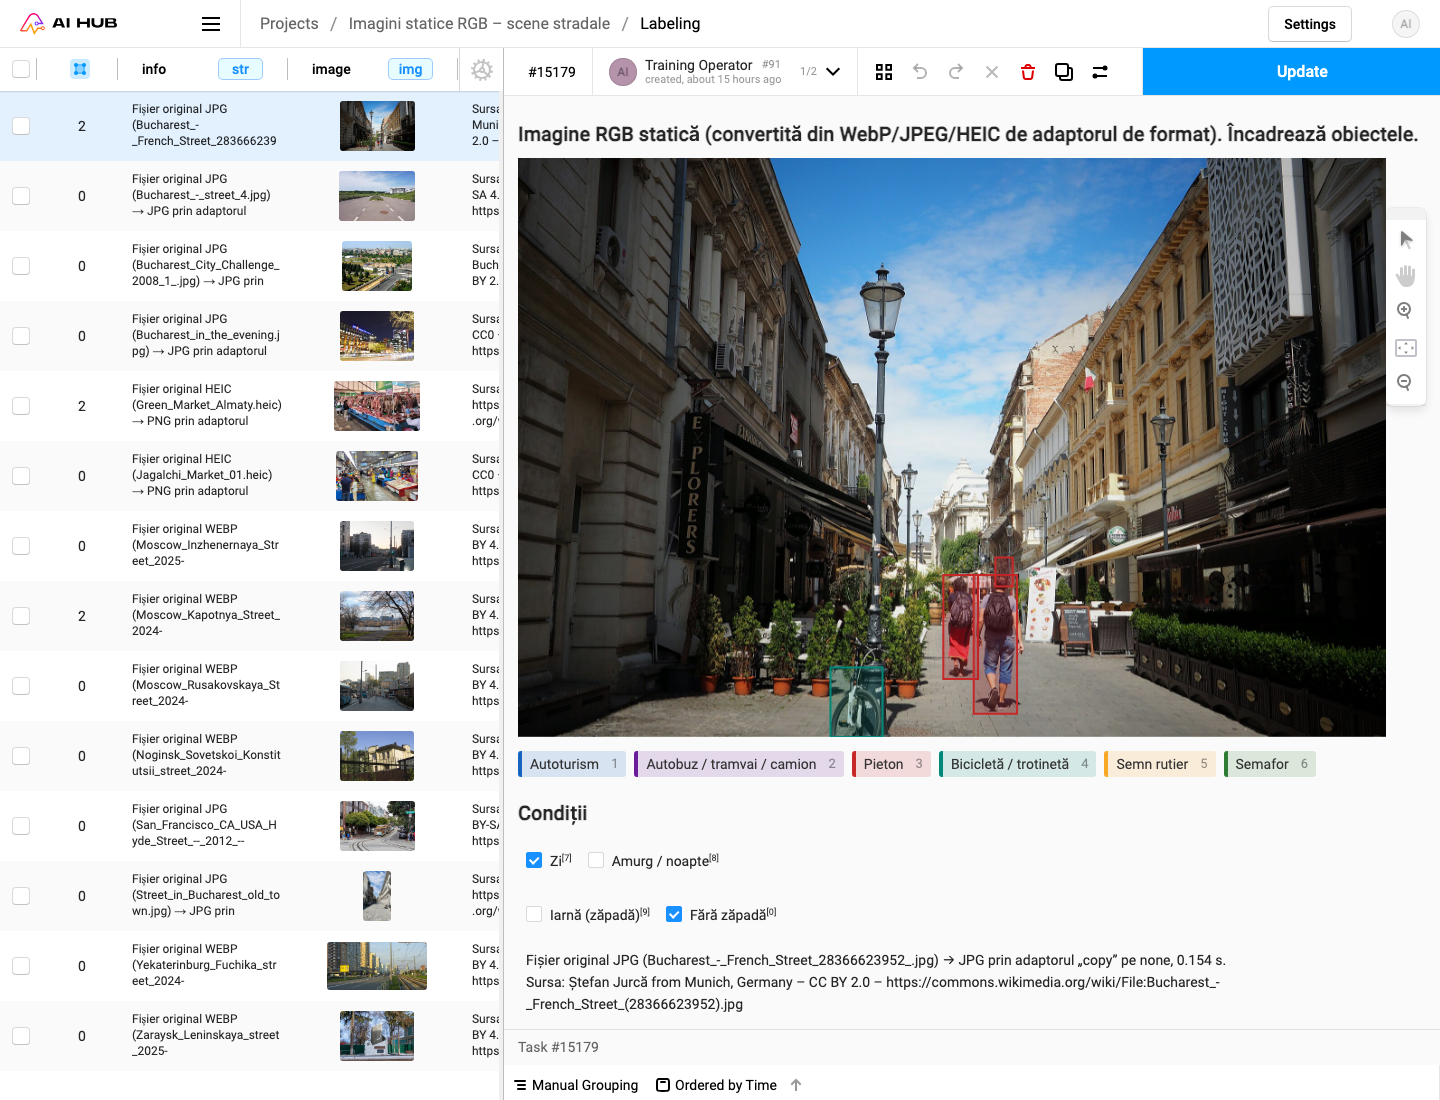
| Static 2D Images in RGB | 205 „Imagini statice RGB – scene stradale” | 14 fotografii: 6 WebP, 6 JPEG, 2 HEIC (WebP/HEIC trec prin adaptor) | 14 | 3 |
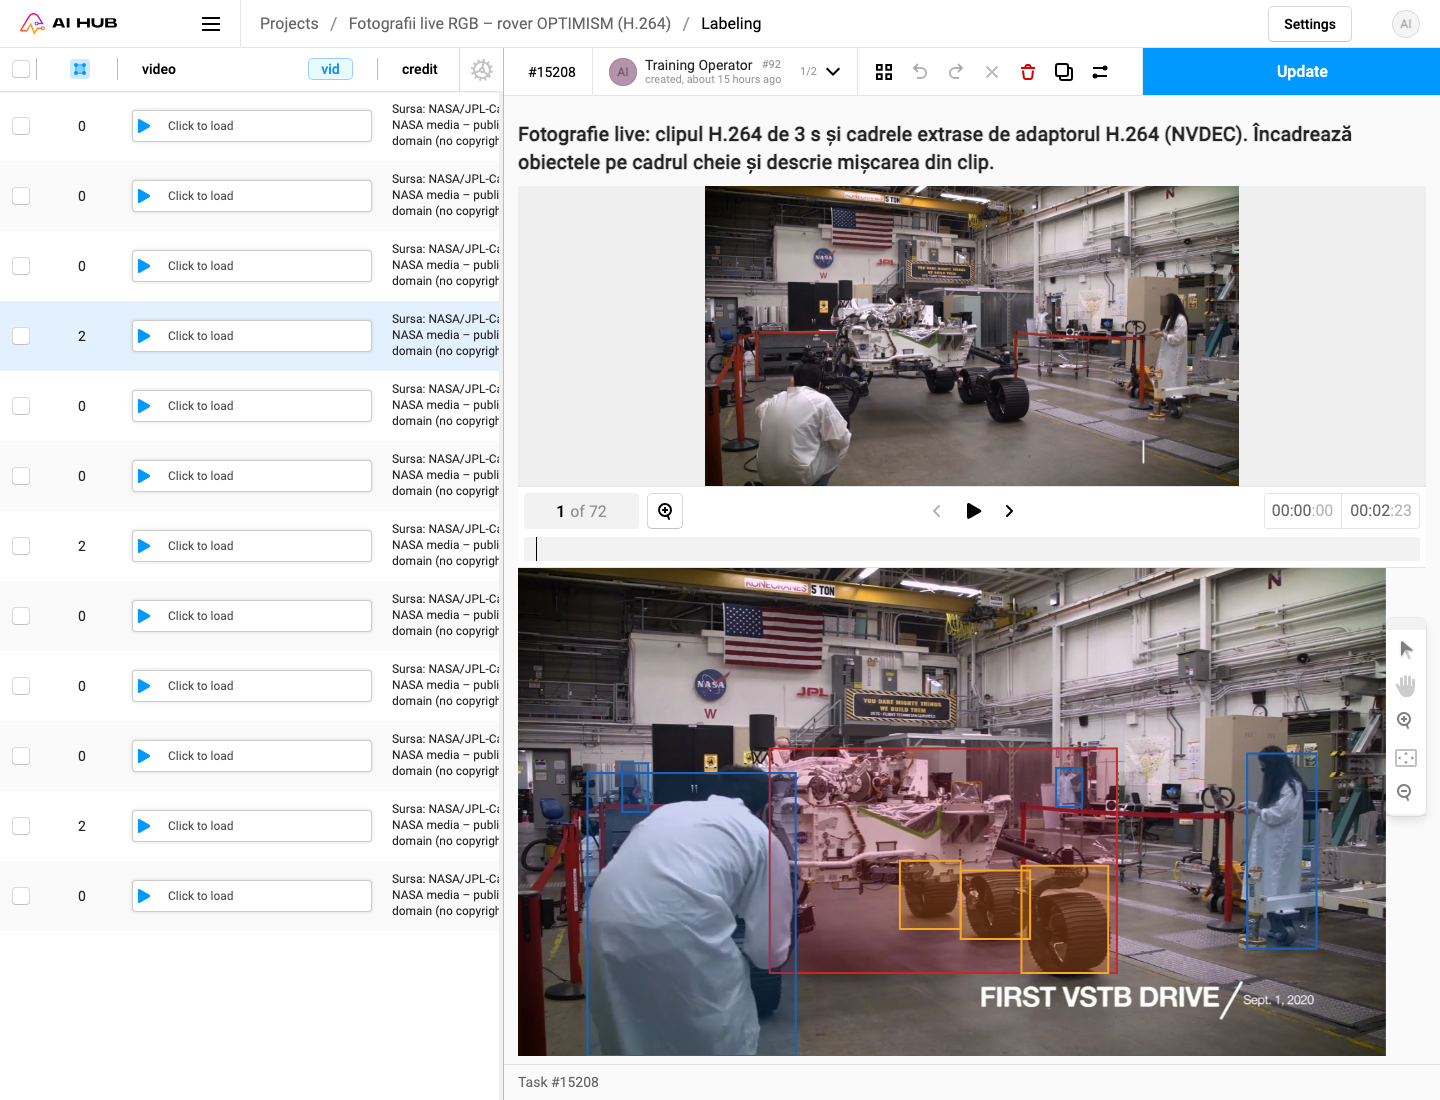
| Live 2D Photos in RGB | 206 „Fotografii live RGB – rover OPTIMISM (H.264)” | 12 clipuri H.264 de 3 s (NASA/JPL), cadre extrase cu NVDEC | 12 | 3 |
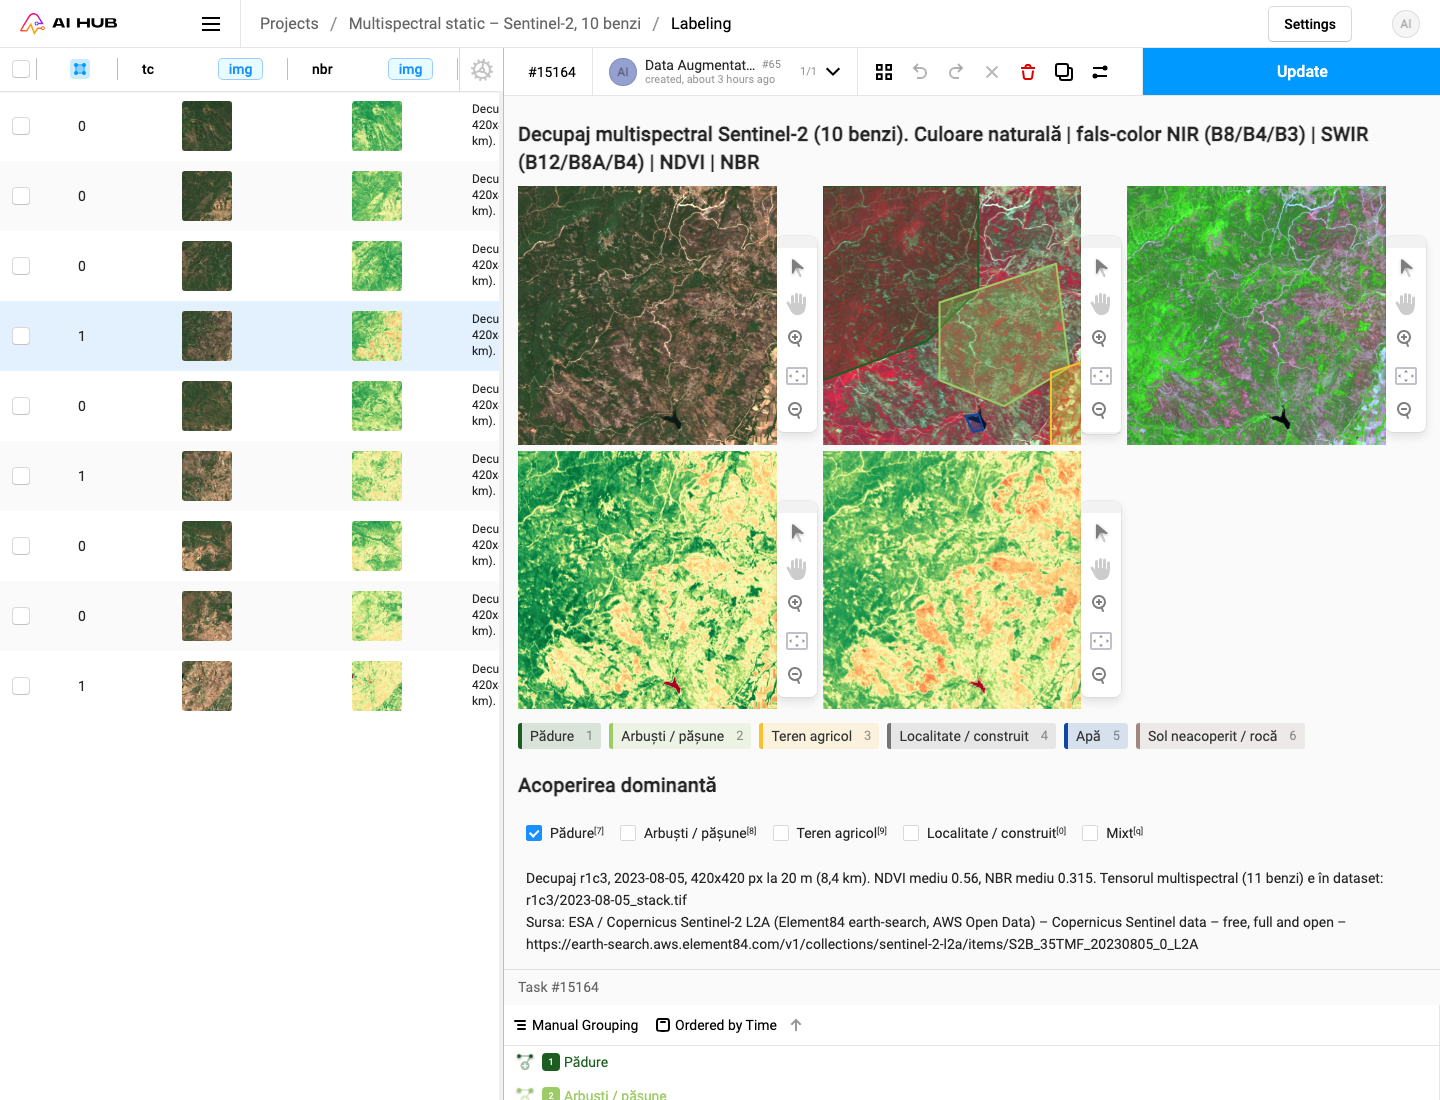
| Static 2D Image Multi-spectral | 207 „Multispectral static – Sentinel-2, 10 benzi” | 9 decupaje GeoTIFF cu 11 benzi + 5 compoziții (RGB, NIR, SWIR, NDVI, NBR) | 9 | 3 |
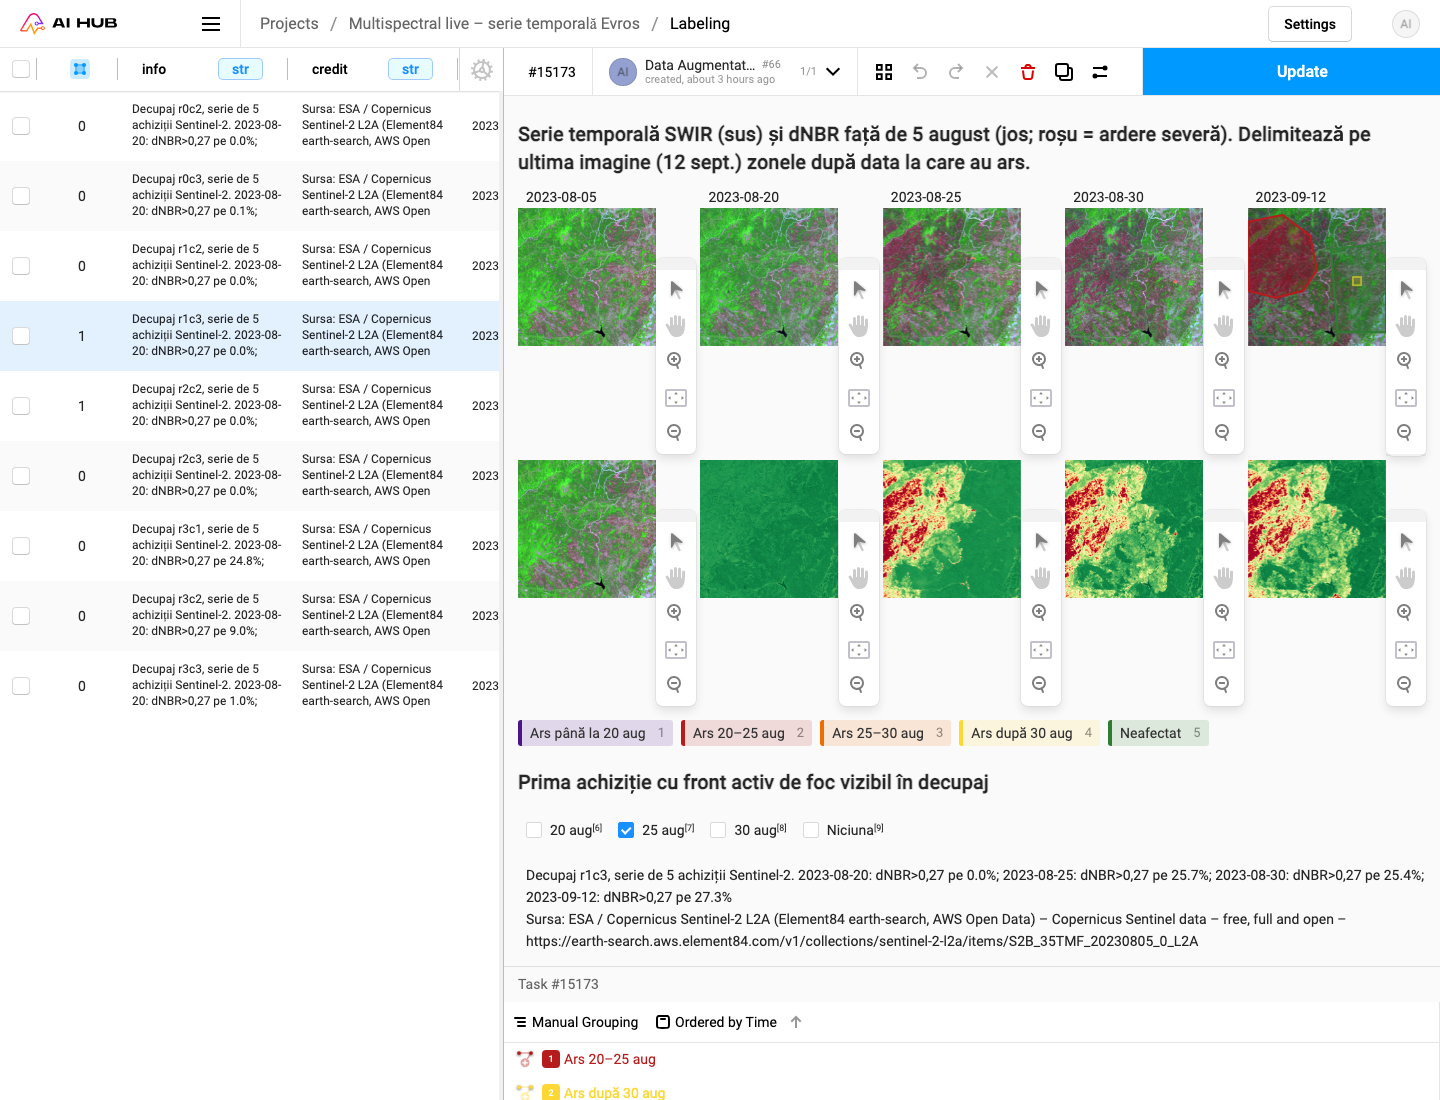
| Live 2D Multi-spectral Image | 208 „Multispectral live – serie temporală Evros” | 9 decupaje × 5 achiziții (5 aug – 12 sept 2023), SWIR + dNBR | 9 | 2 |
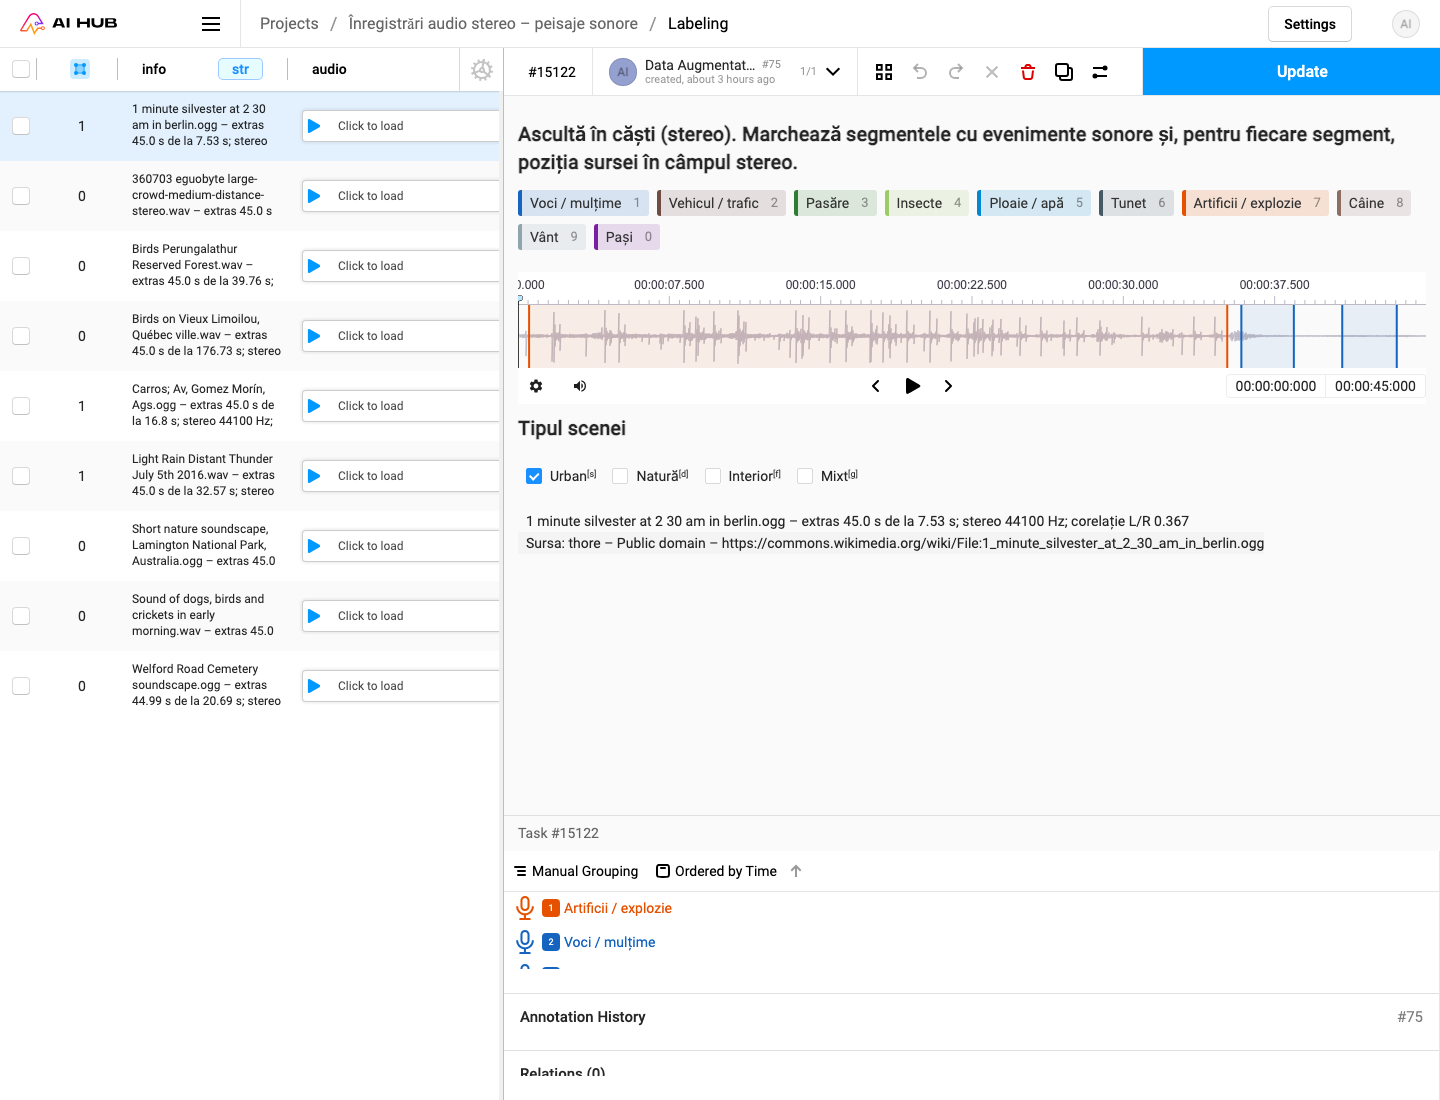
| Stereo Audio Recordings | 209 „Înregistrări audio stereo – peisaje sonore” | 9 extrase stereo verificate (canale diferite) | 9 | 3 |
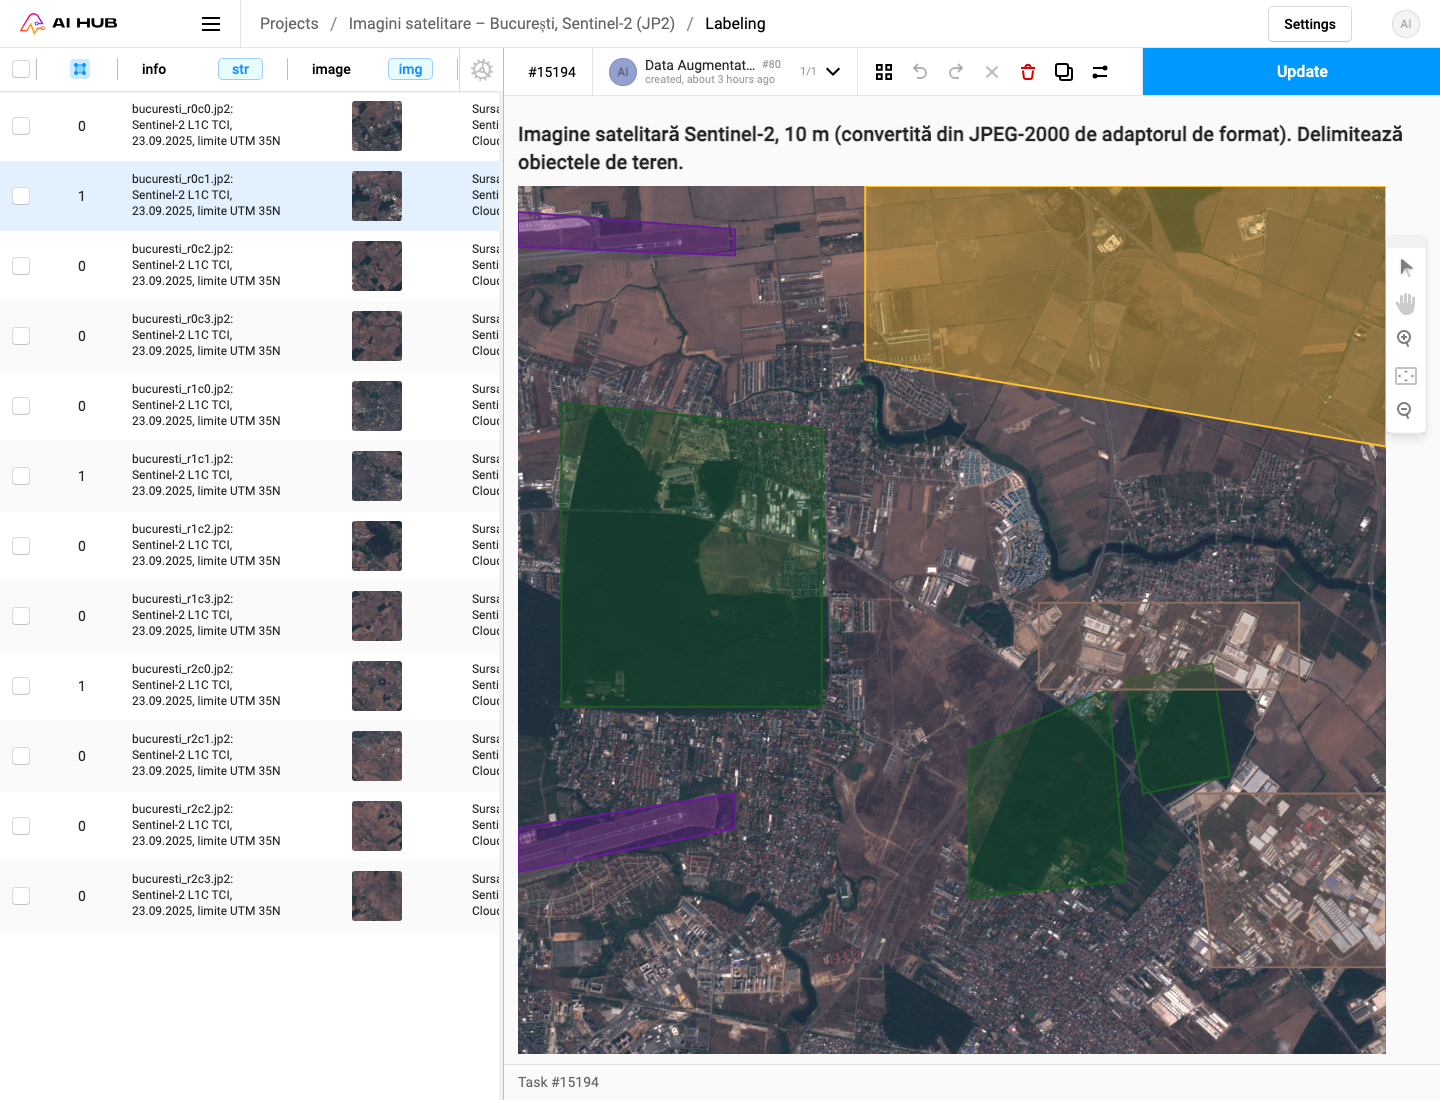
| Satellite Imagery | 210 „Imagini satelitare – București, Sentinel-2 (JP2)” | 12 decupaje 10 m din TCI JPEG-2000, import prin nvJPEG2000 | 12 | 3 |
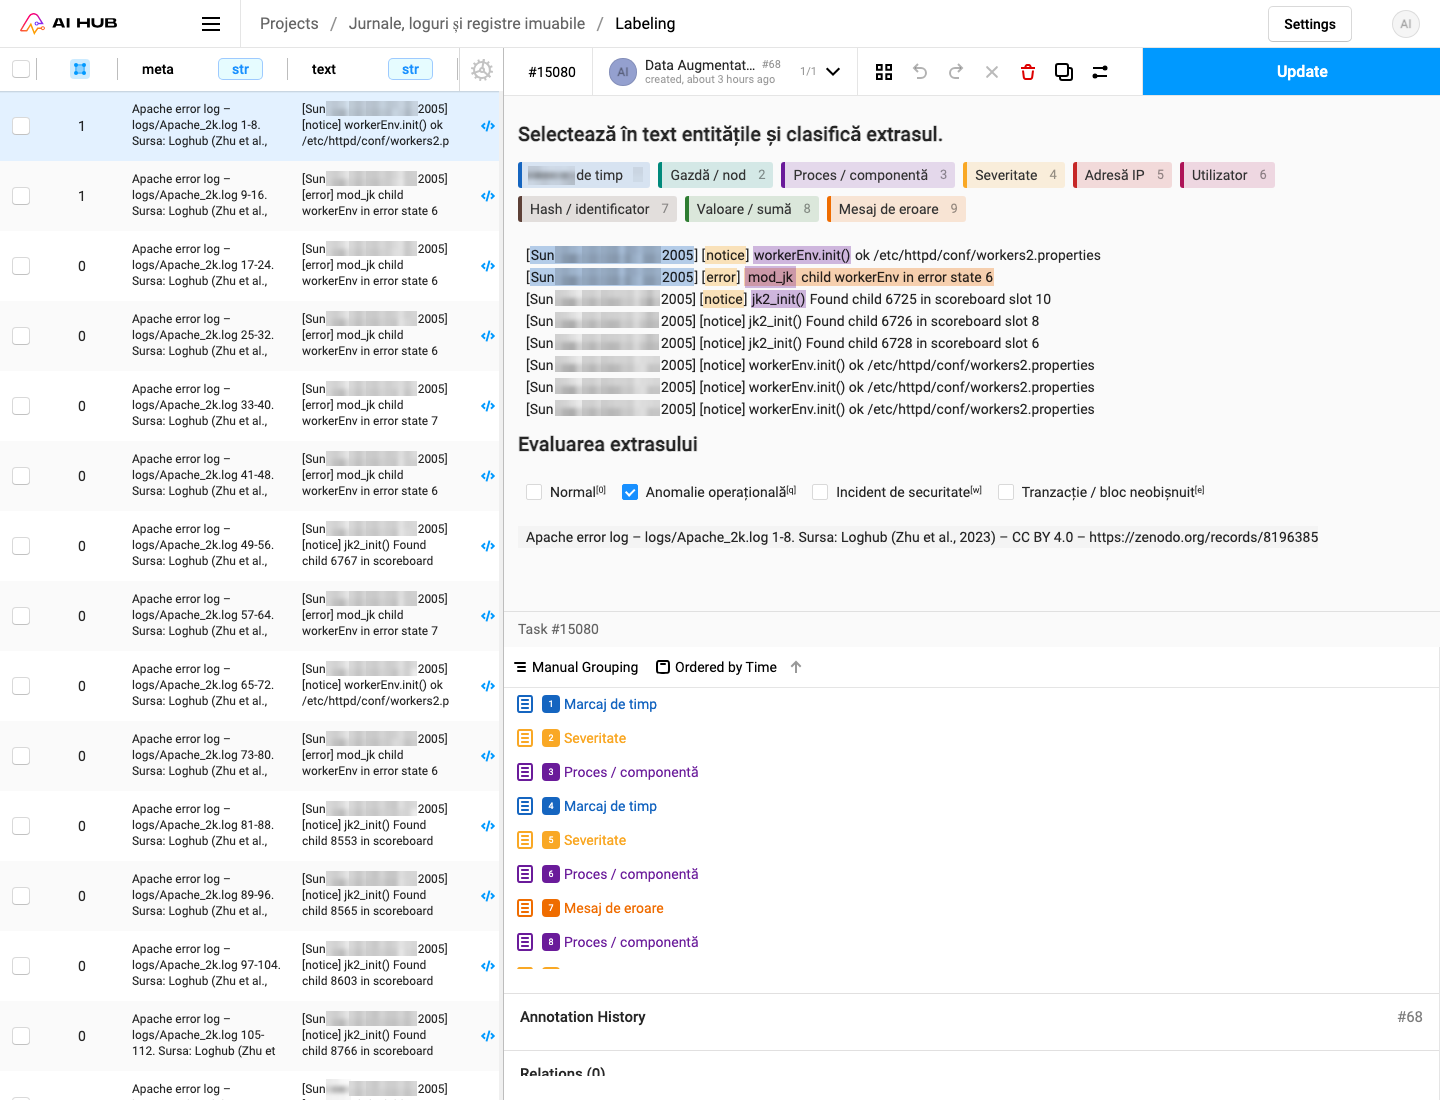
| Excerpts of Journals, Logs, Ledgers and Other Immutable Registers | 211 „Jurnale, loguri și registre imuabile” | 30 de extrase Apache/syslog (Loghub) + 12 blocuri Bitcoin | 42 | 5 |
Total: 9 proiecte (203–211), 149 de task-uri, 29 de adnotări. „Live” înseamnă: la fotografii, un clip scurt H.264 plus cadrele lui (ca o Live Photo); la multispectral, aceeași zonă în mai multe achiziții succesive.
Pre-procesarea multispectrală a rulat efectiv: citiri cu fereastră din COG-urile Sentinel-2 L2A, benzile de 10 m mediate la 20 m, GeoTIFF cu 11 benzi, compoziții cu intervale fixe de reflectanță și indicii NDVI, NBR, dNBR. Pe decupajul r2c2, 89% dintre pixeli au dNBR > 0,27 pe 25 august, față de 0% pe 20 august. S-a folosit GDAL/rasterio, nu Orfeo Toolbox (aceeași algebră de benzi).
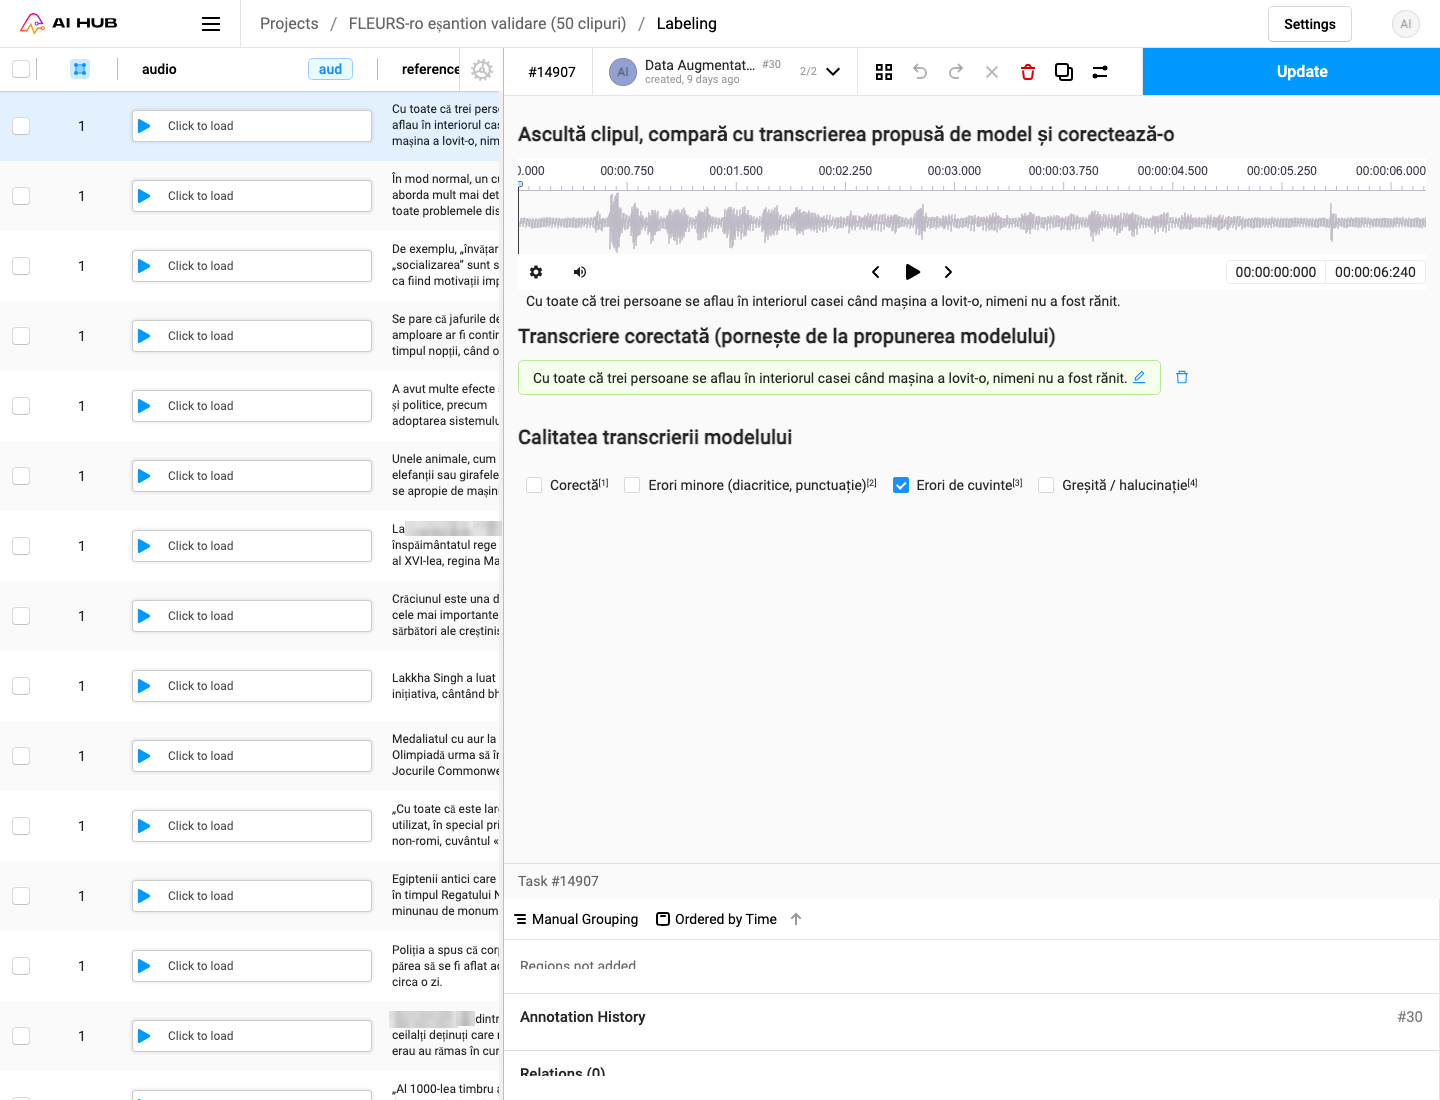
Proiectul 163 „FLEURS-ro eșantion validare (50 clipuri)” arată augmentarea asistată de model: fiecare task are clipul, transcrierea de referință și transcrierea propusă de modelul Whisper fine-tunat; 26 de task-uri sunt revizuite.
Costul vectorial al augmentării |K
| Raport (BI) | Ce arată | Adresă |
|---|---|---|
| Întrebarea 11 „Cost augmentare per proiect, etapă și echipă” | pe proiect (echipa = augmentatorii proiectului), pe etapă (sesiunea unui dataset) și pe augmentator: time log-uri, ore lucrate și aprobate, buget, cost orar efectiv | question/11 |
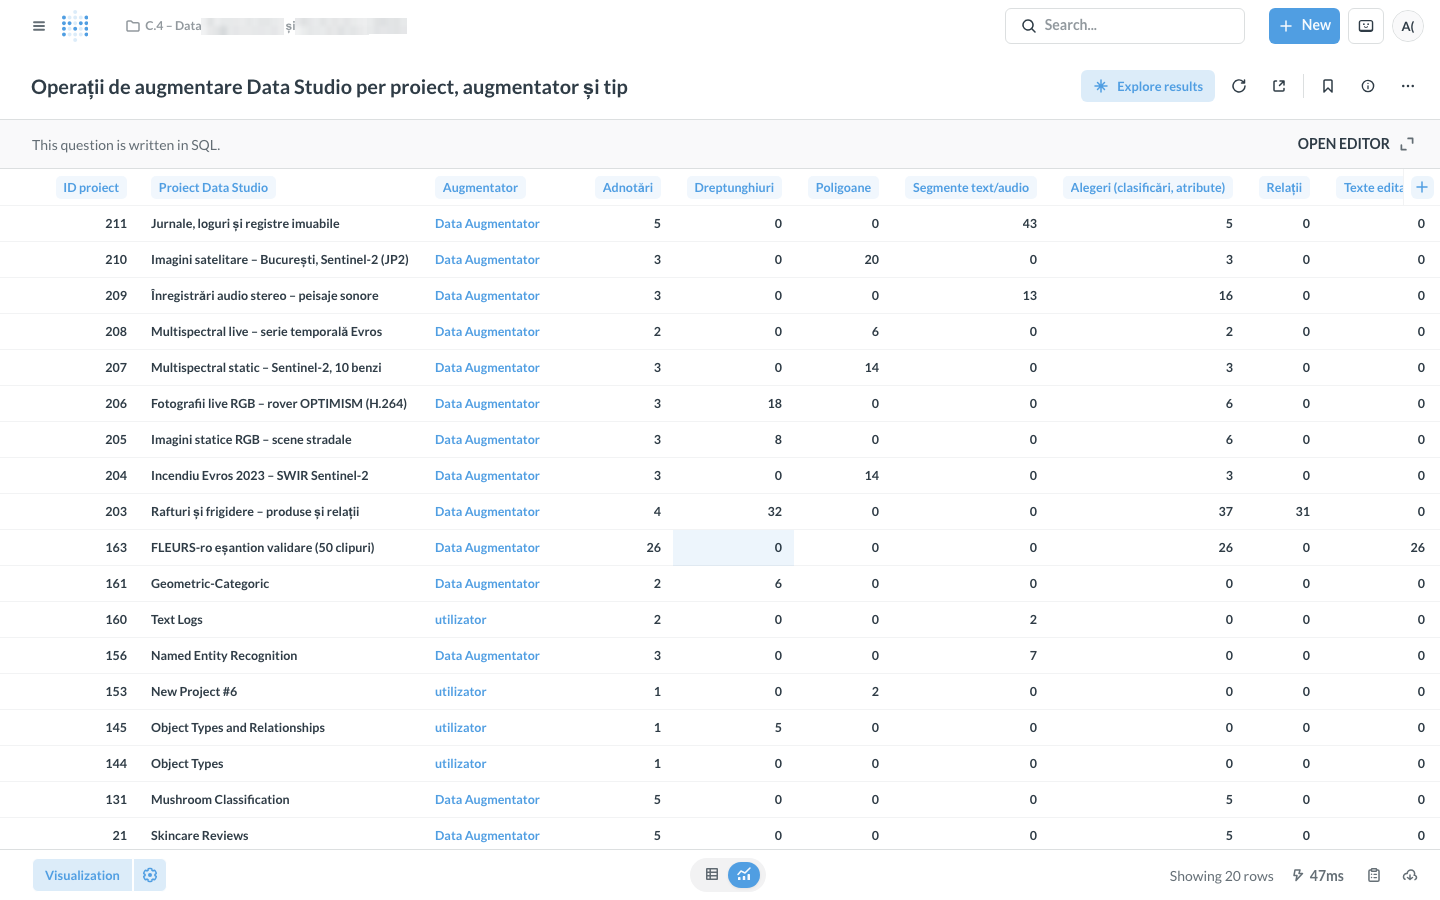
| Întrebarea 12 „Operații de augmentare Data Studio per proiect, augmentator și tip” | operații actuatoare (dreptunghiuri, poligoane, segmente, relații, texte) și perceptuale (clasificări și atribute), plus timpul de adnotare măsurat | question/12 |
| Întrebările 17–19 „Efort uman de augmentare” | efortul mecanic (clicuri, taste, trageri) și optic (timp activ), per task, per augmentator și proiect, loturile brute de telemetrie | dashboard-ul 6 |
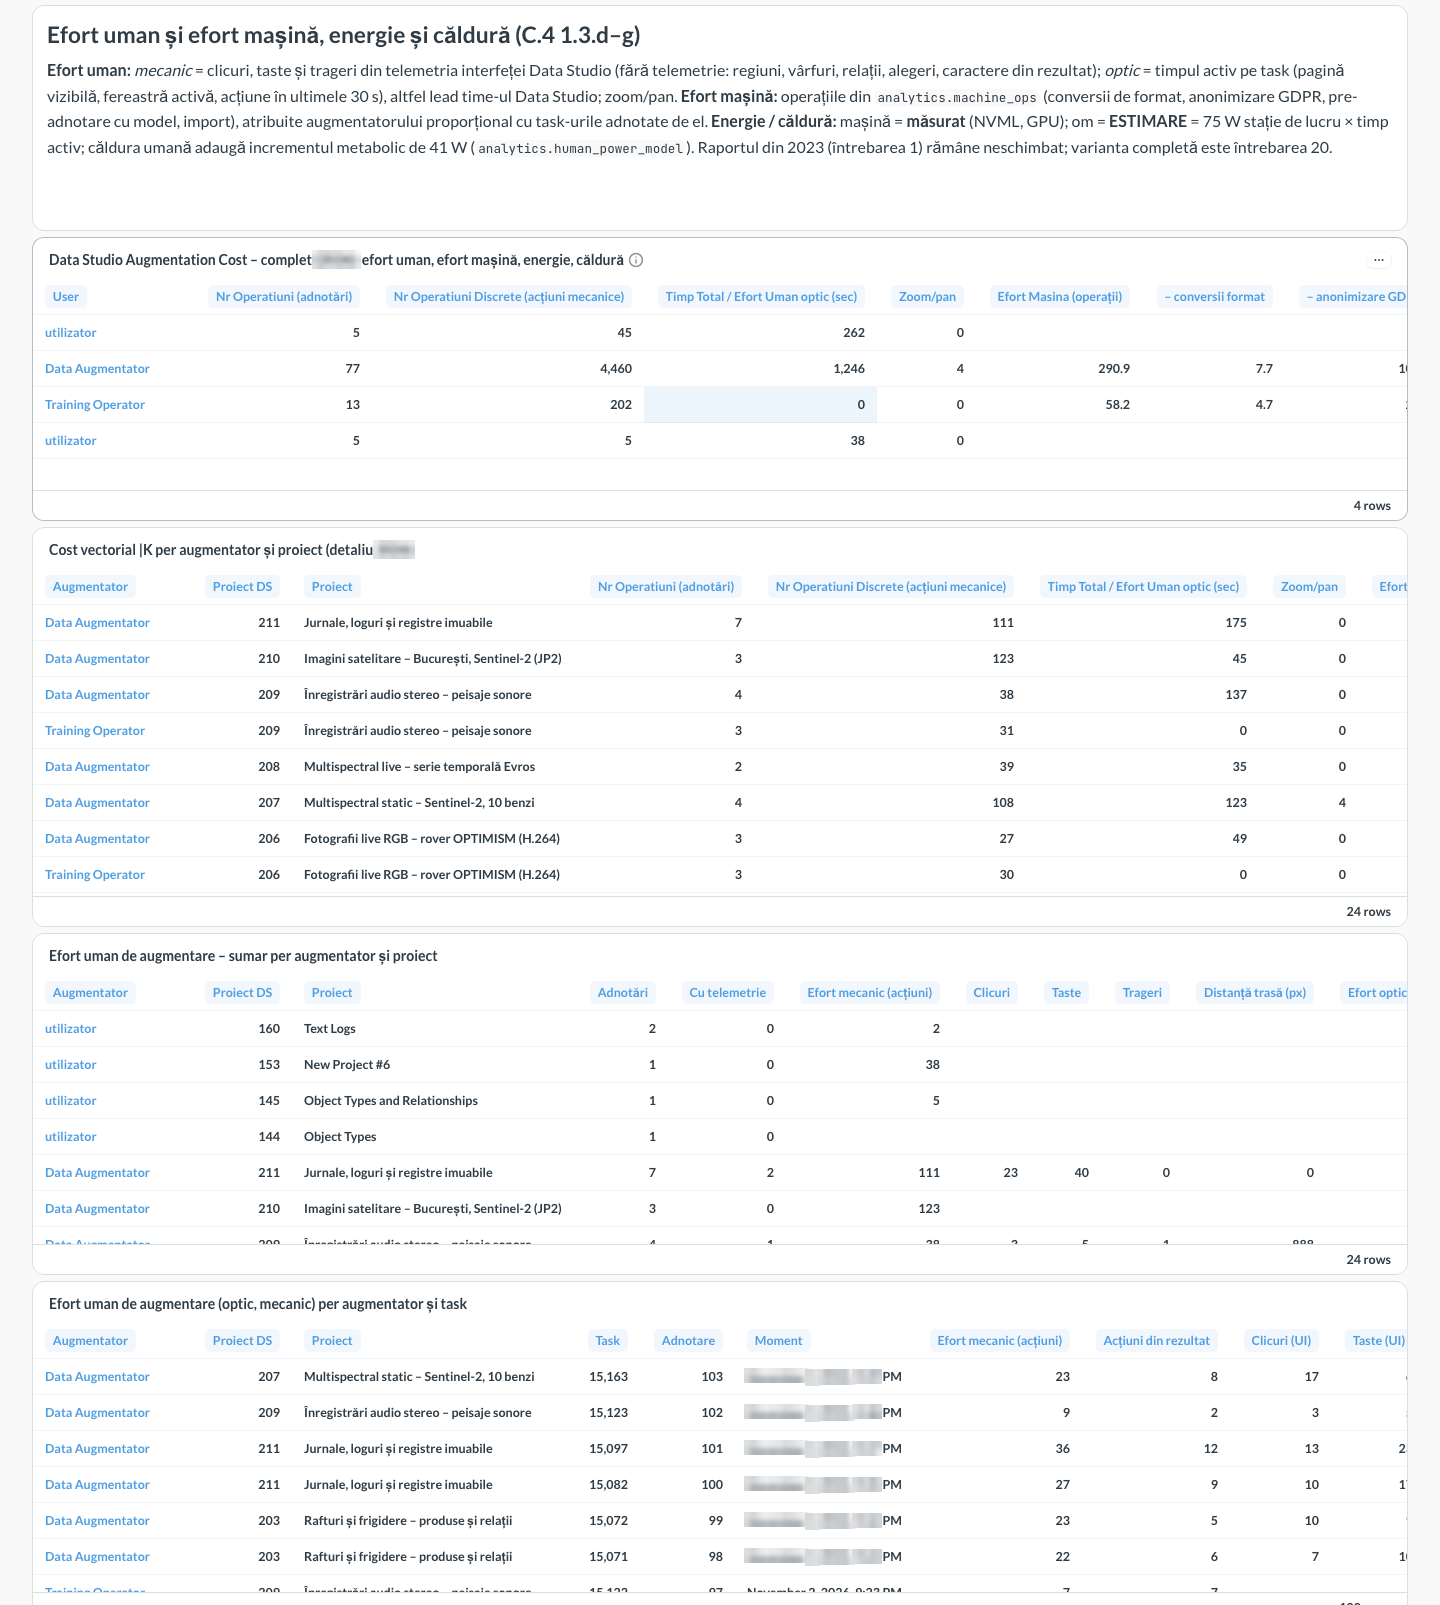
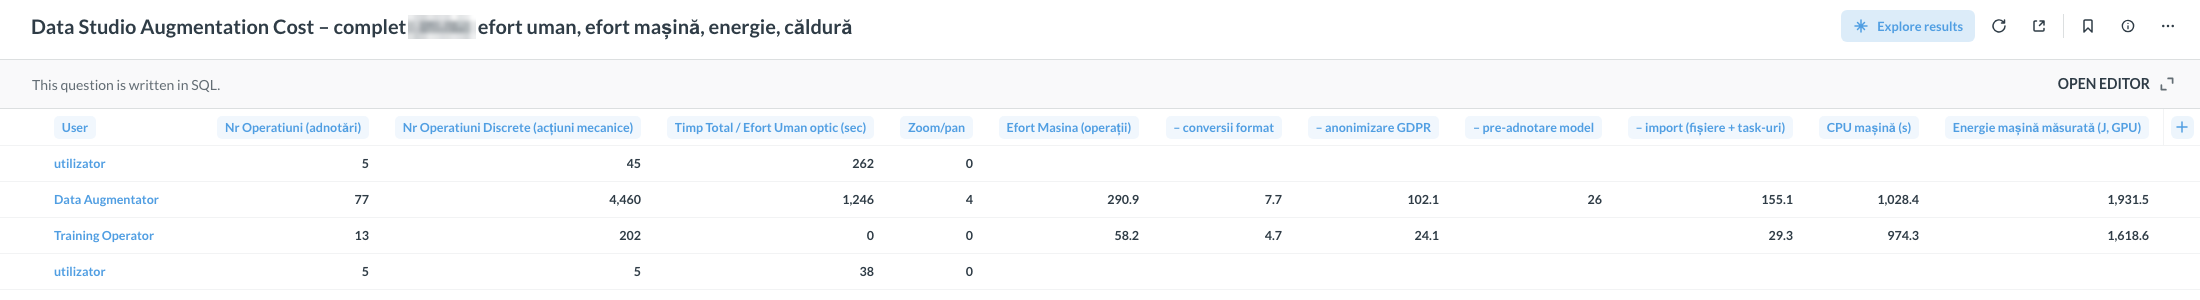
| Întrebarea 20 „Data Studio Augmentation Cost – complet” | coloanele raportului din 2023, completate: operații, acțiuni mecanice, efort optic, zoom/pan, efort mașină pe tipuri, CPU, energie mașină măsurată, energie umană estimată, căldură | question/20 |
| Întrebarea 21 | același cost vectorial, per augmentator și proiect | dashboard-ul 6 |
| Întrebarea 15 „Cost și energie per proiect” | ore de augmentare, sesiuni, bugete, rulări GPU, ore GPU, energie (kWh), căldură (MJ) | question/15 |
| Întrebarea 1 „Data Studio Augmentation Cost” (2023, neschimbată) | per augmentator, cu coloanele de efort mașină / energie / căldură la 0 | question/1 |
Cum se măsoară:
- Efort uman. nginx inserează un script de telemetrie în paginile Data Studio; scriptul trimite doar contoare (clicuri, taste, rotiță și zoom, trageri și lungimea lor, regiuni create/șterse, timp vizibil, activ și inactiv, timp de redare media), iar utilizatorul este luat din sesiunea SSO, nu din browser. Efort mecanic = clicuri + taste + trageri; efort optic = secundele active. Fără telemetrie (adnotări mai vechi) efortul se reconstituie din rezultat (regiuni, vârfuri, relații, alegeri, caractere) și din timpul măsurat de Data Studio.
- Efort mașină. Fiecare operație de mașină (conversie de format, anonimizare GDPR, pre-adnotare cu model, import) are un rând, cu energia NVML per fișier; efortul se atribuie augmentatorului proporțional cu task-urile adnotate de el.
- Energie și căldură. Partea mașină este măsurată (delta NVML netă de consumul în gol); partea umană este o estimare declarată: stație de lucru 75 W (PC 55 W după ENERGY STAR v8 + monitor 20 W) × timp activ; căldura adaugă incrementul metabolic al muncii de birou, 41 W.
Cifre reale (întrebarea 20, Data Augmentator): 77 de adnotări, 4.460 de acțiuni mecanice, 1.246 s efort optic, 290,9 operații mașină (7,7 conversii, 102,1 anonimizări, 26 de predicții de pre-adnotare, 155,1 operații de import), 1.028 s CPU, energie 95.314 J (1.932 J măsurați pe GPU + 93.382 J estimați pentru om), căldură 146.360 J. Pentru proiectul C.4: 9 time log-uri aprobate (9,4 minute), 199 de operații actuatoare și 81 de decizii perceptuale.
Limitări
- Efortul uman este măsurat prin proxy-uri declarate (acțiuni și timp activ), nu fiziologic; energia umană este o estimare după un model de putere declarat.
- Telemetria există doar pentru adnotările făcute prin interfață după introducerea telemetriei (6 adnotări, făcute de agent într-un browser automat).
- Energia CPU nu se poate măsura (mașină virtuală fără RAPL).
Calitatea post-validare a augmentării |Q
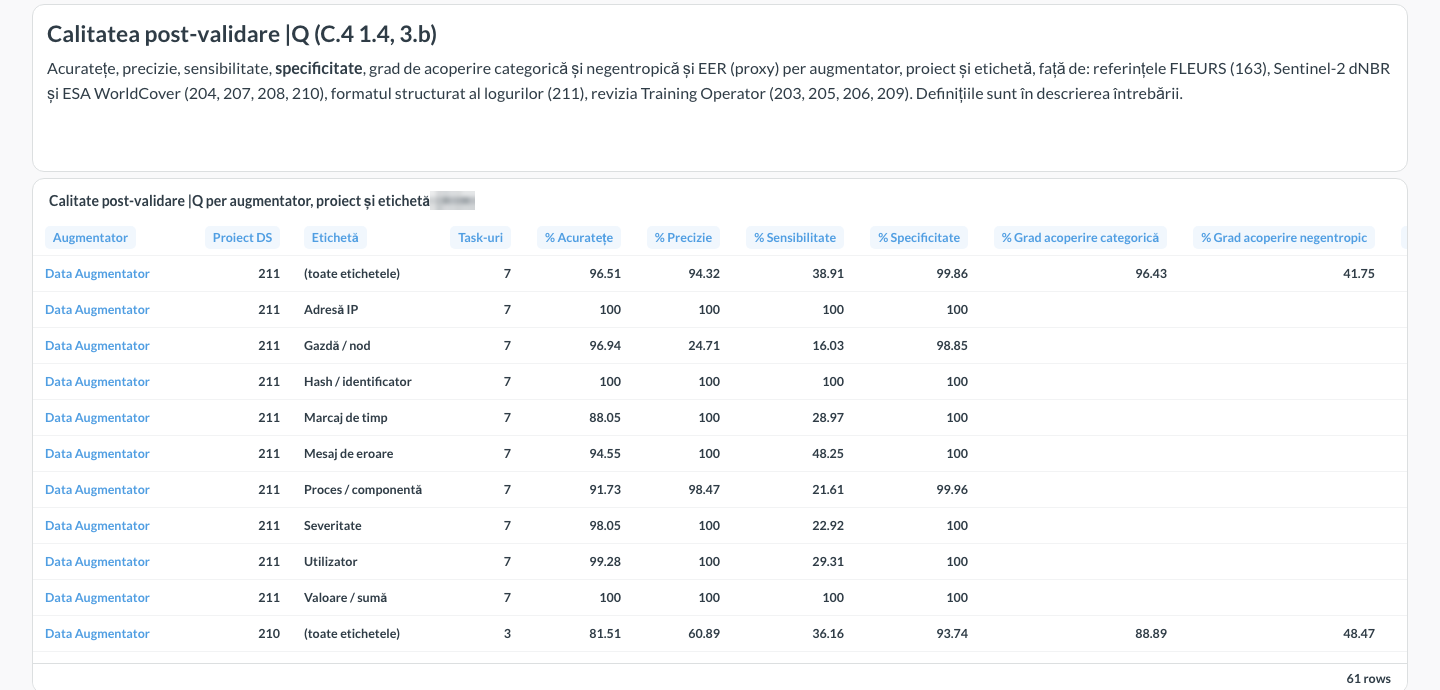
Întrebarea 22 „Calitate post-validare |Q per augmentator, proiect și etichetă” compară adnotările
augmentatorului cu date de validare, pe fiecare etichetă și total (scriptul quality.py):
| Proiect | Validare (gold) | Unitate |
|---|---|---|
| 163 (transcrieri) | transcrierea de referință FLEURS | task |
| 204 (SWIR) | dNBR Sentinel-2 (ars / neafectat), apa din ESA WorldCover | pixel |
| 207, 210 | ESA WorldCover 2021 | pixel |
| 208 (serie temporală) | prima achiziție cu dNBR > 0,27 | pixel |
| 211 (loguri) | câmpurile formatului structurat (Apache, syslog, blocuri Bitcoin) | caracter |
| 203, 205, 206, 209 | revizia Training Operator (adnotare separată în Data Studio) | casetă IoU ≥ 0,5 / segment |
| Proiect | Acuratețe | Precizie | Sensibilitate | Specificitate | Acop. categorică | Acop. negentropică | EER (proxy) |
|---|---|---|---|---|---|---|---|
| 163 | 90,4% | 80,8% | 80,8% | 93,6% | 100% | 100% | 12,8% |
| 204 | 87,9% | 82,7% | 71,1% | 94,3% | 100% | 74% | 17,3% |
| 207 | 86,2% | 62,3% | 43,6% | 94,7% | 81% | 69% | 30,8% |
| 208 | 92,5% | 83,5% | 71,3% | 97,0% | 100% | 73% | 15,9% |
| 210 | 81,5% | 60,9% | 36,2% | 93,7% | 89% | 48% | 35,1% |
| 211 | 96,5% | 94,3% | 38,9% | 99,9% | 96% | 42% | 30,6% |
| 203 | 76,5% | 96,9% | 73,8% | 88,9% | 100% | 90% | 18,7% |
| 205 | 91,7% | 100% | 80,0% | 100% | 100% | 98% | 10,0% |
| 206 | 89,3% | 100% | 85,7% | 100% | 100% | 99% | 7,1% |
| 209 | 97,5% | 100% | 92,9% | 100% | 100% | 97% | 3,6% |
Definiții: specificitate = TN / (TN + FP); sensibilitate = TP / (TP + FN); acoperire categorică = etichetele gold folosite de augmentator / etichetele gold prezente; acoperire negentropică = partea din semnalul gold acoperită (la 163: 1 − CER); EER (proxy) = 1 − (sensibilitate + specificitate) / 2 (pentru etichetele umane nu există un prag de variat). Raportul din 2023 („Data Studio Augmentation Raport Performanta”, întrebarea 2) rămâne neschimbat.
Limitări
- Pe 203, 205, 206 și 209, revizia Training Operator a fost făcută de același agent care a jucat și rolul de augmentator, deci nu e independentă (precizia e aproape 100% prin construcție; sensibilitatea arată obiectele omise). Pe celelalte proiecte validarea este obiectivă.
- Etichetele ESA WorldCover sunt și ele produsul unui model.
Adaptoare tensoriale de format pe CPU și GPU
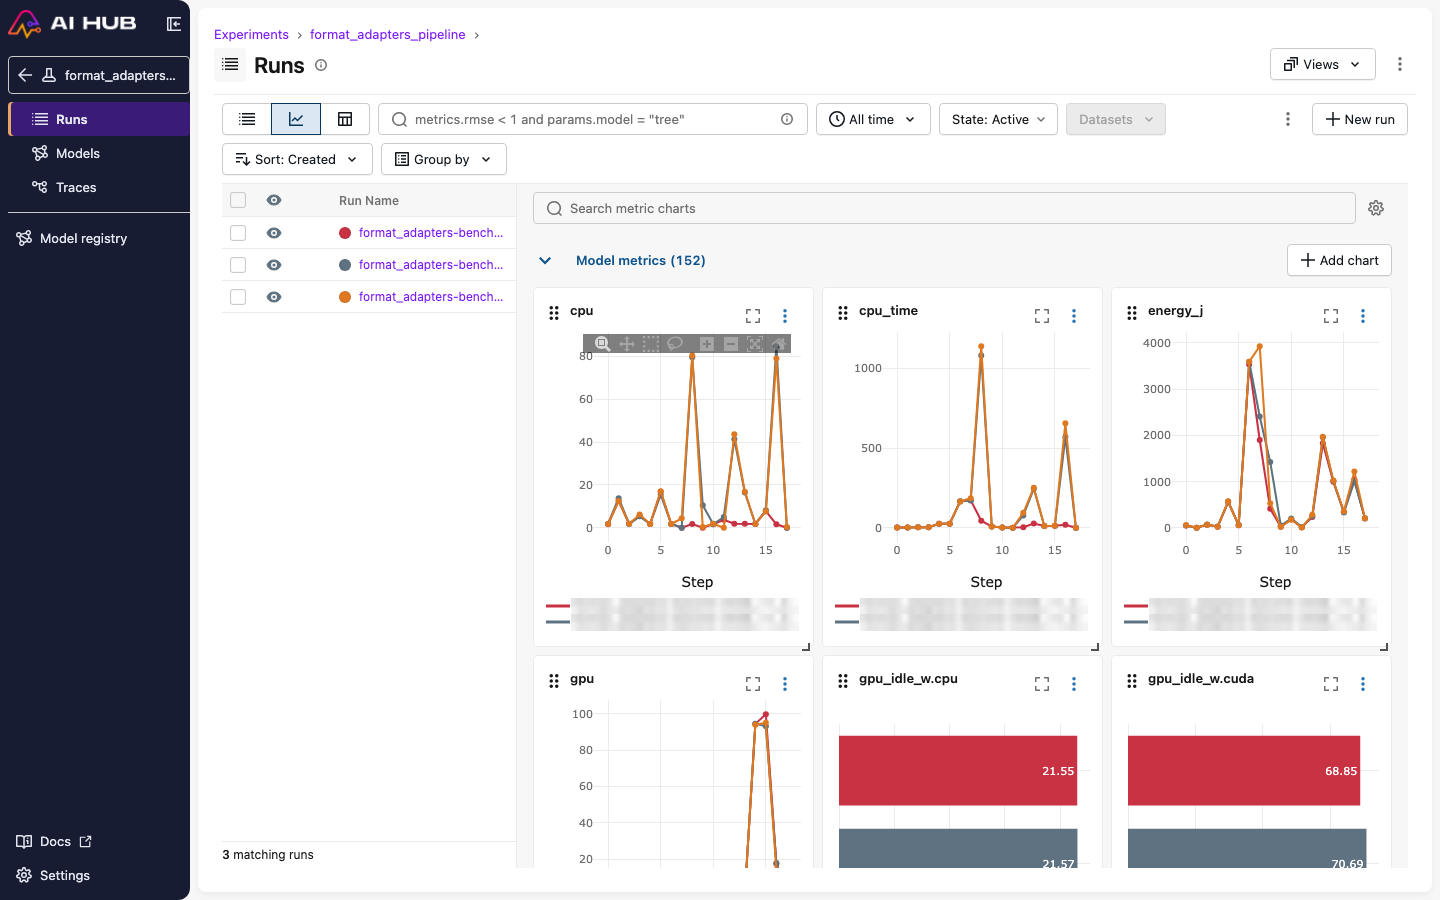
Pipeline-ul ZenML format_adapters_pipeline decodează fișiere reale din fiecare format în tensori C×H×W, pe
CPU și pe GPU, și măsoară debitul, latența p50/p95, secundele CPU și energia GPU netă (NVML). Rulările de referință:
7c4677fd922842b980872738df992fc9 (bench3) și, pentru drumurile GPU noi WebP/HEIC, 48649b052fa04ea49ad53ad5eb6bddf6
(bench5), în experimentul MLflow format_adapters_pipeline.
| Format | Cel mai bun drum CPU | Drum GPU | Câștig GPU |
|---|---|---|---|
| JPEG-2000 (8 benzi Sentinel-2, 693 MP) | OpenJPEG, 8 procese: 7,8 MP/s | nvJPEG2000: 58,8 MP/s; în lot de 8: 213,3 MP/s, 121,8 J | 7,5× / 27,3× |
| H.264 1080p → tensor RGB (1441 cadre) | libavcodec: 74,6 cadre/s, p95 21 ms, 45 s CPU | NVDEC: 116,2 cadre/s, p95 13 ms, 19,5 s CPU, 196 J | 1,56× |
| H.264, doar decodare | 1352 cadre/s pe 56 de fire, 7,9 s CPU | NVDEC: 555 cadre/s, 0,9 s CPU | 0,4×, dar CPU-ul rămâne liber |
| HEIC (24 de imagini întregi) | libheif, 16 fire: 80,8 MP/s, 26,8 s CPU | NVDEC HEVC: 95,9 MP/s, 1,8 s CPU, 28,3 J | 1,19× |
| HEIC în grilă de dale 512 px (ca la iPhone) | 121,3 MP/s, 31,2 s CPU | NVDEC: 122,7 MP/s, 1,2 s CPU | 1,01× |
| WebP cu pierderi (18 din 24) | libwebp, 16 fire: 76,1 MP/s | NVDEC VP8: 42,1 MP/s | 0,55×, dar CPU-ul rămâne liber |
| JPEG (referință, 236 MP) | libjpeg-turbo, 16 fire: 916 MP/s | nvJPEG în lot: 1257 MP/s | 1,37× |
- HEIC pe GPU: containerul HEIF și SPS-ul HEVC se citesc cu parsere proprii; dalele HEVC se decodează pe NVDEC (PyNvVideoCodec), iar asamblarea grilei, conversia YUV→RGB, decuparea și rotația rulează pe GPU. Rezultatul este identic cu libheif (diferență maximă 1, PSNR ≥ 89 dB).
- WebP pe GPU: WebP cu pierderi este un singur cadru VP8, pe care NVDEC-ul A40 îl suportă (diferență maximă 2 față de libwebp).
- JPEG-2000: ieșirea CPU și GPU este identică bit cu bit (verificat pe banda B12).
| Import în Data Studio | Conversie | Dispozitiv | Durată |
|---|---|---|---|
| proiectul 205 | 6 WebP + 2 HEIC → PNG | NVDEC pentru 2 HEIC și 5 WebP; un WebP de 5333×2531 px pe CPU | ~4–6 s pe o fotografie de 10 MP (aproape tot e scrierea PNG-ului) |
| proiectul 210 | 12 decupaje JPEG-2000 → PNG | GPU (nvJPEG2000) | 0,6–1,2 s pe decupaj |
| proiectul 206 | 12 clipuri H.264 → 6 cadre fiecare | GPU (NVDEC, h264_cuvid) |
~0,6–0,7 s pe clip |
Fiecare task afișează formatul original, adaptorul, dispozitivul și durata conversiei.
Limitări
- WebP pe GPU este mai lent decât CPU pe fișierele mici de test (în medie 2 MP); WebP fără pierderi (VP8L) și imaginile peste 4096 px nu au decodor NVDEC și rămân pe CPU; canalul alfa nu se decodează.
- Energia CPU nu se poate măsura (VM fără RAPL): pentru CPU se raportează doar secunde CPU.
- Mostrele HEIC sunt codificate de noi din fotografii Commons (nu s-a găsit un set HEIC cu licență clară).
Seturi de date de la furnizori: server propriu, preț de trafic, traseu
| Funcție | Unde | Rezultat real |
|---|---|---|
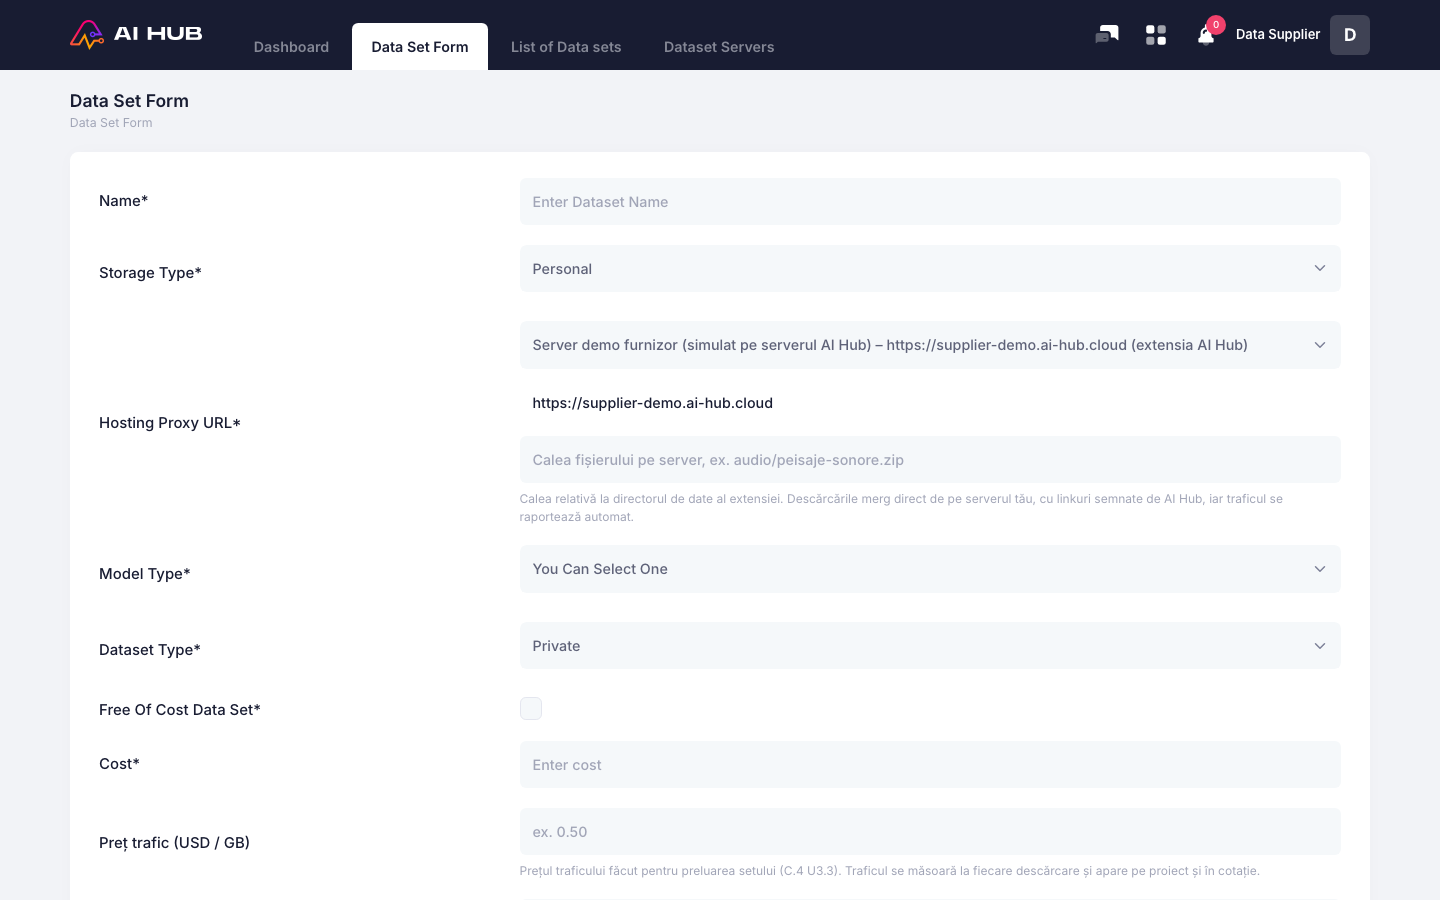
| Server propriu cu extensia AI Hub | Data Supplier → Dataset Servers (înregistrare, Verifică); Data Set Form → Storage Type „Personal” → serverul și calea fișierului | setul „Înregistrări audio stereo – găzduite la furnizor (extensia AI Hub)”, proiectul Data Studio 212 |
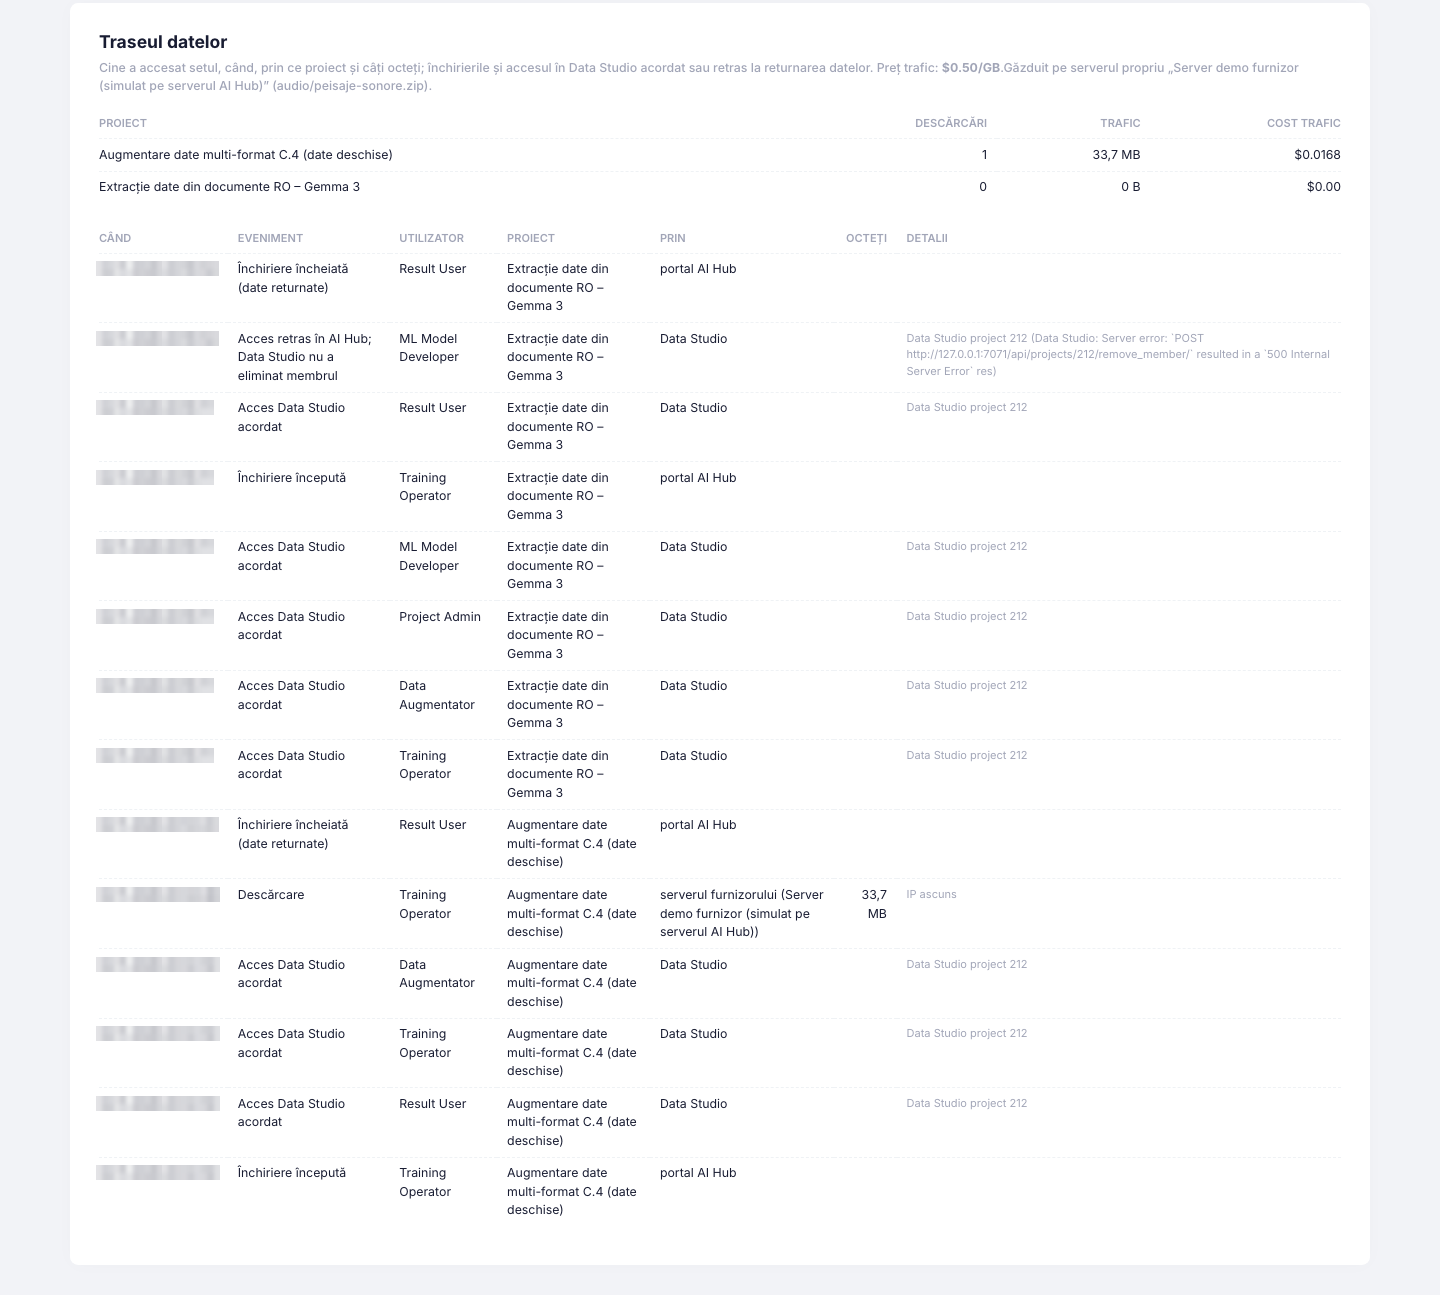
| Descărcare contorizată | butonul „Descarcă setul de date” pe set (membrii proiectelor): AI Hub verifică accesul și emite un link semnat valabil 15 minute | 33.697.354 octeți, sha256 identic cu originalul, raport complete:true |
| Preț trafic | Data Set Form → „Preț trafic (USD / GB)” | 0,50 USD/GB → 0,0168 USD pe descărcare |
| Traseul datelor | pagina setului la Data Supplier → „Traseul datelor” | descărcări, închirieri, acces Data Studio acordat/retras, trafic și cost pe proiect |
| Returnarea datelor | End Rent (Result User / Project Admin) retrage accesul celor fără altă cale de acces | închirierea din proiectul de extracție: acces retras doar pentru ML Model Developer |
| Arhive nepublice | arhivele și atașamentele de suport nu mai sunt servite public (404); doar linkuri semnate, contorizate | verificat anonim, cu token modificat și pentru un utilizator fără drept |
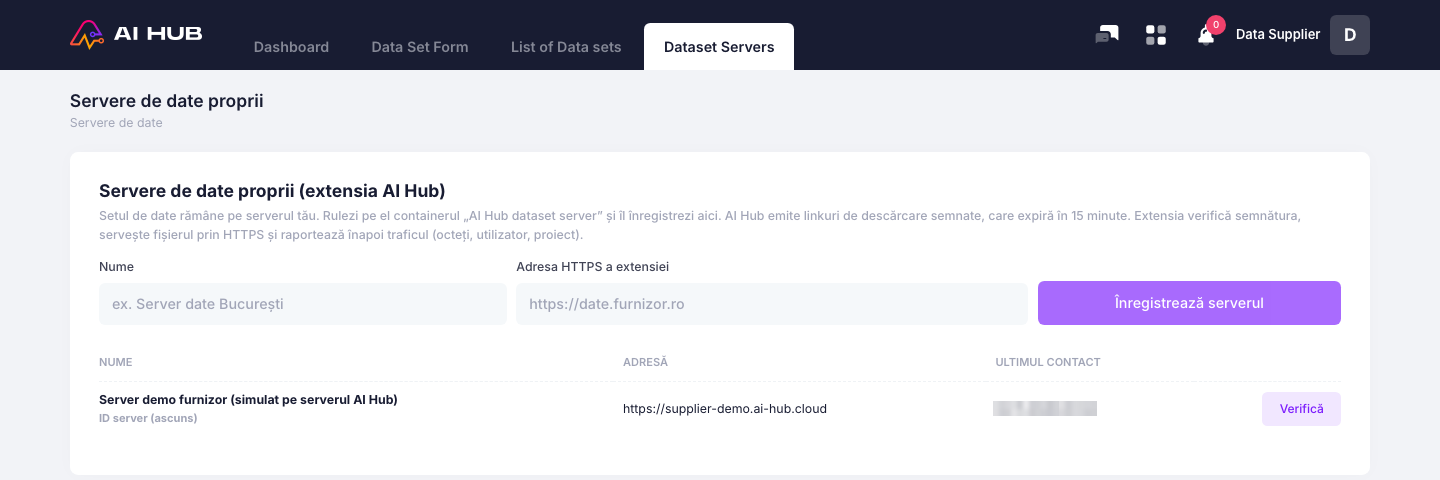
Extensia „AI Hub dataset server” (FastAPI, instalată la furnizor) servește fișierele numai pe token-uri semnate
HMAC-SHA256 cu termen, raportează fiecare descărcare (octeți, completă/întreruptă) și păstrează rapoartele într-o coadă
locală când AI Hub nu răspunde. Testele reale: fără token sau cu token modificat → 401, expirat → 410, alt fișier →
403, ../ → 400.
Limitări
- Instanța demo
supplier-demo.onprem.ai-hub.cloudsimulează serverul unui furnizor: rulează ca un container separat pe serverul AI Hub. - Doar descărcările prin linkul semnat sunt contorizate; descărcările întrerupte se reiau de la zero.
Anonimizare GDPR la încărcare și la import
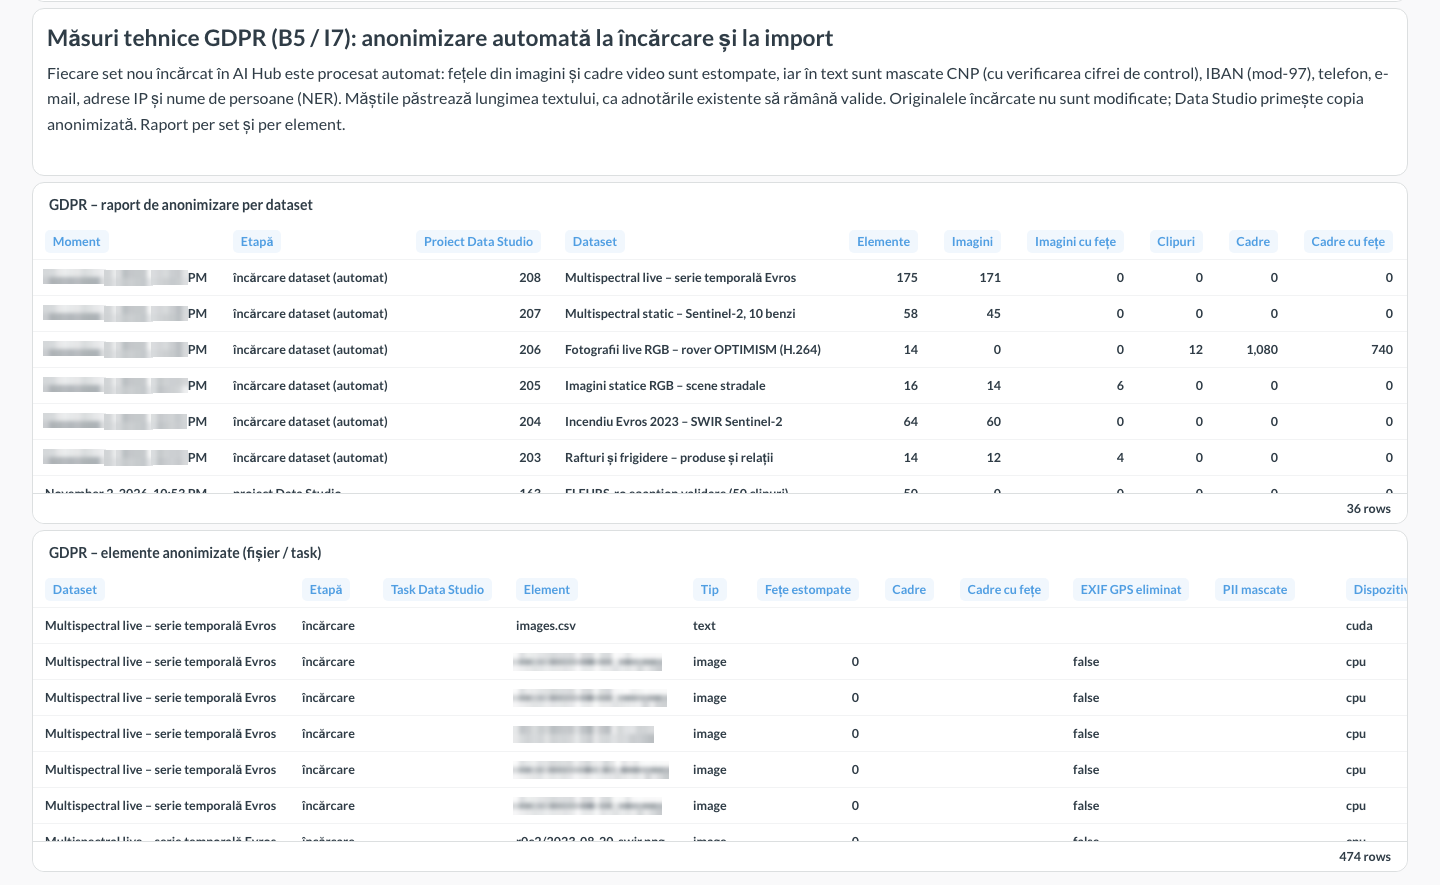
Pachetul aihub_gdpr_anonymizer (pipeline ZenML gdpr_anonymization_pipeline, cron la 10 minute pe seturile noi):
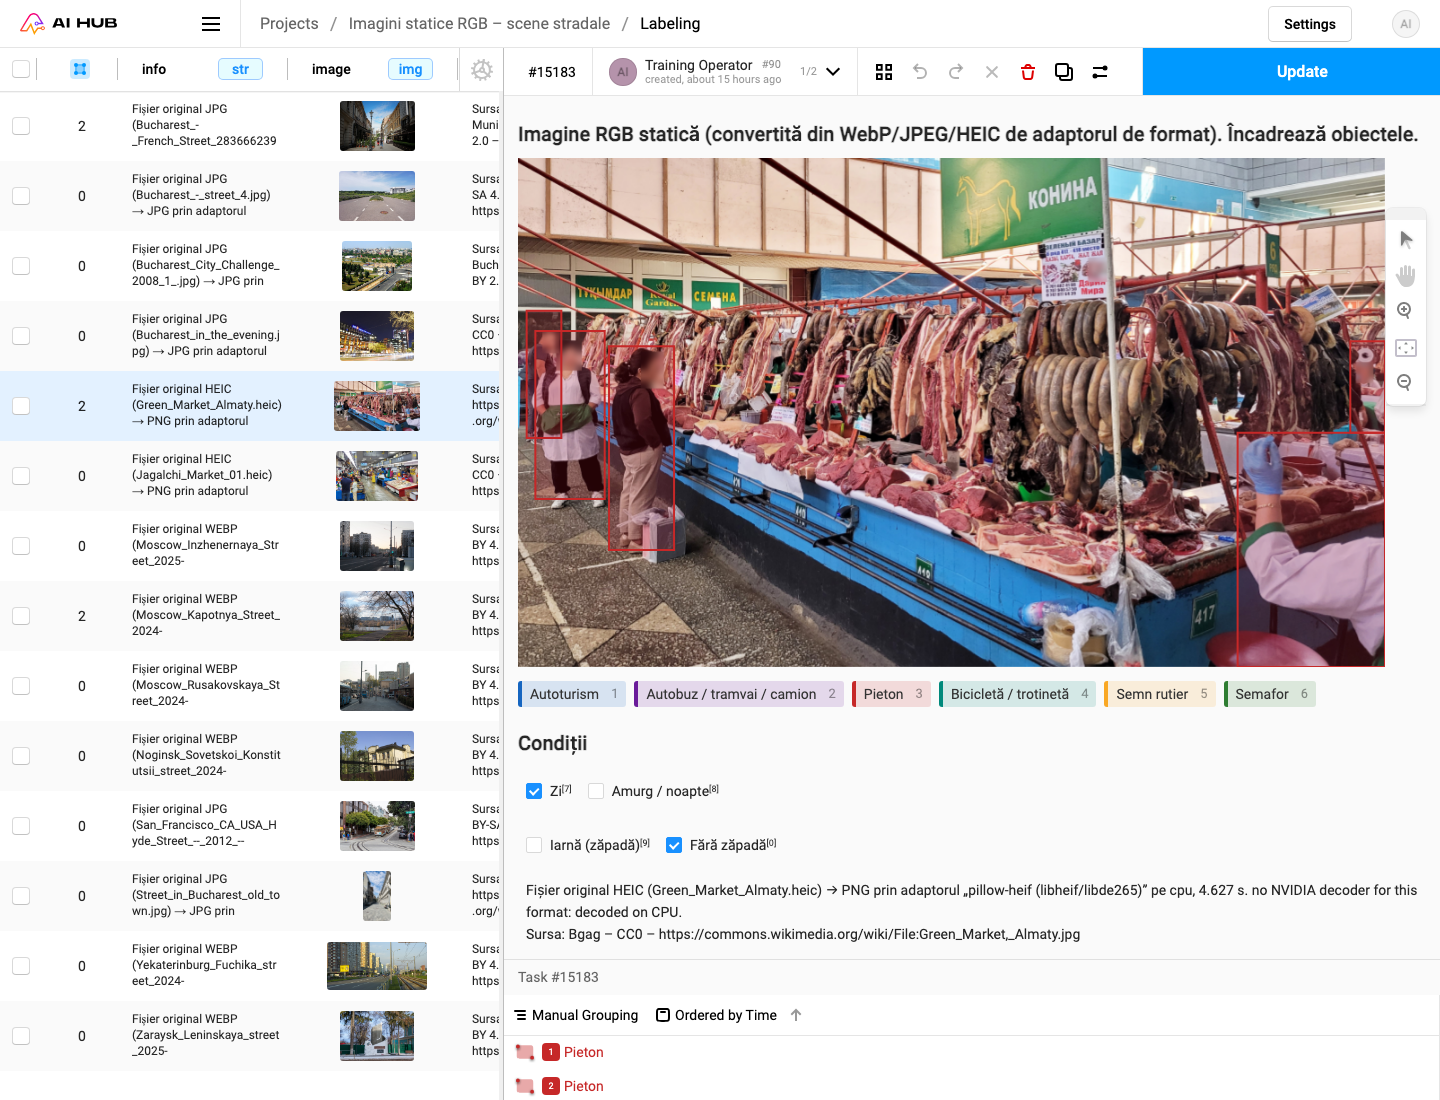
- Fețe (detector YuNet): pixelate și estompate ireversibil în imagini și în fiecare cadru video; EXIF-ul (inclusiv GPS) este eliminat.
- Text: CNP (cu cifra de control), IBAN (mod 97), telefoane, e-mail, adrese IP, nume de persoane (NER
bert-base-romanian-ner), mascate cu aceeași lungime, ca adnotările să rămână valide. - Originalele nu se modifică; copia anonimizată și raportul ajung separat, iar Data Studio primește copia.
| Proiect | Ce s-a anonimizat |
|---|---|
| 203 (rafturi) | 11 fețe în 4 din 12 imagini |
| 205 (scene stradale) | 26 de fețe în 6 din 14 imagini |
| 206 (fotografii live) | 1.467 de detecții; 740 din 1.080 de cadre au fețe |
| 211 (loguri) | 48 de adrese IP; cele 62 de segmente adnotate rămân valide |
| seturile încărcate recent | 1.433 de adrese IP mascate în loguri |
Limitări
Numerele de înmatriculare și vocile din audio nu sunt anonimizate; fețele foarte mici sau acoperite pot scăpa detecției.
Cum se demonstrează
Cum se demonstrează
- Data Supplier pe onprem.ai-hub.cloud → List of Data sets: seturile lui, cu licența și prețul; setul găzduit la furnizor → Traseul datelor; meniul Dataset Servers → Verifică.
- Data Augmentator → My Projects: proiectul „Augmentare date multi-format C.4” are contracte pe fiecare set. Butonul AI Hub Data Studio deschide proiectul de etichetare fără alt login.
- În Data Studio: proiectele 203 (relații), 204 (SWIR), 208 (serie temporală), 210 (JPEG-2000 convertit), 205 (fețe estompate). Se deschide un task deja adnotat, apoi se adnotează unul nou (telemetria înregistrează efortul).
- Data Augmentator → sesiunea → Activity: pornește și oprește time log-ul; Training Operator aprobă.
- Project Admin → Instrumente → BI → dashboard-ul 6: efort uman și mașină, energie, căldură, calitatea |Q, planurile AoT, rapoartele GDPR; dashboard-ul 5: cost per proiect / etapă / echipă.
- Training Operator → Instrumente → MLflow → experimentul
format_adapters_pipeline: tabelul CPU vs GPU.
Licențe și surse
| Set | Sursă | Licență |
|---|---|---|
| Rafturi/frigidere (12) | Wikimedia Commons (autor și URL pe fiecare rând) | CC0, CC BY 2.0, CC BY 4.0, CC BY-SA 3.0/4.0 |
| Scene stradale (14) | Wikimedia Commons (WebP originale, JPEG-uri București și San Francisco) | CC BY 4.0, CC0, CC BY 2.0, CC BY-SA 4.0 |
| Scene stradale – 2 HEIC | codificate de AI Hub din JPEG-uri Commons CC0 | CC0 |
| Fotografii live | NASA/JPL-Caltech, „Twin Rover Gets to Work” (2020), fără coloana sonoră | media NASA, domeniu public |
| SWIR / multispectral / serie temporală | Copernicus Sentinel-2 L2A, dala 35TMF, aug–sept 2023 (Element84 earth-search, AWS Open Data) | date Copernicus libere și deschise |
| Satelit București | Copernicus Sentinel-2 L1C TCI, dala 35TMK, 23.09.2025 | date Copernicus libere și deschise |
| Audio stereo (9) | Wikimedia Commons | domeniu public, CC0, CC BY 3.0/4.0, CC BY-SA 3.0/4.0 |
| Loguri Apache / Linux | Loghub (Zhu et al.), Zenodo 8196385 | CC BY 4.0 (README-ul GitHub: „freely available for research or academic work”) |
| Registru Bitcoin | blocurile 920000–920011, API mempool.space | date publice de registru |
| Mostre pentru benchmark-ul adaptoarelor | Commons (JPEG/WebP), Big Buck Bunny (Blender Foundation), Sentinel-2 L1C | CC0 / CC BY / domeniu public; CC BY 3.0; Copernicus |
Lista completă este pe pagina Licențe și surse de date.