Librărie Algoritmi Artificial Intelligence
Biblioteca de modele de estimare (C.4, componenta 5): registrul MLflow, cele 6 modele cerute, metodele tehnologice (variante mobile și data center) și cele 2 aplicații practice, Analiza supraveghere video și Identificarea biometrică.
- Registrul de modele
- Cele 6 modele cerute în C.4
- Transformare imagine text → text editabil (ocr-ro)
- Recunoaștere facială (face-recognition)
- Recunoașterea mimicii feței – Face Mask (face-mask)
- Mimica feței: expresii faciale (face-expression)
- Recunoașterea obiectelor în funcție de parametri (object-detection)
- Identificarea sensului unui text
- Anomalii la senzori și analiză predictivă
- Metodele tehnologice
- Aplicația practică a) Analiza supraveghere video
- Aplicația practică b) Identificare biometrică
- Licențe
Registrul de modele
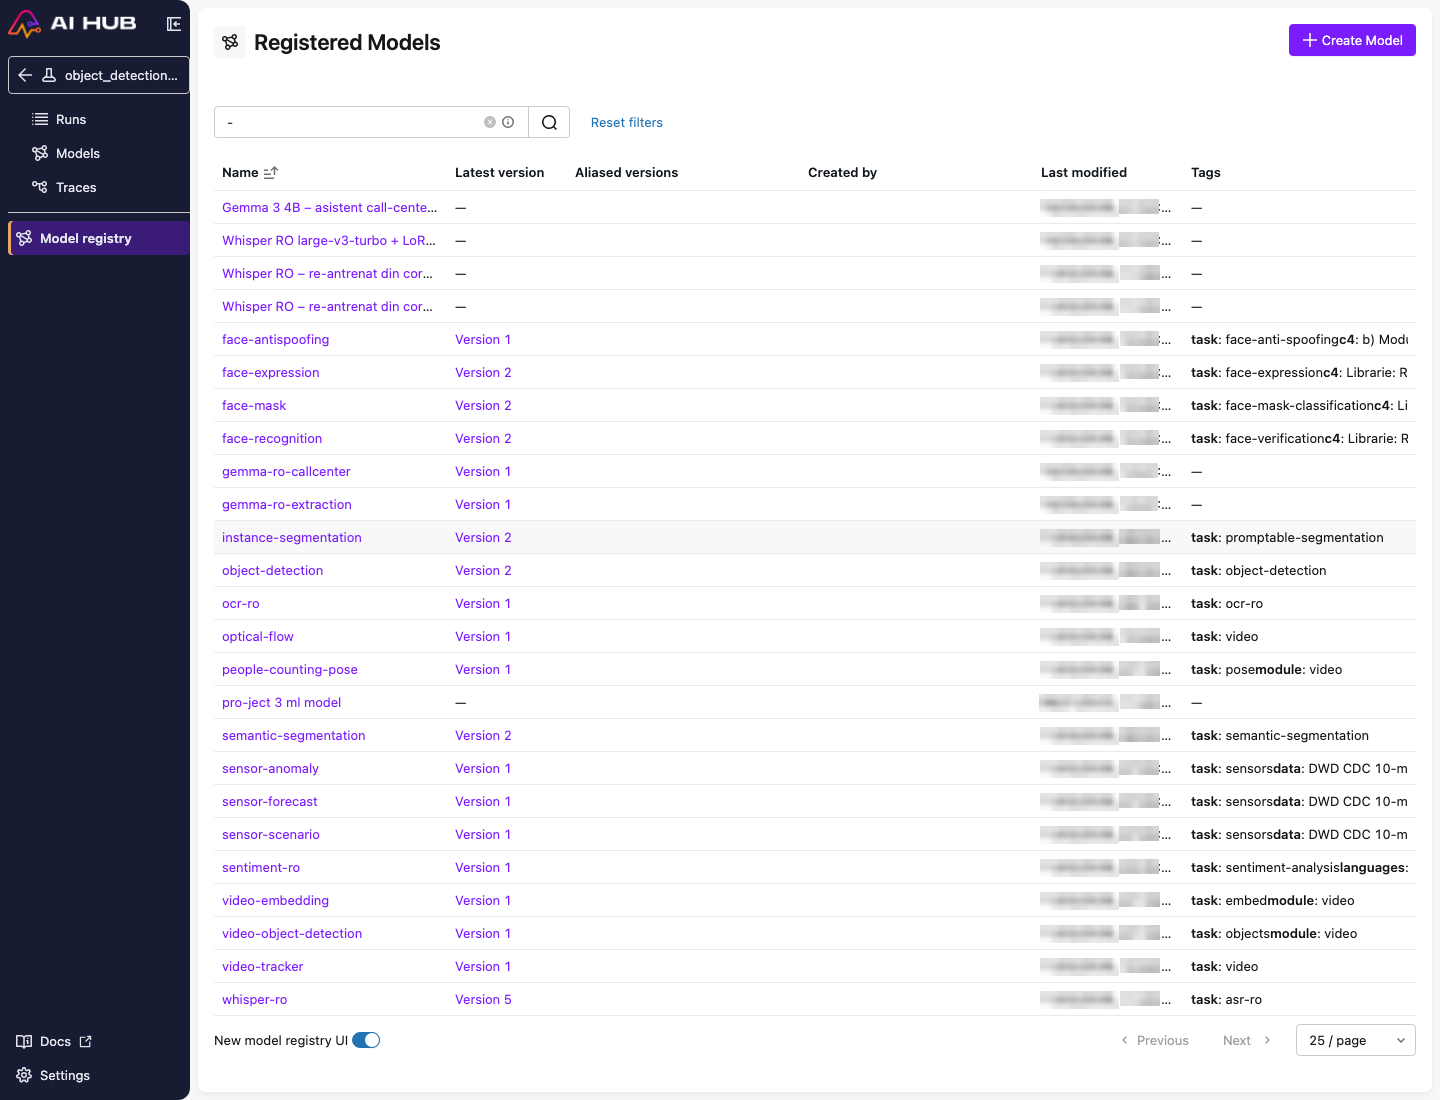
Biblioteca este registrul de modele MLflow (mlflow.onprem.ai-hub.cloud → Model registry). Fiecare versiune are descrierea, tag-urile (sarcină, date, licență, proiect AI Hub), legătura la rularea de antrenare sau evaluare (metrici și parametri) și artefactele de servire. Celelalte module o citesc astfel:
| Consumator | Cum primește informațiile |
|---|---|
| API-ul de inferență | GET /v1/models și GET /v1/models/{nume} (lista, parametrii, funcționalitățile, intrările/ieșirile, licența, versiunea MLflow cu metrici) – vezi Core Stack |
| Portalul | link-ul MLflow al fiecărui model ML → „Metrici reale (MLflow)”; GET /api/v1/{rol}/ml-model/{id}/metrics |
| Aplicațiile practice | video, senzori și biometrie își încarcă versiunile din registru și le afișează (ex. panoul „Modele” din dashboard-ul de senzori) |
| Dezvoltatorii | artefactele model (safetensors / state dict / ONNX) și, la OCR și detecție, serving/predict.py + calea modelului |
| Model în registru | Versiuni | Sarcină | Servit de |
|---|---|---|---|
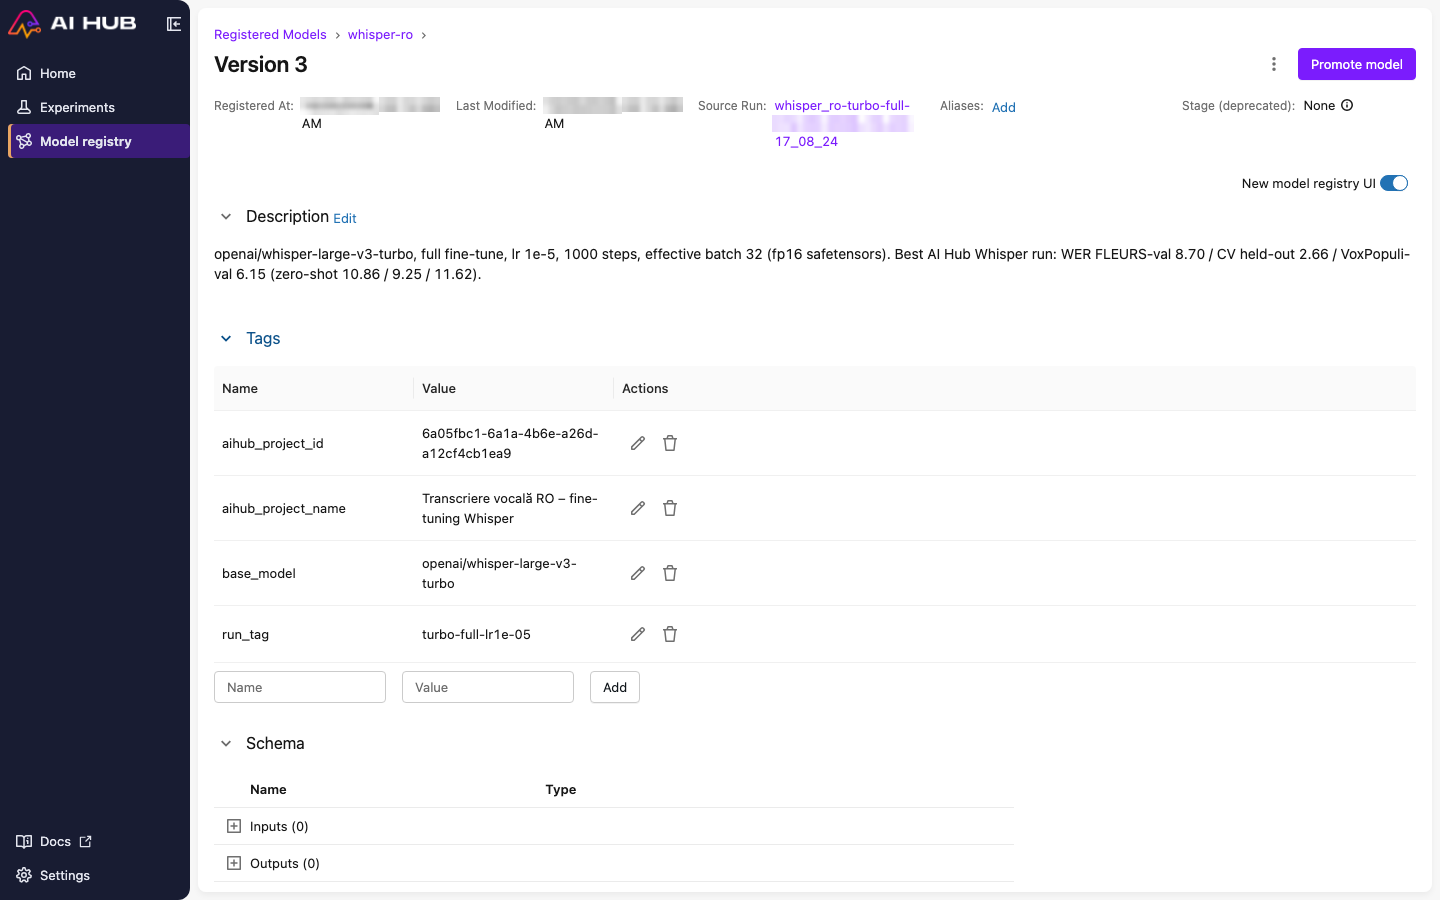
whisper-ro |
v1–v5 (v4 și v5 re-antrenate din corecturi umane; v4 mai slab, quality_gate: failed) |
transcriere vocală RO | API /v1/transcribe (v5) |
gemma-ro-extraction |
v1 | extracție JSON din documente RO | API /v1/extract |
gemma-ro-callcenter |
v1 | agent call-center RO cu apeluri de funcții | – (portal, model aprobat) |
sentiment-ro |
v1 | sentiment (RO/EN) | API /v1/sentiment |
face-recognition |
v1 (SFace, edge), v2 (ArcFace R100, data center) | recunoaștere facială | API /v1/face/embed, /verify (v1), bio.onprem.ai-hub.cloud (v1) |
face-mask |
v1 (MobileNetV3-Small), v2 (EfficientNet-B0) | mască / mimica feței | API /v1/face/mask, bio.onprem.ai-hub.cloud |
face-expression |
v1 (MobileNetV3-Small), v2 (EfficientNet-B0) | expresii faciale (7 clase) | bio.onprem.ai-hub.cloud („Clasifică expresia”) |
face-antispoofing |
v1 (MiniFASNet V2 + V1SE) | anti-spoofing pasiv (validarea prezenței) | bio.onprem.ai-hub.cloud (liveness verificat pe server) |
sensor-anomaly, sensor-forecast, sensor-scenario |
v1 | anomalii, prognoză, scenariu de risc | API /v1/sensors/*, sensors.onprem.ai-hub.cloud |
people-counting-pose, video-object-detection, video-embedding |
v1 | numărare persoane, obiecte COCO, embedding imagine/text | API /v1/vision/*, video.onprem.ai-hub.cloud |
optical-flow, video-tracker |
v1 | flux optic RAFT, urmărire compensată de mișcare | video.onprem.ai-hub.cloud |
ocr-ro |
v1 (TrOCR-small fine-tunat) | OCR documente RO (pagină sau poză → text) | API /v1/ocr, /v1/ocr/invoice |
object-detection |
v1 (SSDlite, mobil), v2 (Faster R-CNN R50, GPU) | detecție cu parametri, 14 clase | API /v1/detect (v1) |
semantic-segmentation |
v1 (LR-ASPP MobileNetV3, mobil), v2 (DeepLabV3-R101, GPU) | acoperirea terenului din Sentinel-2 | API /v1/segment/landcover (ambele, prin variant; implicit v2) |
instance-segmentation |
v1 (MobileSAM, mobil), v2 (SAM ViT-H, GPU) | segmentare cu prompt (casetă / punct) | API /v1/segment/prompt (ambele, prin variant; implicit v1) |
Cele 6 modele cerute în C.4
| Model cerut | Implementare | Rezultat principal (real) | Stare |
|---|---|---|---|
| Transformare imagine text în text editabil | ocr-ro: TrOCR fine-tunat pe documente românești + detecția textului docTR |
CER 3,02% pe pagini scanate; poză de factură → JSON F1 0,978 | funcțional |
| Recunoaștere facială | face-recognition v1 SFace / v2 ArcFace R100 |
LFW 99,27% (SFace) / 99,67%, EER 0,32% (ArcFace) | funcțional |
| Recunoașterea mimicii feței (Face Mask) | face-mask v2 EfficientNet-B0; face-expression v2 (7 expresii); mimica live prin MediaPipe |
mască: acuratețe 98,74%, macro-F1 93,72%; expresii: 93,33% neutru/fericit pe fețe reale | funcțional |
| Recunoașterea obiectelor solide în funcție de parametri | object-detection (14 clase, classes / score_threshold / iou_threshold / max_detections), API /v1/detect |
mAP@0.5 79,7% (R50, GPU) / 68,1% (SSDlite, mobil) | funcțional |
| Identificarea sensului unui text (serie și număr factură) | gemma-ro-extraction + sentiment-ro |
F1 0,949 (curat) / 0,944 (zgomot OCR); factura demo 71/72 câmpuri | funcțional |
| Anomalii la senzori + analiză predictivă de scenariu | sensor-anomaly / sensor-forecast / sensor-scenario |
ROC-AUC 0,933 anomalii; făinare ROC-AUC 0,98, F1 0,91 | funcțional |
Transformare imagine text → text editabil (ocr-ro)
Pipeline-ul ZenML ocr_ro_finetune_pipeline (ocr_data_loader → trocr_trainer → ocr_evaluator →
invoice_e2e_evaluator), experimentul MLflow ocr_ro_finetune_pipeline. Recunoaștere: TrOCR (trocr-small-printed,
62 M parametri, și trocr-base-printed, 334 M), fine-tuning complet pe 1.186.651 de segmente randate din documentele
sintetice românești sas-demo (14 familii), cu augmentări de scanare și de poză cu telefonul. Pagina întreagă: găsirea
foii și îndreptarea perspectivei, corectarea înclinării, detecția cuvintelor cu docTR db_resnet50, gruparea în rânduri
și coloane, recunoașterea cu TrOCR.
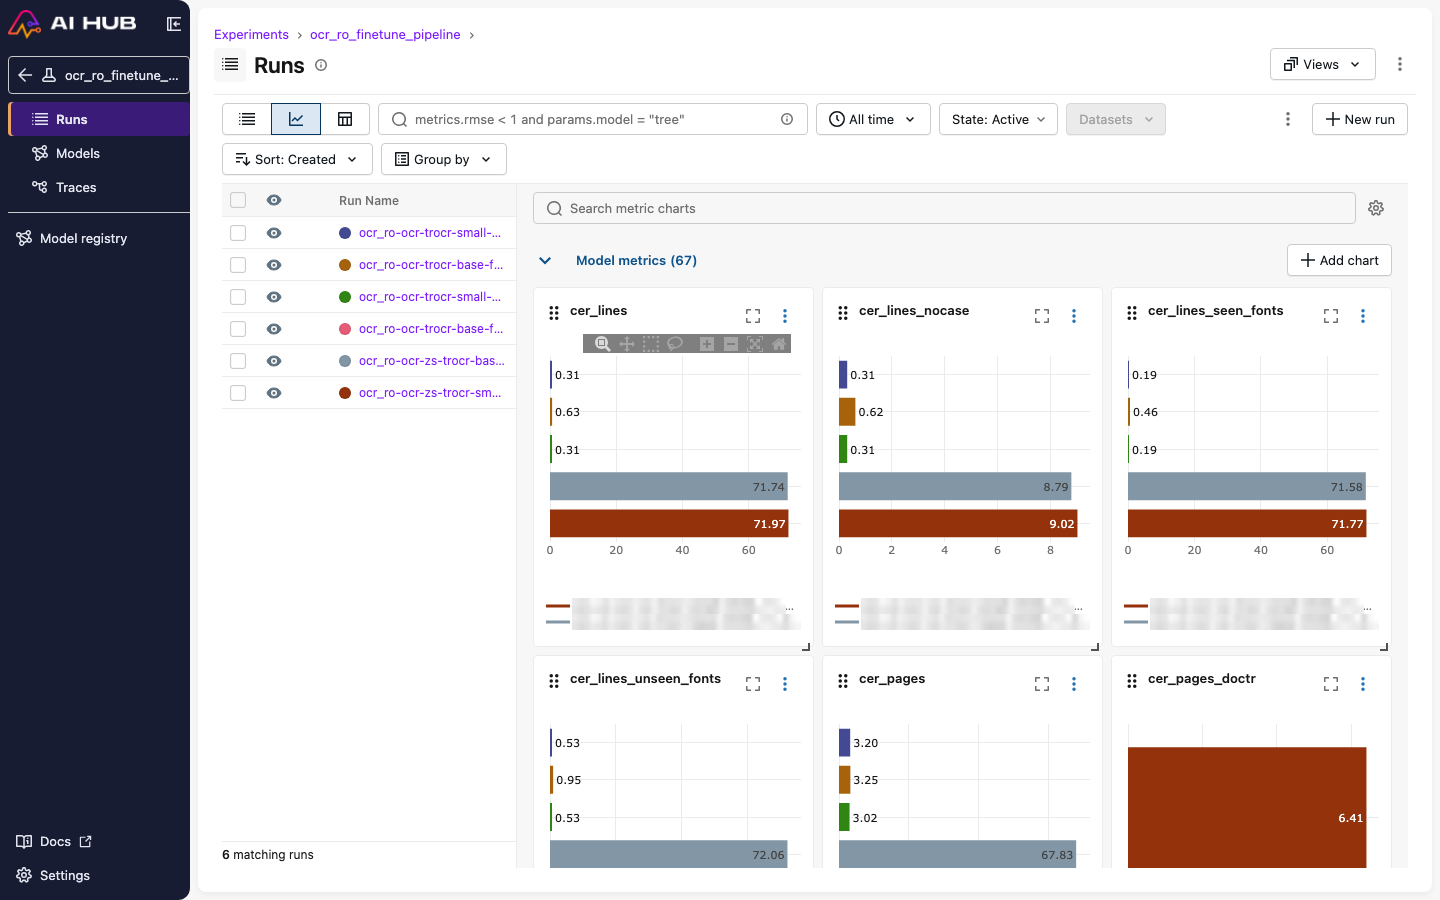
Test fix, același pentru toate rulările: 2.996 de segmente (o treime în fonturi nefolosite la antrenare), 42 de pagini scanate, 14 facturi fotografiate, toate din documente nevăzute la antrenare.
| Model | CER linii | CER linii, fonturi nevăzute | CER pagini | WER pagini | CER poze | WER poze |
|---|---|---|---|---|---|---|
| TrOCR-small zero-shot | 71,97 | 72,36 | 68,20 | 86,54 | 63,40 | 78,49 |
| TrOCR-base zero-shot | 71,74 | 72,06 | 67,83 | 85,55 | 63,29 | 77,77 |
| docTR zero-shot (db_resnet50 + parseq) | – | – | 6,41 | 25,17 | 23,86 | 34,11 |
TrOCR-small fine-tunat (ocr-ro v1) |
0,31 | 0,53 | 3,02 | 4,46 | 20,22 | 11,77 |
| TrOCR-base fine-tunat | 0,63 | 0,95 | 3,25 | 5,33 | 20,72 | 13,99 |
| TrOCR-small fine-tunat + DB-MobileNet | 0,31 | 0,53 | 3,20 | 5,14 | 20,87 | 12,77 |
(CER/WER în %, cu majuscule. Modelele „printed” zero-shot răspund numai cu majuscule; fără majuscule CER-ul lor ar fi
~9%.) CER-ul pe poze este mai mare decât WER-ul pentru că facturile au tabele cu linii lungi de ----- și |, pe care
detectorul de text nu le ia drept cuvinte; scorate offline fără aceste caractere de formatare, aceleași predicții dau CER
0,62% pe pagini și 1,43% pe poze pentru ocr-ro (docTR zero-shot: 3,89% / 4,19%).
Poză de factură → OCR → gemma-ro-extraction → JSON (14 facturi fotografiate, F1 pe atomi):
| Text dat modelului de extracție | F1 | Precizie | Recall | JSON valid |
|---|---|---|---|---|
| textul original (limita superioară) | 1,000 | 1,000 | 1,000 | 14/14 |
OCR ocr-ro (TrOCR-small fine-tunat) |
0,978 | 0,977 | 0,979 | 14/14 |
| OCR TrOCR-small fine-tunat + DB-MobileNet | 0,967 | 0,968 | 0,966 | 14/14 |
| OCR TrOCR-base fine-tunat | 0,948 | 0,982 | 0,916 | 13/14 |
| docTR zero-shot | 0,929 | 0,923 | 0,935 | 14/14 |
| TrOCR-base zero-shot | 0,867 | 0,867 | 0,867 | 14/14 |
| TrOCR-small zero-shot | 0,827 | 0,824 | 0,829 | 14/14 |
Consum mic vs performanță maximă (A40, măsurat):
| Configurație | Parametri | Energie GPU / 1.000 linii | Linii/s (GPU) | CPU ms/linie (8 fire) | Energie / pagină | s / pagină |
|---|---|---|---|---|---|---|
| TrOCR-small + DB-MobileNet („mobil”) | 62 M | 1.360 J | 89,5 | 261 | 104 J | 0,96 |
TrOCR-small + DB-ResNet50 (ocr-ro) |
62 M | 1.357 J | 89,5 | 267 | 107 J | 0,98 |
| TrOCR-base + DB-ResNet50 („data center”) | 334 M | 5.451 J | 45,1 | 1.593 | 358 J | 1,64 |
Modelul small este pe acest domeniu și mai precis, și de ~4× mai ieftin energetic decât base; este și singurul utilizabil pe CPU. Costul antrenării: small 20.000 de pași, 70 min pe A40, 1,16 MJ; base 12.000 de pași, 92 min, 1,56 MJ.
Limitări
- Textele de antrenare și test sunt documente sintetice românești randate cu degradări de scanare și de poză; pe documente reale scanate performanța trebuie verificată.
- Prima rulare de fine-tuning a fost invalidată (o eroare de configurare a funcției de pierdere în transformers
4.51) și marcată
invalidîn MLflow; rulările raportate folosesc corecția. - Prin API (
/v1/ocr/invoice), pe o factură fotografiată: 31 din 33 de câmpuri corecte (F1 0,939); lanțul de pe server folosește detectorul docTR, deci pe poze rămân aceleași limite ca mai sus.
Recunoaștere facială (face-recognition)
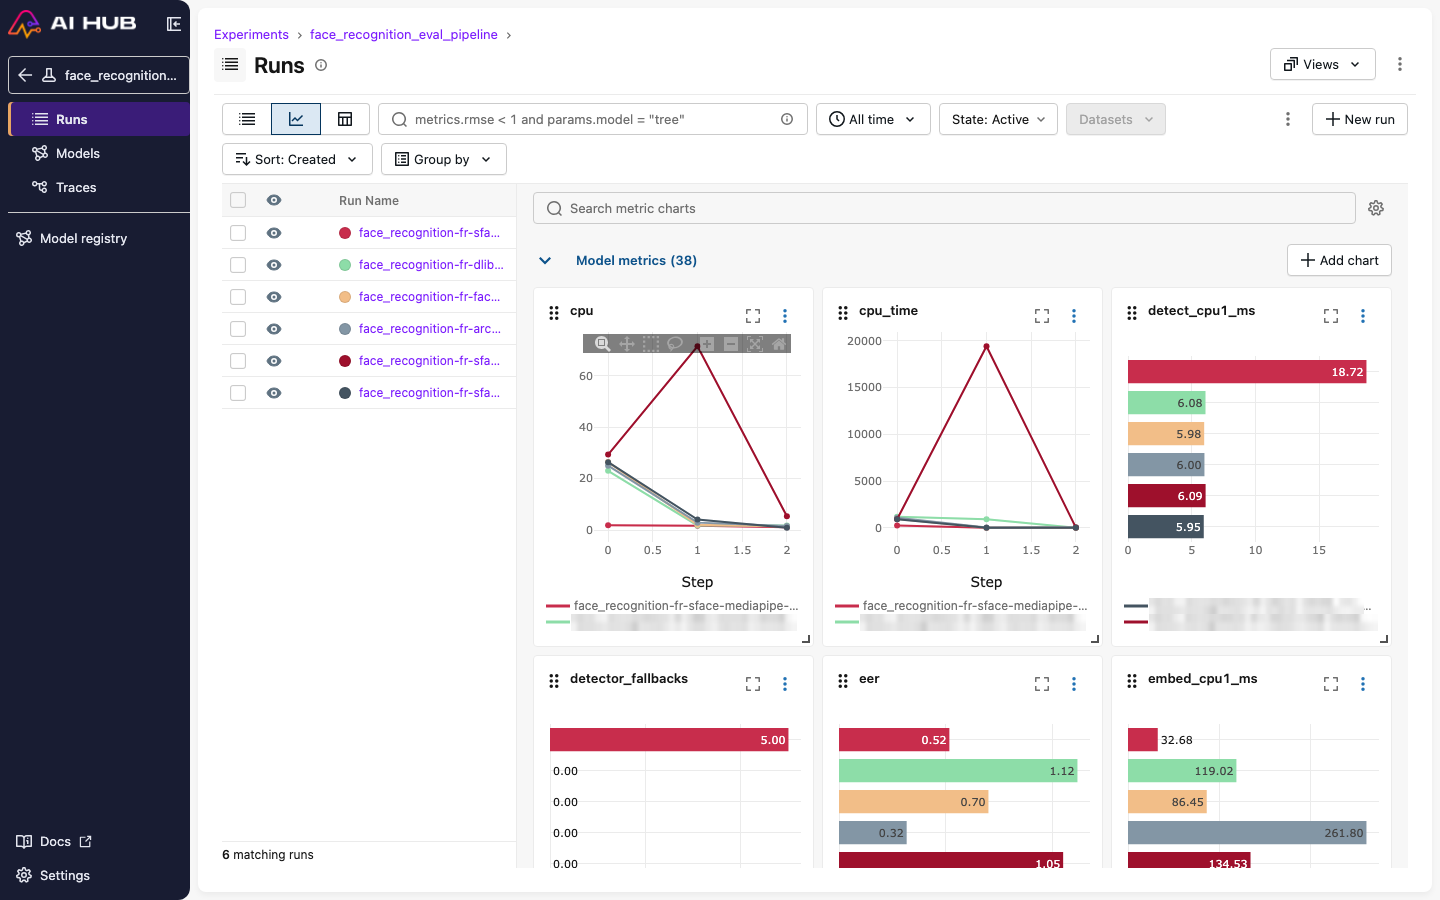
Evaluare pe LFW View 2 (6000 de perechi, 10 fold-uri; pragul ales pe 9 fold-uri, testat pe al zecelea), detecție
YuNet. Pipeline face_recognition_eval_pipeline, experimentul MLflow 12.
| Rulare | Model | Variantă | Acuratețe LFW | EER | TAR@FAR=0,1% | CPU 1 fir / față | A40 batch 64 | Energie A40 / față | Mărime |
|---|---|---|---|---|---|---|---|---|---|
fr-sface |
SFace fp32 | edge / mobil | 99,27% ± 0,38 | 0,97% | 98,53% | 29,6 ms | 2841 fețe/s | 69,5 mJ | 36,9 MB |
fr-sface-mediapipe-align |
SFace, aliniat ca în browser | edge | 99,48% ± 0,26 | 0,52% | 99,07% | 32,7 ms | 2730 fețe/s | 68,0 mJ | 36,9 MB |
fr-sface-int8 |
SFace int8 | edge | 99,15% ± 0,53 | 1,05% | 98,47% | 134,5 ms | – | – | 9,4 MB |
fr-dlib-resnet |
dlib ResNet-29 | CPU | 98,92% ± 0,31 | 1,12% | 92,10% | 119,0 ms | – | – | 30,2 MB |
fr-facenet-vggface2 |
facenet InceptionResnetV1 | data center | 99,45% ± 0,36 | 0,70% | 98,10% | 86,4 ms | 1008 fețe/s | 122,2 mJ | 106,7 MB |
fr-arcface-r100 |
ArcFace LResNet100E-IR | data center | 99,67% ± 0,22 | 0,32% | 99,53% | 261,8 ms | 393 fețe/s | 588,1 mJ | 248,9 MB |
Alegeri: SFace pentru mobil/edge (rulează și în browser, 41 ms/față), ArcFace R100 pentru data center (cea mai bună precizie, de ~9 ori mai multă energie pe față). Embedding-ul calculat în browser și cel de pe server au similaritatea cosinus 0,985 pe aceeași fotografie.
Recunoașterea mimicii feței – Face Mask (face-mask)
Date: „Face Mask Detection” (Kaggle, CC0), 853 de imagini, clasele cu mască / fără mască / mască purtată incorect,
împărțire 70/15/15 pe imagini. Pipeline face_mask_pipeline (mask_crops_loader → mask_trainer → mask_evaluator),
25 de epoci, cost logat pe fiecare epocă.
| Rulare | Metodă | Acuratețe | Macro-F1 | CPU 1 fir | Energie A40 / decupaj | Energie / epocă |
|---|---|---|---|---|---|---|
mask-zs-clip-b32 |
zero-shot CLIP (baseline) | 78,54% | 57,57% | 239 ms | 514 mJ | – |
mask-mobilenetv3s-ft-lr1e-03 |
MobileNetV3-Small (mobil) | 97,73% | 90,86% | 8,5 ms | 71 mJ | 281 J |
mask-efficientnetb0-ft-lr3e-04 |
EfficientNet-B0 (servit) | 98,74% | 93,72% | 38,9 ms | 271 mJ | 1040 J |
mask-resnet50-ft-lr1e-04 |
ResNet-50 (data center) | 97,98% | 91,33% | 129,9 ms | 333 mJ | 1479 J |
Mimica (expresiile) este citită în timp real cu blendshapes-urile MediaPipe Face Landmarker (clipit, zâmbet, gură deschisă, sprâncene, încruntare) în demo-ul biometric.
Limitări
Nu există un clasificator propriu de expresii: seturile de expresii faciale găsite (FER2013, AffectNet, RAF-DB, CK+) nu au licență explicită sau sunt doar pentru cercetare. Clasa „mască purtată incorect” are doar 14 exemple de test.
Mimica feței: expresii faciale (face-expression)
Date cu licență permisivă: UIBVFED (660 de imagini cu 20 de avatari sintetici, 7 expresii, CC BY 4.0) și Face
Research Lab London Set (102 adulți reali cu consimțământ, neutru și zâmbet, CC BY 4.0). Pipeline-ul
face_expression_pipeline, împărțire pe identități; două seturi de test separate.
| Rulare | Sintetic (7 clase): acuratețe / macro-F1 | Real (neutru / fericit): acuratețe | CPU 1 fir | Energie A40 / imagine |
|---|---|---|---|---|
| zero-shot CLIP ViT-B/32 (baseline) | 37,37% / 22,23% | 65,56% | 202 ms | 446 mJ |
MobileNetV3-Small (face-expression v1, mobil) |
80,81% / 73,72% | 91,11% | 8,9 ms | 73 mJ |
EfficientNet-B0 (face-expression v2, servit) |
97,98% / 91,90% | 93,33% | 45,6 ms | 281 mJ |
În demo-ul biometric, butonul „Clasifică expresia” trimite cadrul curent la face-expression v2; panoul de mimică
live rămâne pe blendshapes MediaPipe (clipit, zâmbet, gură deschisă, sprâncene, încruntare).
Limitări
Pe fețe reale am validat doar neutru vs fericit; celelalte 5 expresii sunt învățate doar de pe avatari sintetici, deci performanța lor pe oameni reali nu este măsurată (testul sintetic are 3 avatari). Seturile clasice (FER2013, AffectNet, RAF-DB, CK+) nu au fost folosite: fără licență sau doar pentru cercetare.
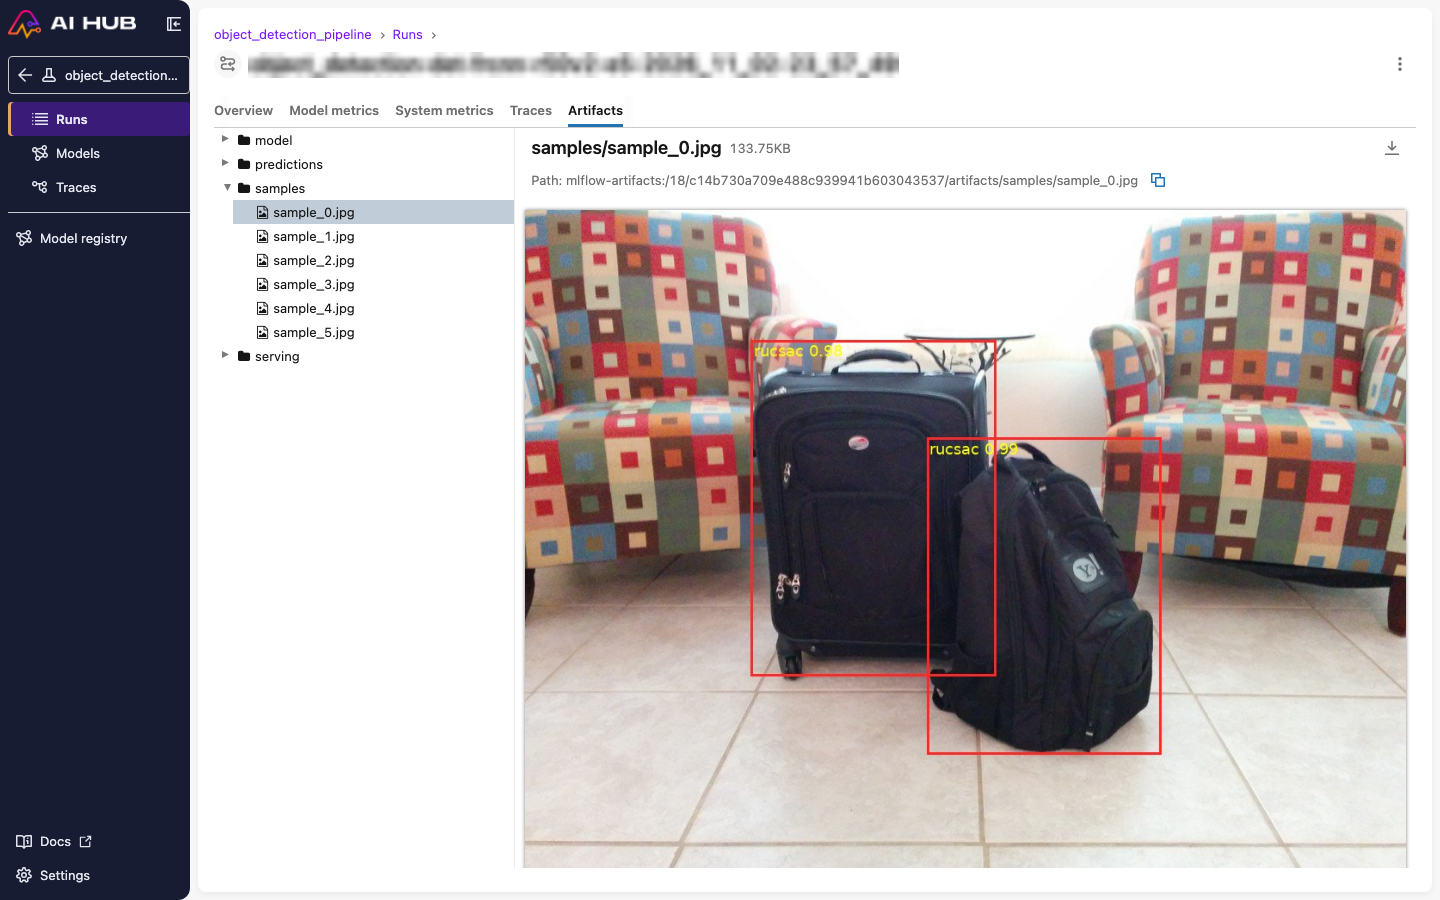
Recunoașterea obiectelor în funcție de parametri (object-detection)
Pipeline-ul object_detection_pipeline (detection_data_loader → detector_trainer → detector_evaluator):
subset Open Images V7 cu 14 clase de produse și obiecte (sticlă, conservă/doză, cutie, cană, ceașcă, pahar de vin,
banană, măr, raft, telefon mobil, laptop, geantă, rucsac, cărucior), 13.855 imagini de antrenare, 2.991 de test.
Detectoare torchvision: ssdlite320_mobilenet_v3_large (mobil), fasterrcnn_mobilenet_v3_large_fpn,
fasterrcnn_resnet50_fpn_v2 (data center). Parametri la inferență: classes (în engleză sau română),
score_threshold, iou_threshold, max_detections; răspunsul conține casetele, eticheta în engleză și română,
scorul și numărul de obiecte pe clasă.
Test: 2.991 de imagini Open Images (protocol cu etichete verificate). Cost măsurat pe A40 (fp16) și pe CPU (8 fire).
| Rulare | Model | mAP@0.5 (14 cl.) | mAP@[.5:.95] | mAP@0.5 (10 cl. COCO) | J/imagine (b1) | J/imagine (b8) | CPU ms/imagine |
|---|---|---|---|---|---|---|---|
det-zs-ssdlite-mbv3 |
SSDlite COCO, zero-shot | 45,2 | 31,9 | 63,2 | 4,36 | 3,01 | 54 |
det-zs-frcnn-mbv3 |
Faster R-CNN MobileNetV3, zero-shot | 51,1 | 36,1 | 71,5 | 5,32 | 1,90 | 279 |
det-zs-frcnn-r50v2 |
Faster R-CNN R50-FPN-v2, zero-shot | 56,5 | 44,8 | 79,1 | 10,92 | 8,18 | 2.174 |
det-ssdlite-mbv3-e40 |
SSDlite fine-tunat — object-detection v1, mobil |
68,1 | 49,5 | 72,4 | 1,74 | 0,90 | 43 |
det-frcnn-mbv3-e15 |
Faster R-CNN MobileNetV3 fine-tunat | 73,1 | 55,0 | 77,6 | 8,13 | 2,14 | 213 |
det-frcnn-r50v2-e5 |
Faster R-CNN R50-FPN-v2 fine-tunat — object-detection v2, GPU |
79,7 | 63,3 | 85,3 | 12,69 | 8,26 | 1.969 |
Fine-tuning-ul aduce clasele fără echivalent COCO (conservă, cutie, raft, cărucior). SSDlite are cu 11,6 puncte mAP
mai puțin decât R50, dar consumă de ~7× mai puțină energie la batch 1 și rulează pe CPU în 43 ms. Prin API, aceeași
imagine dă rezultate diferite după parametri (de ex. classes, score_threshold).
Limitări
Imaginile sunt fotografii generale Open Images (Flickr), nu rafturi de magazin; pentru un client din retail ar fi nevoie de un set propriu, etichetat în Data Studio. Open Images nu e adnotat exhaustiv (evaluarea folosește protocolul cu etichete verificate). API-ul servește varianta mobilă (v1).
Identificarea sensului unui text
gemma-ro-extraction (Gemma 3 4B + LoRA r64) extrage JSON structurat din 14 familii de documente românești, inclusiv
seria, numărul, datele, părțile, pozițiile și totalurile unei facturi. sentiment-ro dă tonul mesajului.
| Model | F1 curat | F1 zgomot OCR (n3) | JSON valid |
|---|---|---|---|
| Gemma 3 1B, neantrenat | 0,528 | 0,363 | 127/140 |
| Gemma 3 4B, neantrenat | 0,890 | 0,848 | 140/140 |
| Gemma 3 12B, neantrenat | 0,918 | – | 138/140 |
4B LoRA r64 (gemma-ro-extraction v1) |
0,949 | 0,944 | 140/140 |
| 12B LoRA r16 | 0,941 | 0,929 | 140/140 |
Sentiment (sentiment-ro, XLM-RoBERTa large, Apache-2.0): LaRoSeDa 98,73%, RoSent 95,70%, SST-2 (en) 89,22%;
pe LaRoSeDa precizie 0,989, sensibilitate 0,986, specificitate 0,989.
Anomalii la senzori și analiză predictivă
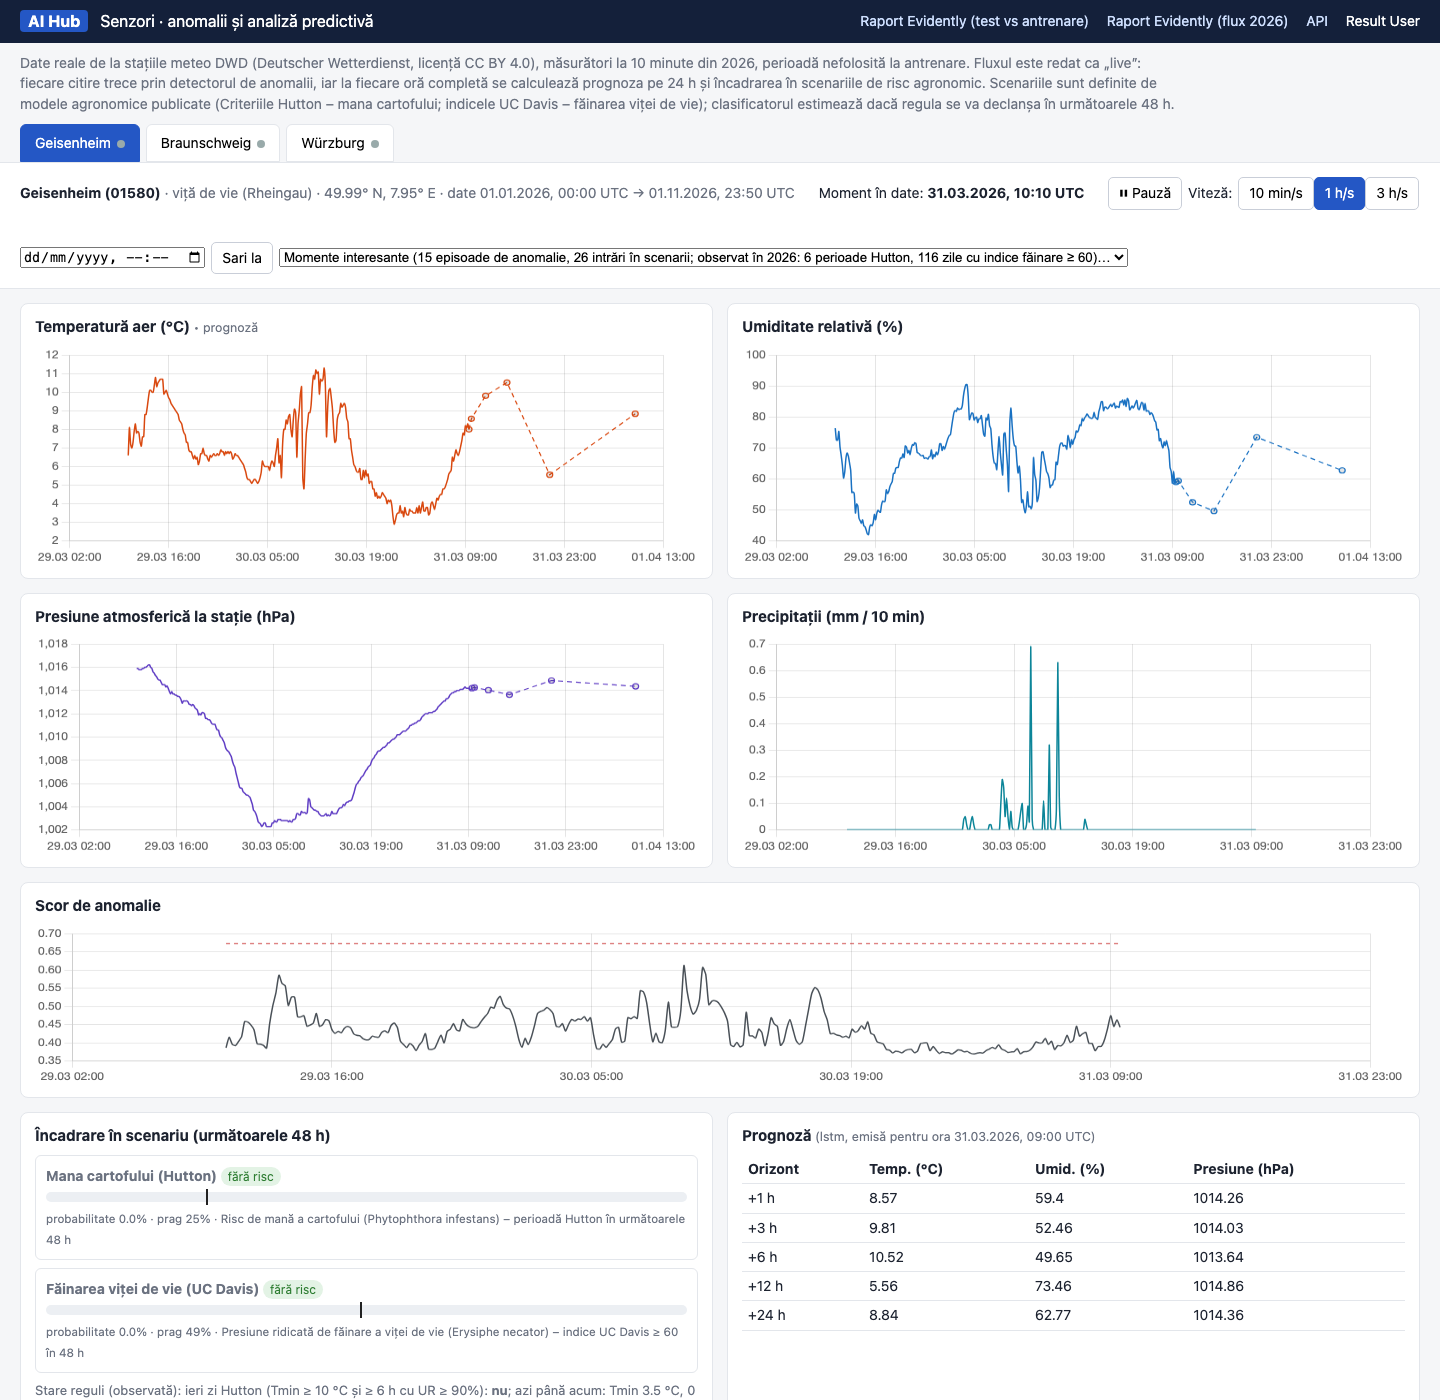
Date reale DWD (Germania, CC BY 4.0) de la 3 stații agro-meteo, la 10 minute: temperatură, umiditate, presiune, punct de rouă, temperatură la 5 cm, precipitații. Antrenare 2010–2021, validare 2022–2023, test 2024–2025; 2026 redat ca flux „live”. Scenariile (următoarele 48 h): mana cartofului (Criteriile Hutton) și făinarea viței de vie (indicele UC Davis, Erysiphe necator, o ciupercă), exact tipul de exemplu din C.4.
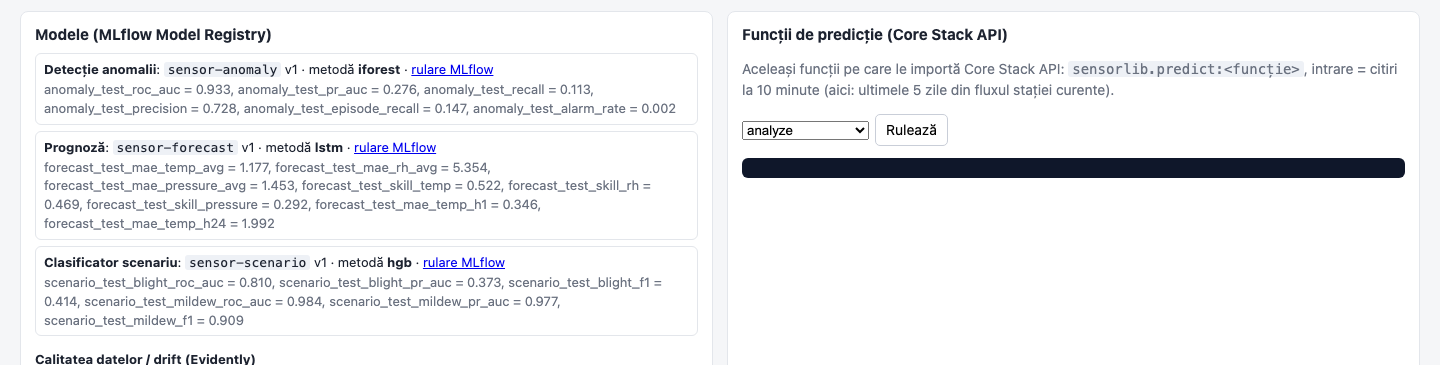
| Model înregistrat | Metodă | Rezultat pe test 2024–2025 |
|---|---|---|
sensor-anomaly |
Isolation Forest, 7 trăsături | ROC-AUC 0,933, PR-AUC 0,276, precizie 0,73 la rata de alarmă 0,2%; recall ploaie 0,81 |
sensor-forecast |
LSTM, context 72 h | MAE temp. 1,18 °C, UR 5,35%, presiune 1,45 hPa; skill față de persistență 0,52 / 0,47 / 0,29 |
sensor-scenario |
HistGradientBoosting | mană ROC-AUC 0,81, F1 0,41; făinare ROC-AUC 0,98, F1 0,91 |
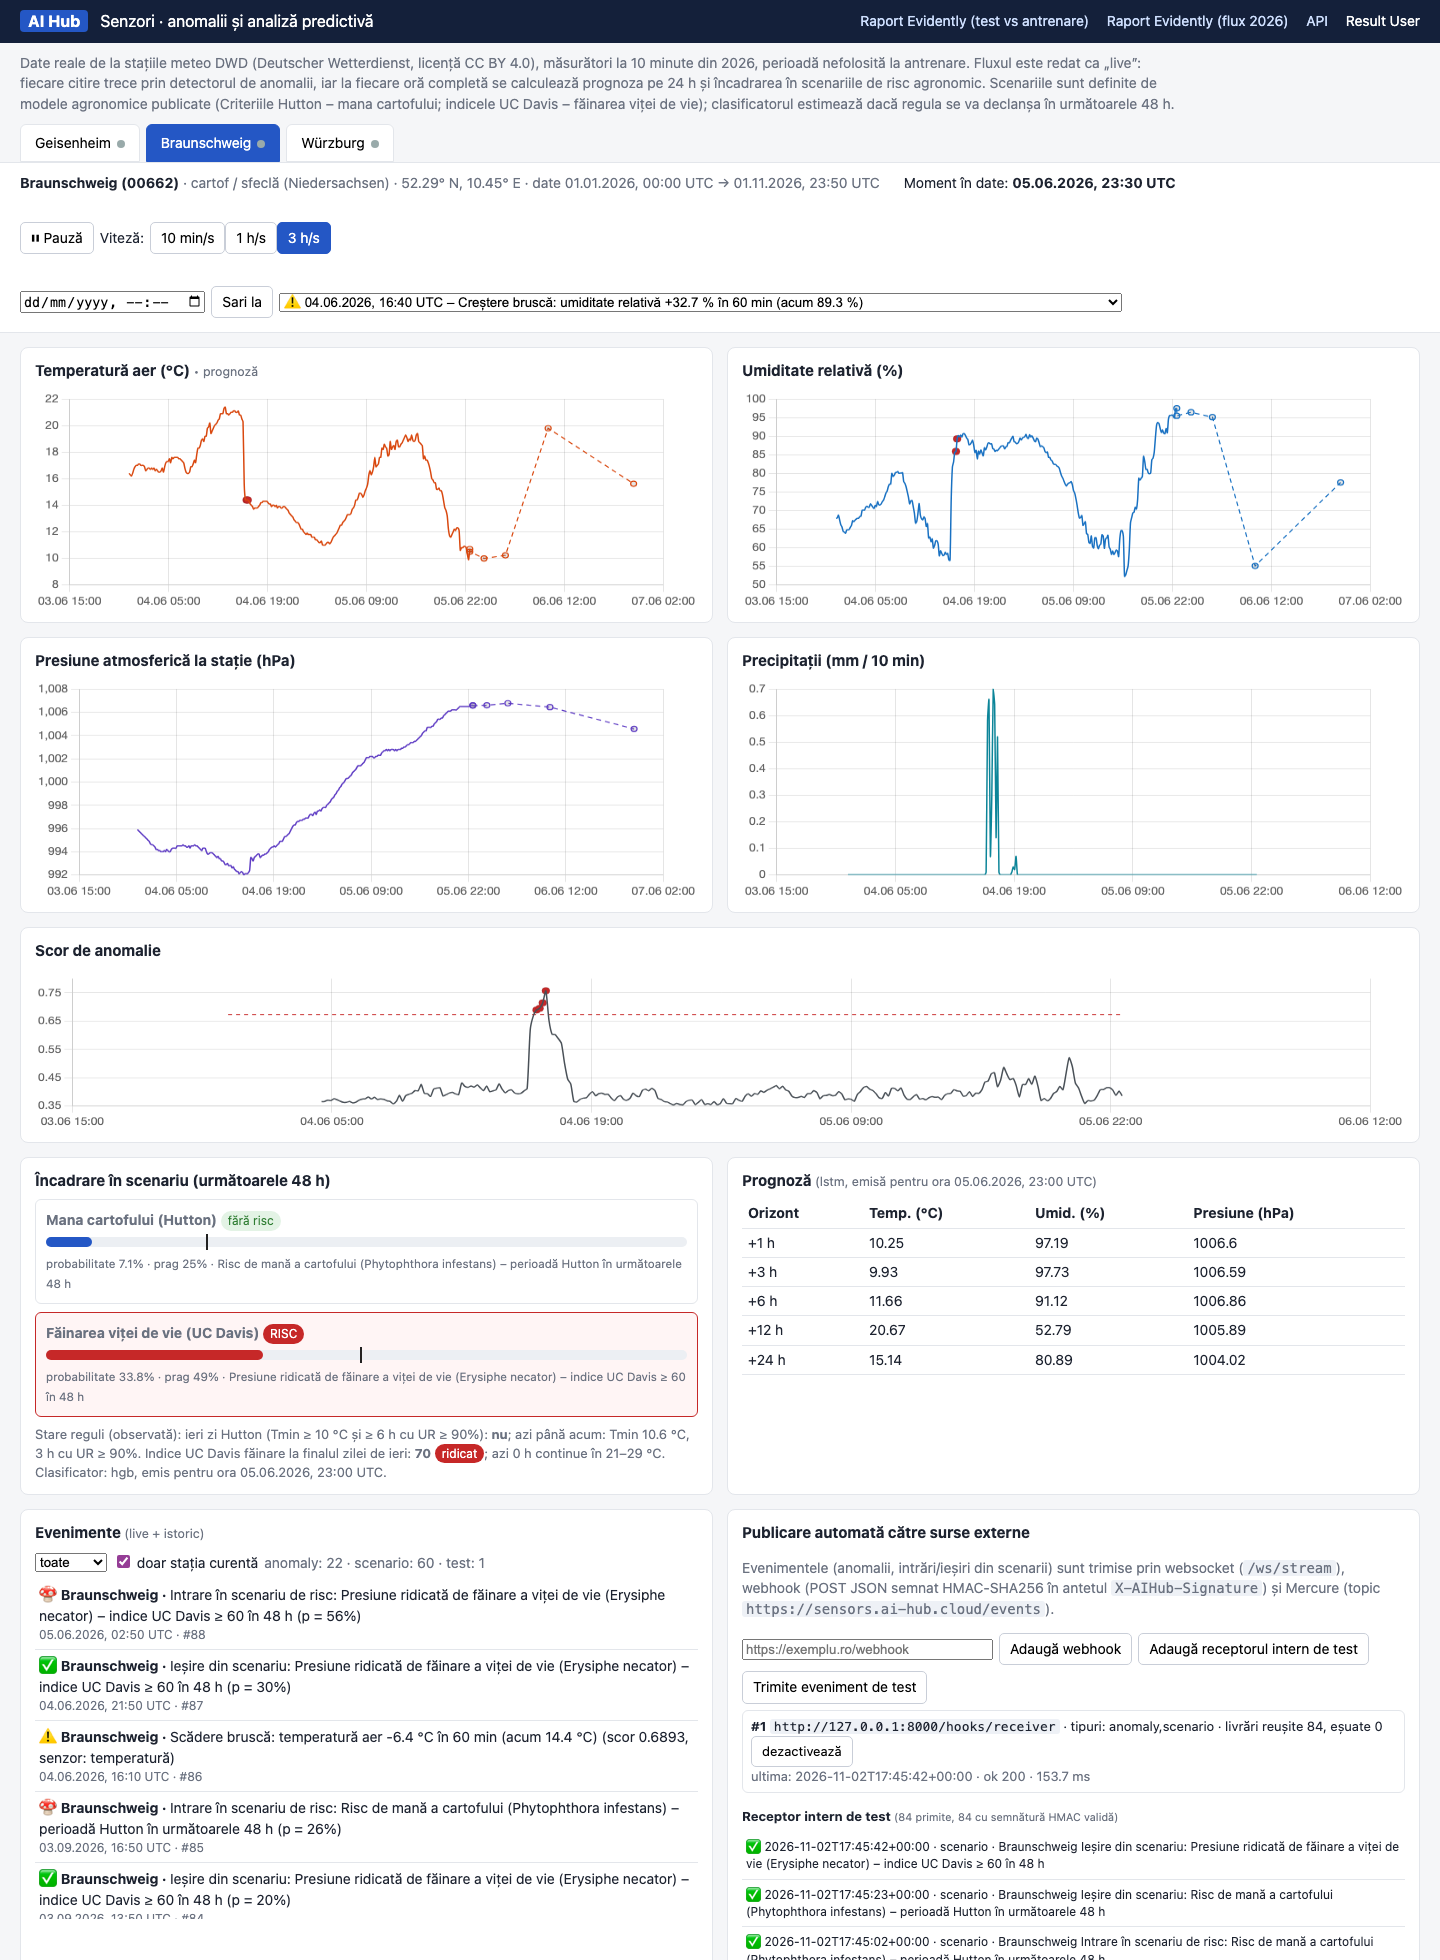
Exemplul din C.4, pe date reale: Braunschweig, 04.06.2026, 16:10 UTC – „Scădere bruscă: temperatură aer −6,4 °C în 60 min”, urmată de intrarea în scenariul „făinare – presiune ridicată”.
Dashboard-ul sensors.onprem.ai-hub.cloud (Instrumente → Senzori; roluri: Result User,
Project Admin, Training Operator, ML Model Developer) redă cele 3 stații ca flux live: fiecare citire trece prin
sensor-anomaly, iar la fiecare oră completă rulează sensor-forecast și sensor-scenario. Evenimentele (anomalii,
intrări și ieșiri din scenarii) se publică automat prin websocket, webhook semnat HMAC și Mercure.
Limitări
Etichetele de scenariu provin din reguli agronomice publicate aplicate pe măsurători, nu din observații de boală în câmp. Creșterile lente de presiune (≥ 3,6 hPa în 3 h) sunt slab prinse de detectorul de anomalii (recall ≤ 1,6%); tendința de presiune intră în clasificatorul de scenariu. Datele sunt din Germania (nu s-au găsit date agro-meteo românești cu licență permisivă).
Metodele tehnologice
| Metodă C.4 | Implementare | Varianta mobilă | Varianta data center GPU | Stare |
|---|---|---|---|---|
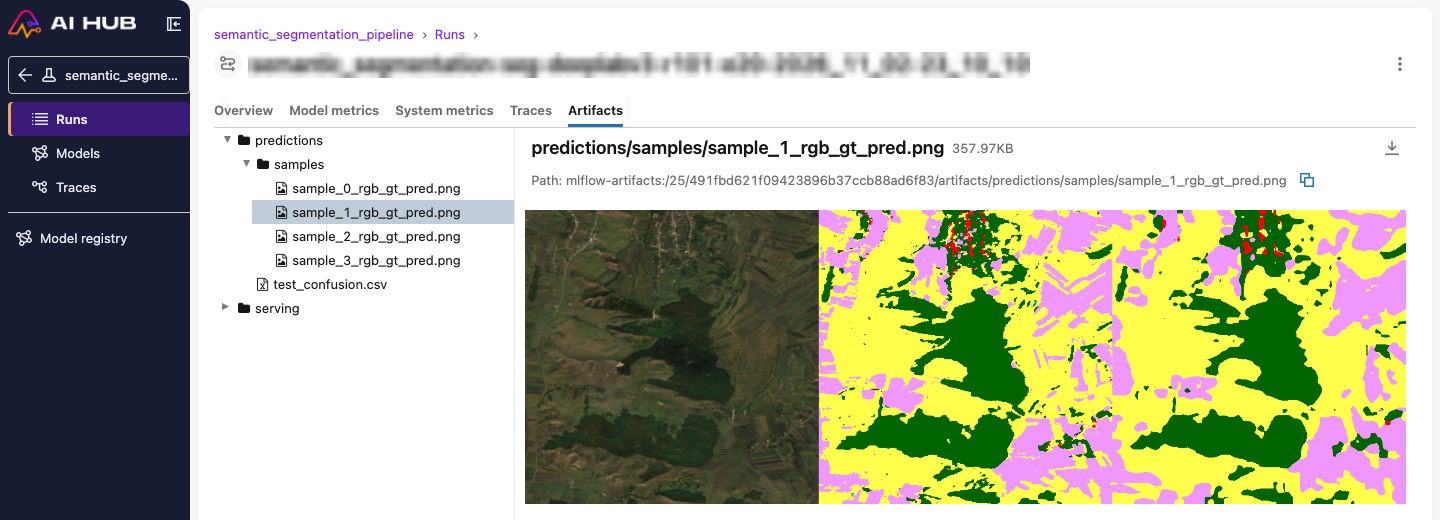
| Rețea convolutiv-asociativă de segmentare semantică raster | semantic-segmentation: acoperirea terenului din Sentinel-2 (11 clase ESA WorldCover, 12 plăci din România, 708 pătrate de test) |
v1 LR-ASPP MobileNetV3: mIoU (7 clase) 72,4, 1,04 J/pătrat, 105 ms CPU | v2 DeepLabV3-ResNet101: mIoU 73,9, 3,71 J/pătrat, 1.090 ms CPU | funcțional |
| Segmentare non-semantică | instance-segmentation: măști agnostice la clasă, cu prompt casetă/punct (500 de imagini COCO) |
v1 MobileSAM: mIoU (prompt casetă) 79,6, 17,8 J/imagine | v2 SAM ViT-H: mIoU 81,8, 159,4 J/imagine (ViT-B: 77,8, 51,1 J) | funcțional |
| Urmărire și flux optic (fluxuri video), data center GPU | detecție CNN + flux optic RAFT în tracker (aplicația video, tab-ul Flux optic) | – | RAFT small: 48 ms și 9,1 J pe pereche, 17,8× mai rapid decât CPU; IDF1 46,1 → 49,1 pe MOT17 | funcțional |
| Compresie entropică în spații latente sferice (recunoaștere de indivizi, inclusiv facială) | SFace și ArcFace: embedding normalizat L2 pe hipersferă, similaritate cosinus | SFace: 29,6 ms CPU, 69,5 mJ/față | ArcFace R100: EER 0,32%, 588 mJ/față | funcțional |
Aceleași perechi mobil / data center sunt măsurate și la detecție (SSDlite vs Faster R-CNN R50), la OCR (TrOCR-small vs TrOCR-base), la mască și la expresii (MobileNetV3-Small vs EfficientNet-B0).
Limitări
- Etichetele WorldCover sunt produsul unui model (~77% acuratețe raportată de ESA): mIoU-ul măsoară acordul cu WorldCover; clasele rare în România nu sunt învățate; modelul cere 4 benzi Sentinel-2.
- Modelele SAM sunt folosite zero-shot (fără fine-tuning); nu dau eticheta clasei (se combină cu
object-detection).
Aplicația practică a) Analiza supraveghere video
video.onprem.ai-hub.cloud (din portal: Instrumente → Analiză video; roluri: Result User, Project Admin, Training Operator, ML Model Developer). Serviciu cloud pe GPU + client edge pe CPU.
| Metodă C.4 | Unde în aplicație | Stare |
|---|---|---|
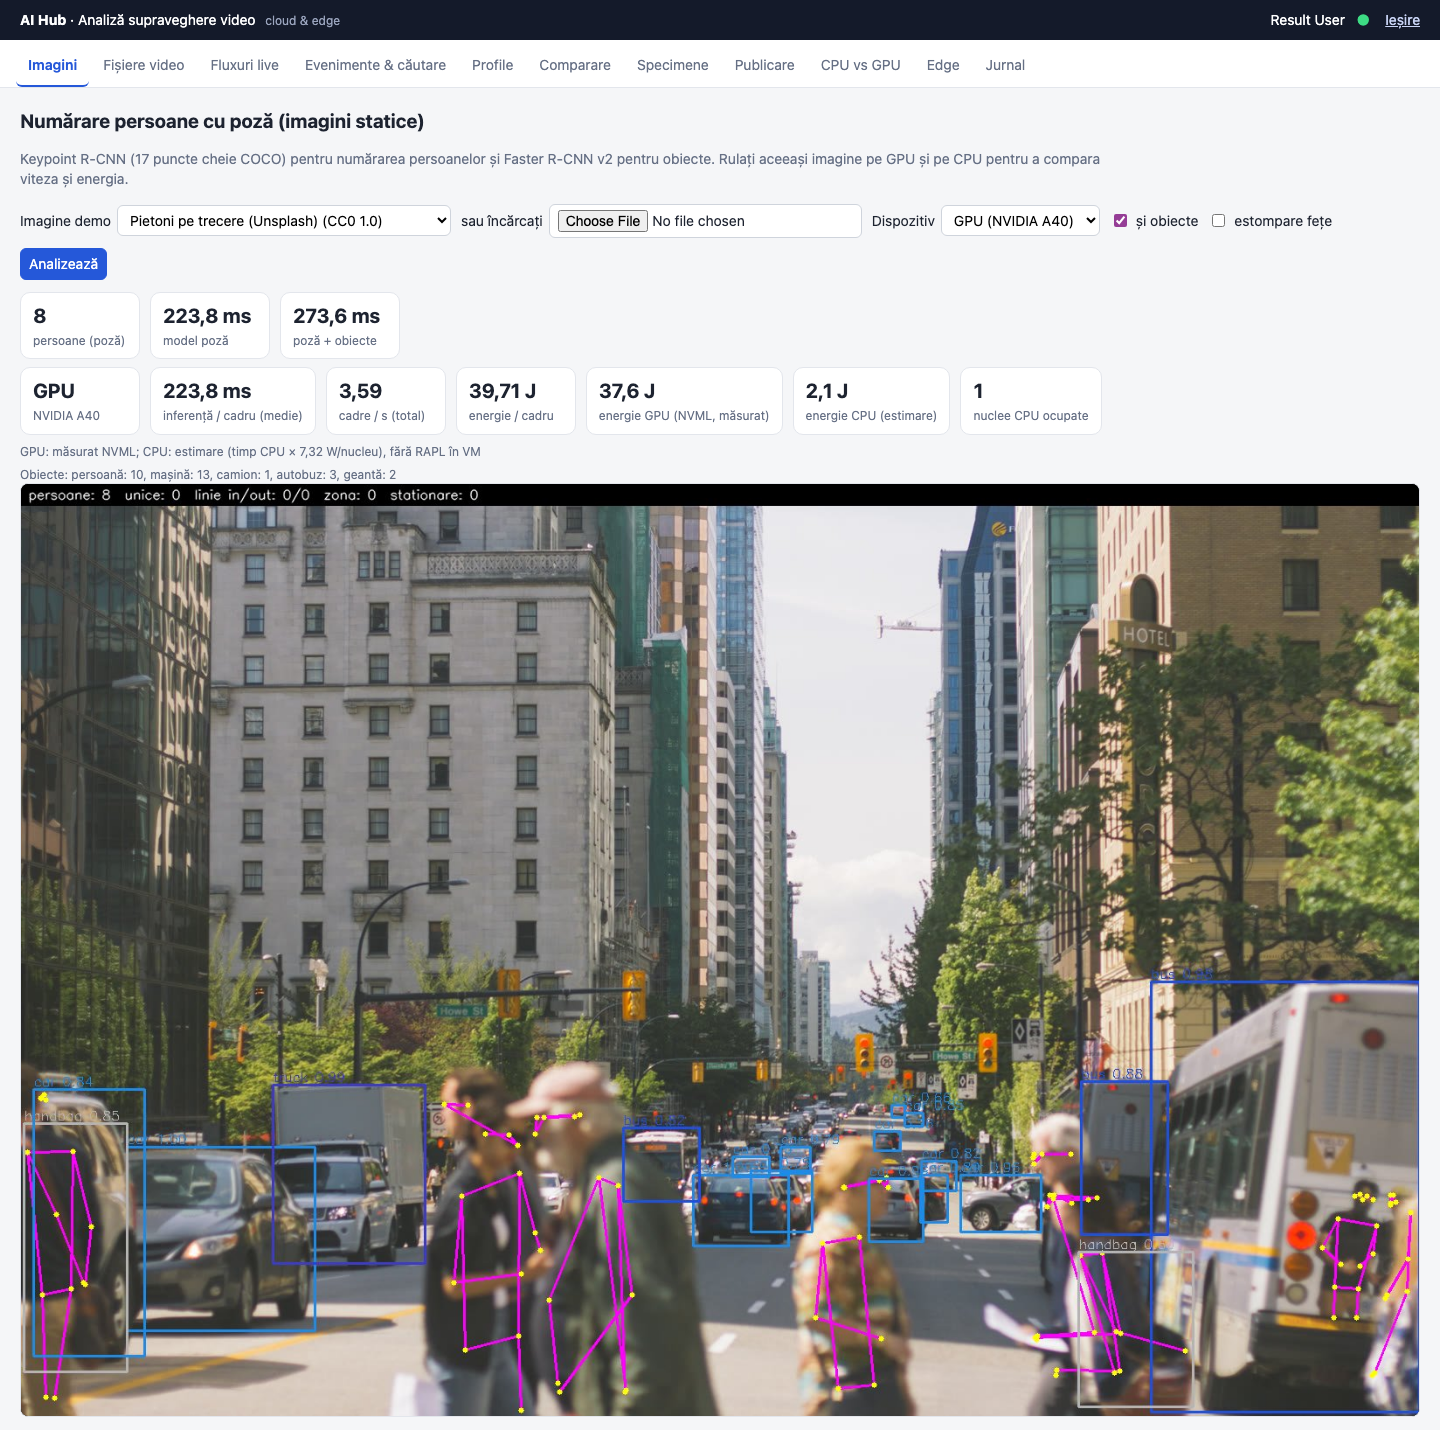
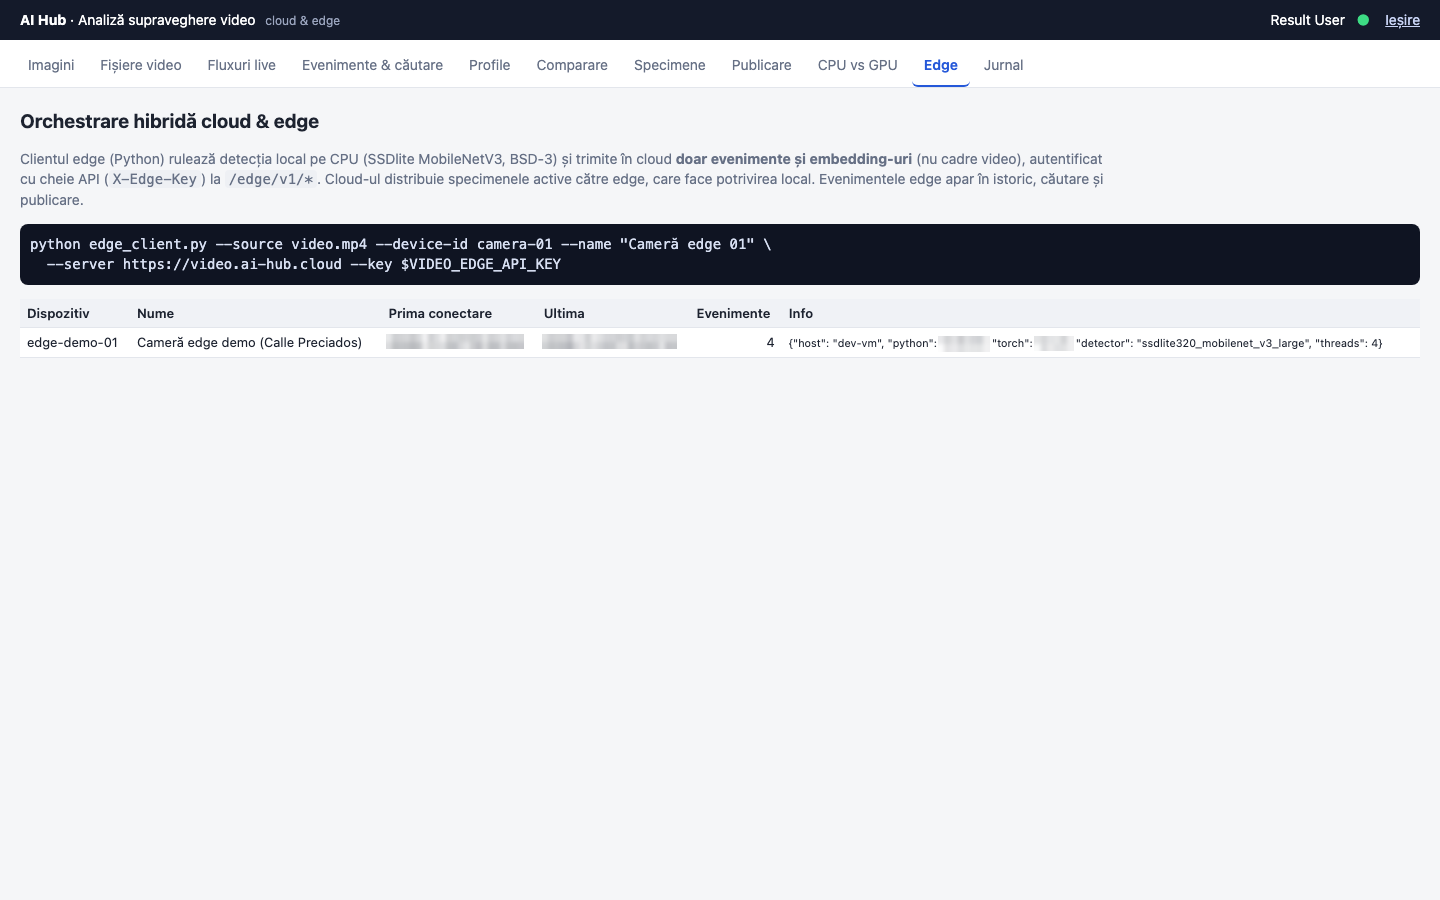
| Orchestrare hibridă cloud & edge, mai multe evenimente, obiecte și tipuri de persoane | tab-ul Edge: dispozitivele edge rulează SSDlite pe CPU și trimit doar evenimente + embedding (19,8 KB de evenimente, 22 MB de cadre rămase local); urmărire pentru 12 clase COCO | funcțional |
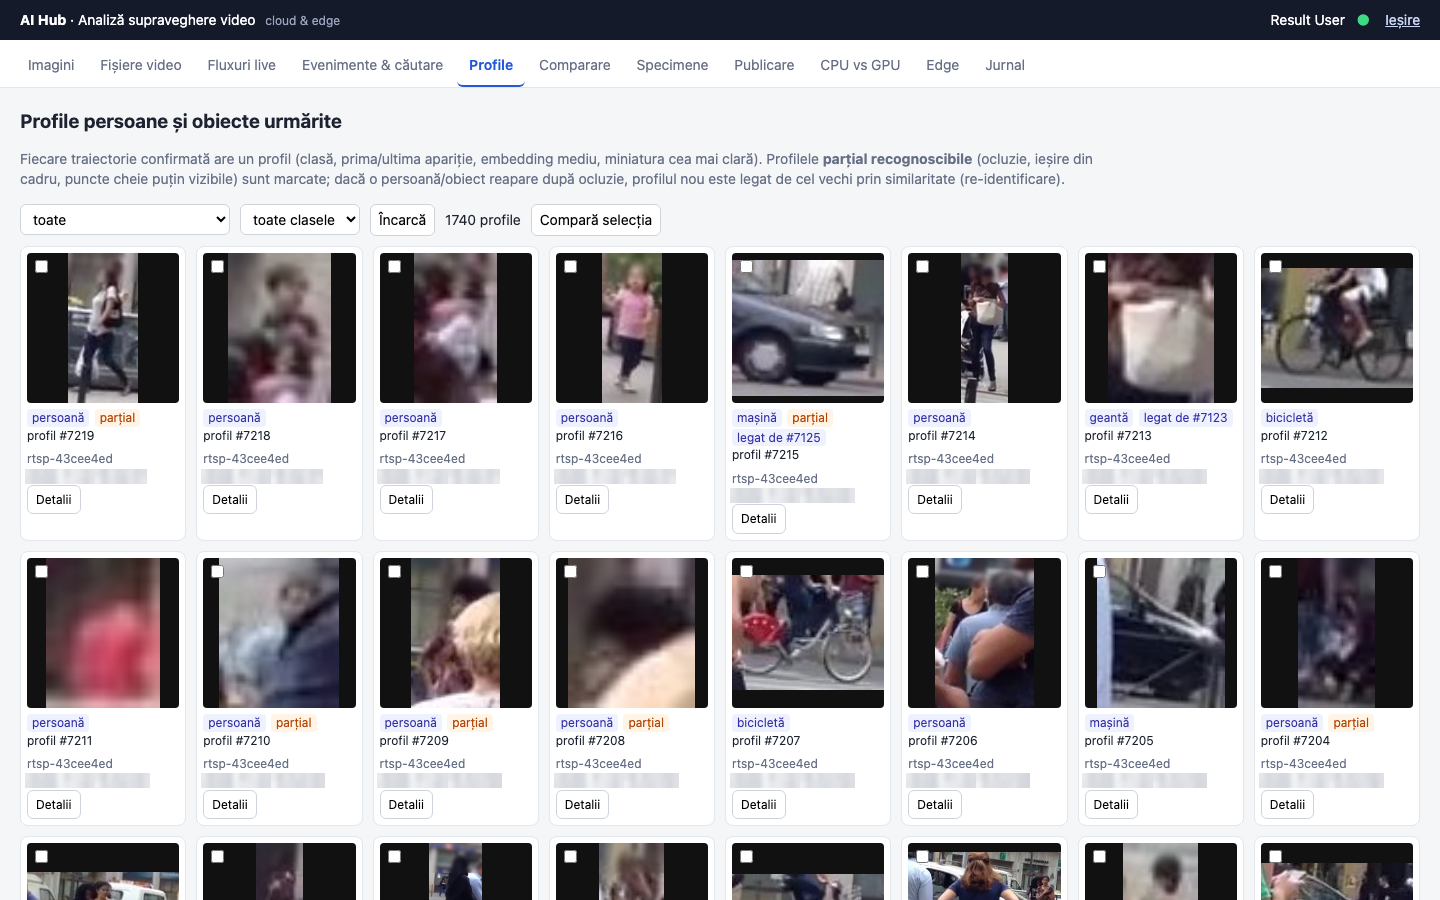
| Gestionarea profilelor persoanelor și obiectelor parțial-recognoscibile | tab-ul Profile: profil per traiectorie, marcaj „parțial” la ocluzie / ieșire din cadru, re-identificare („legat de #…”) | funcțional |
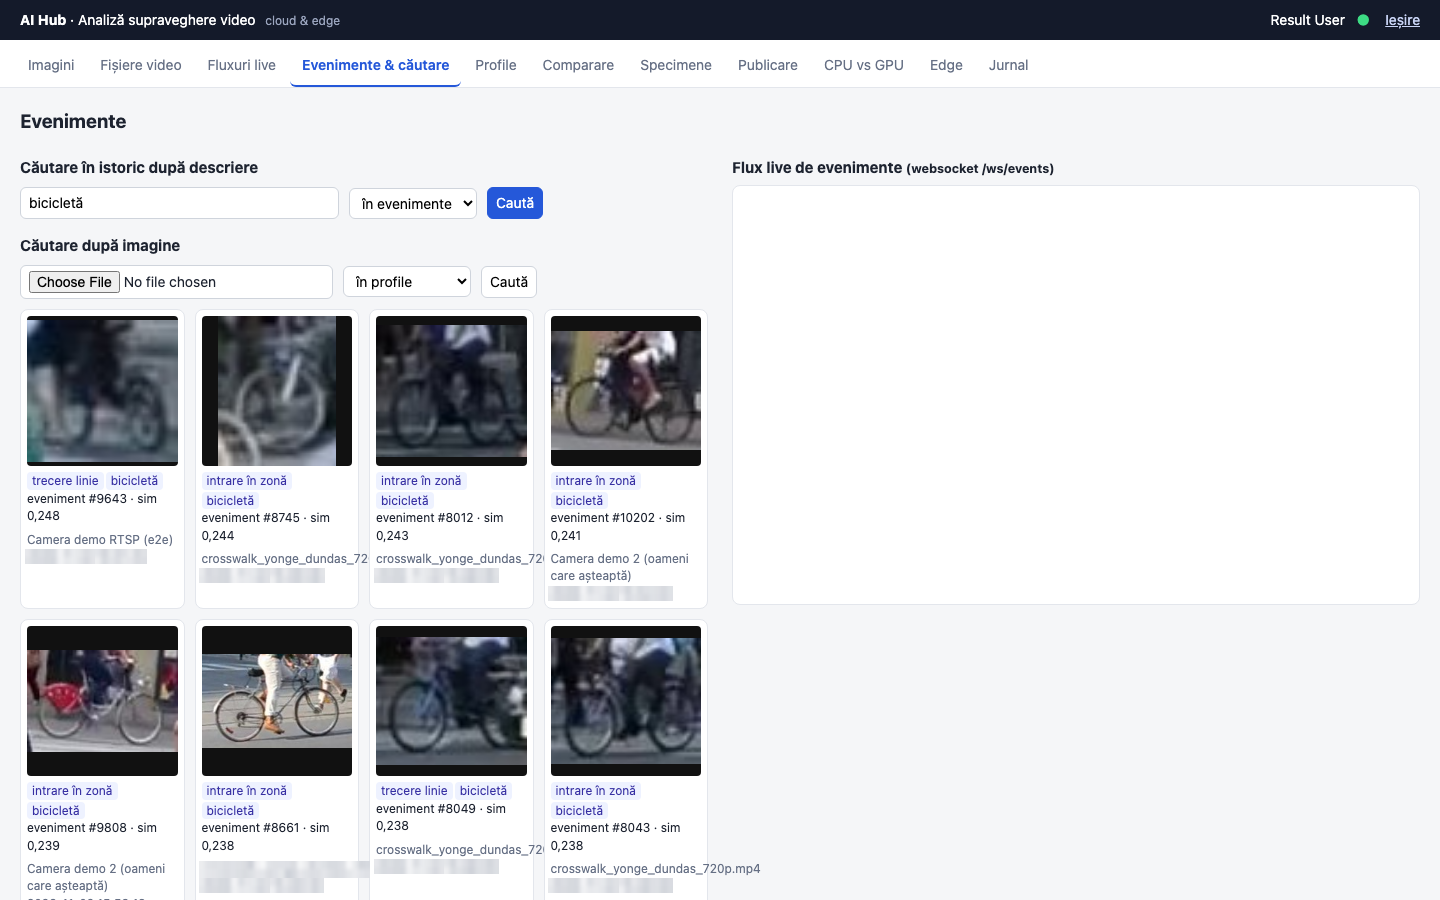
| Căutare în evenimentele istorice după descriere analitică | tab-ul Evenimente & căutare: text multilingv (ex. „bicicletă”, „mașină albă”) comparat cu embedding-urile evenimentelor | funcțional |
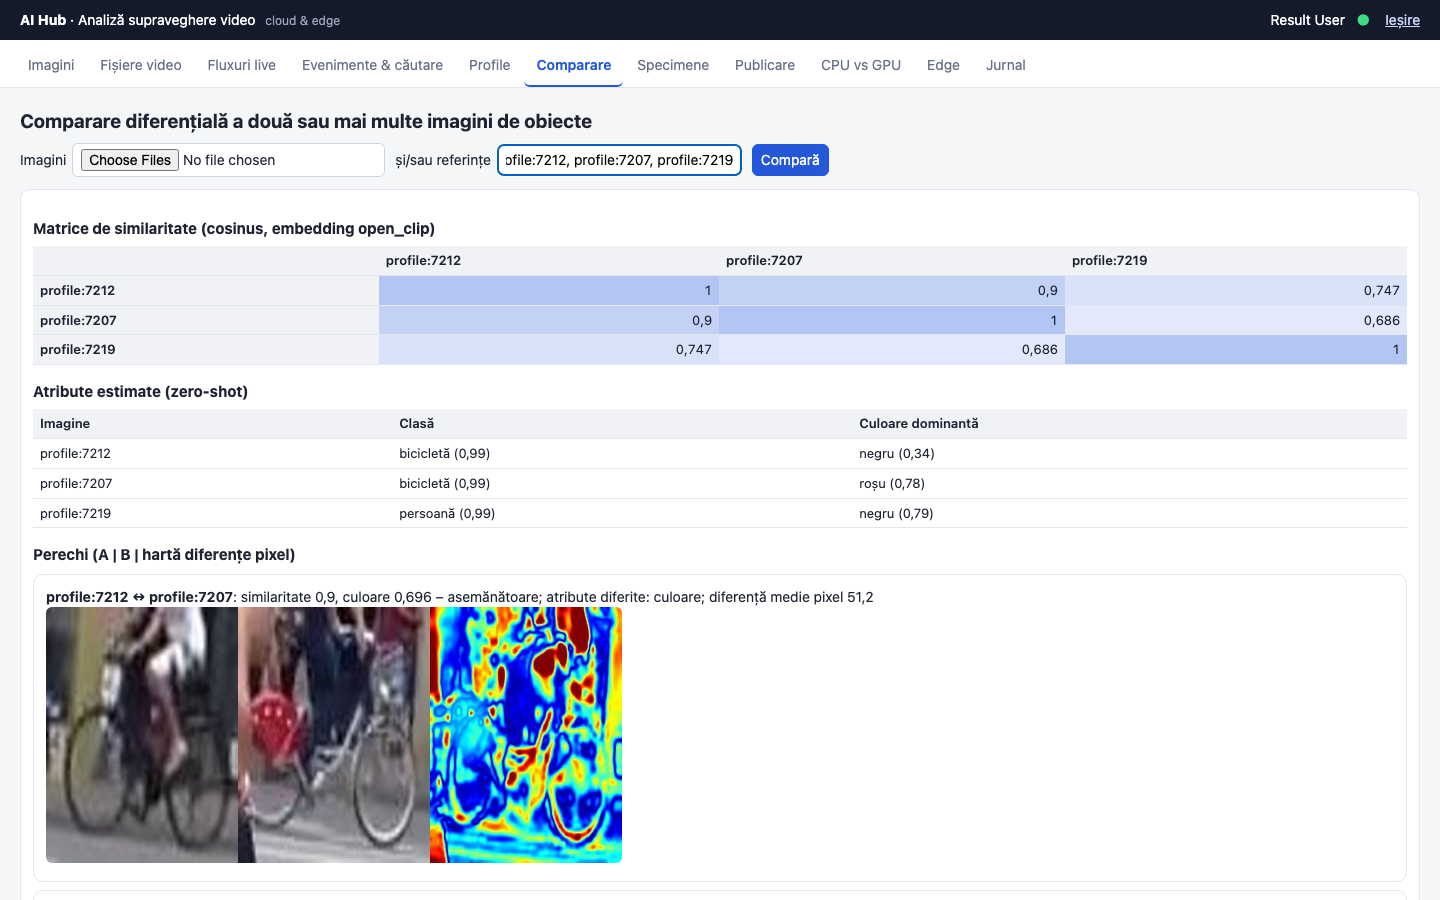
| Compararea diferențială a două sau mai multe imagini | tab-ul Comparare: matrice de similaritate, culoare, atribute zero-shot, hartă de diferențe pe pixeli | funcțional |
| Căutare în timp real după imagini-specimen | tab-ul Specimene: specimenele active sunt verificate pe fiecare traiectorie live; potrivire 0,899 pe fișier, 0,81 live | funcțional |
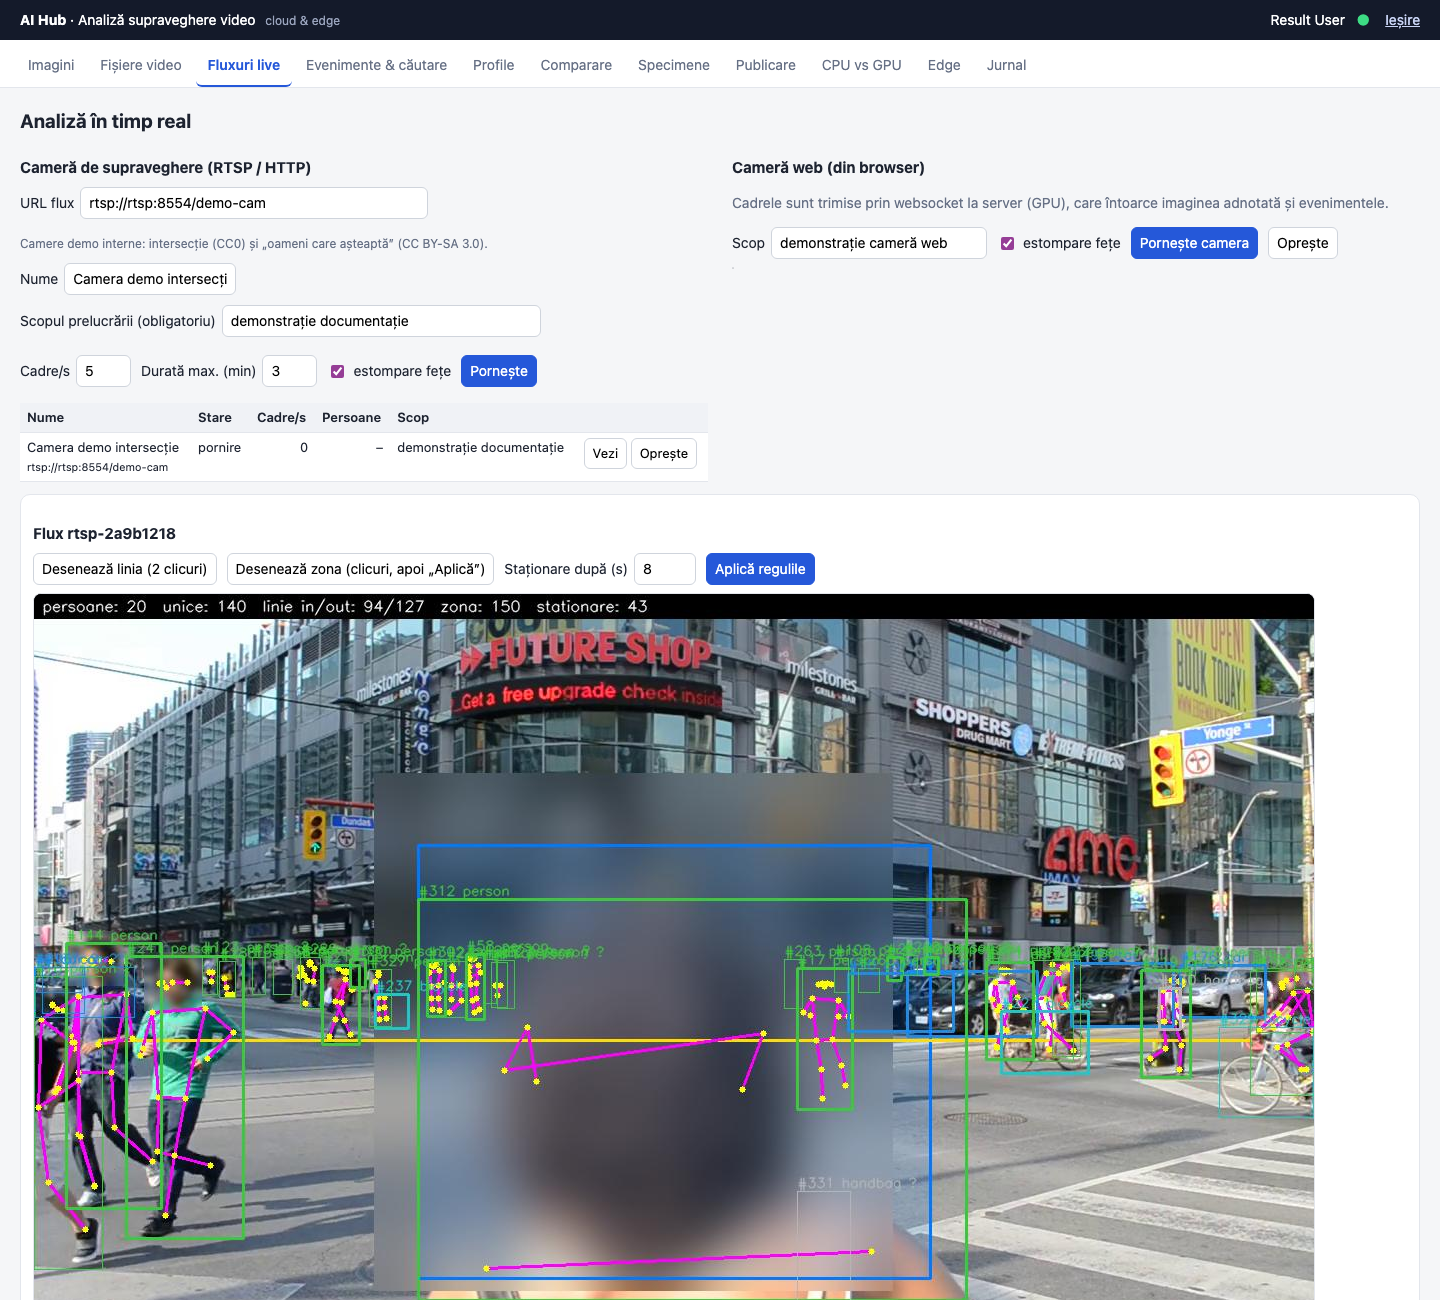
| Analiză pentru fluxuri în timp real, inclusiv camere de supraveghere | tab-ul Fluxuri live: RTSP/HTTP (două camere demo) și camera web prin websocket; 3,7–4,1 cadre/s pe RTSP | funcțional |
| Analiză pentru fișiere video și imagini statice | taburile Imagini și Fișiere video, pe GPU sau CPU | funcțional |
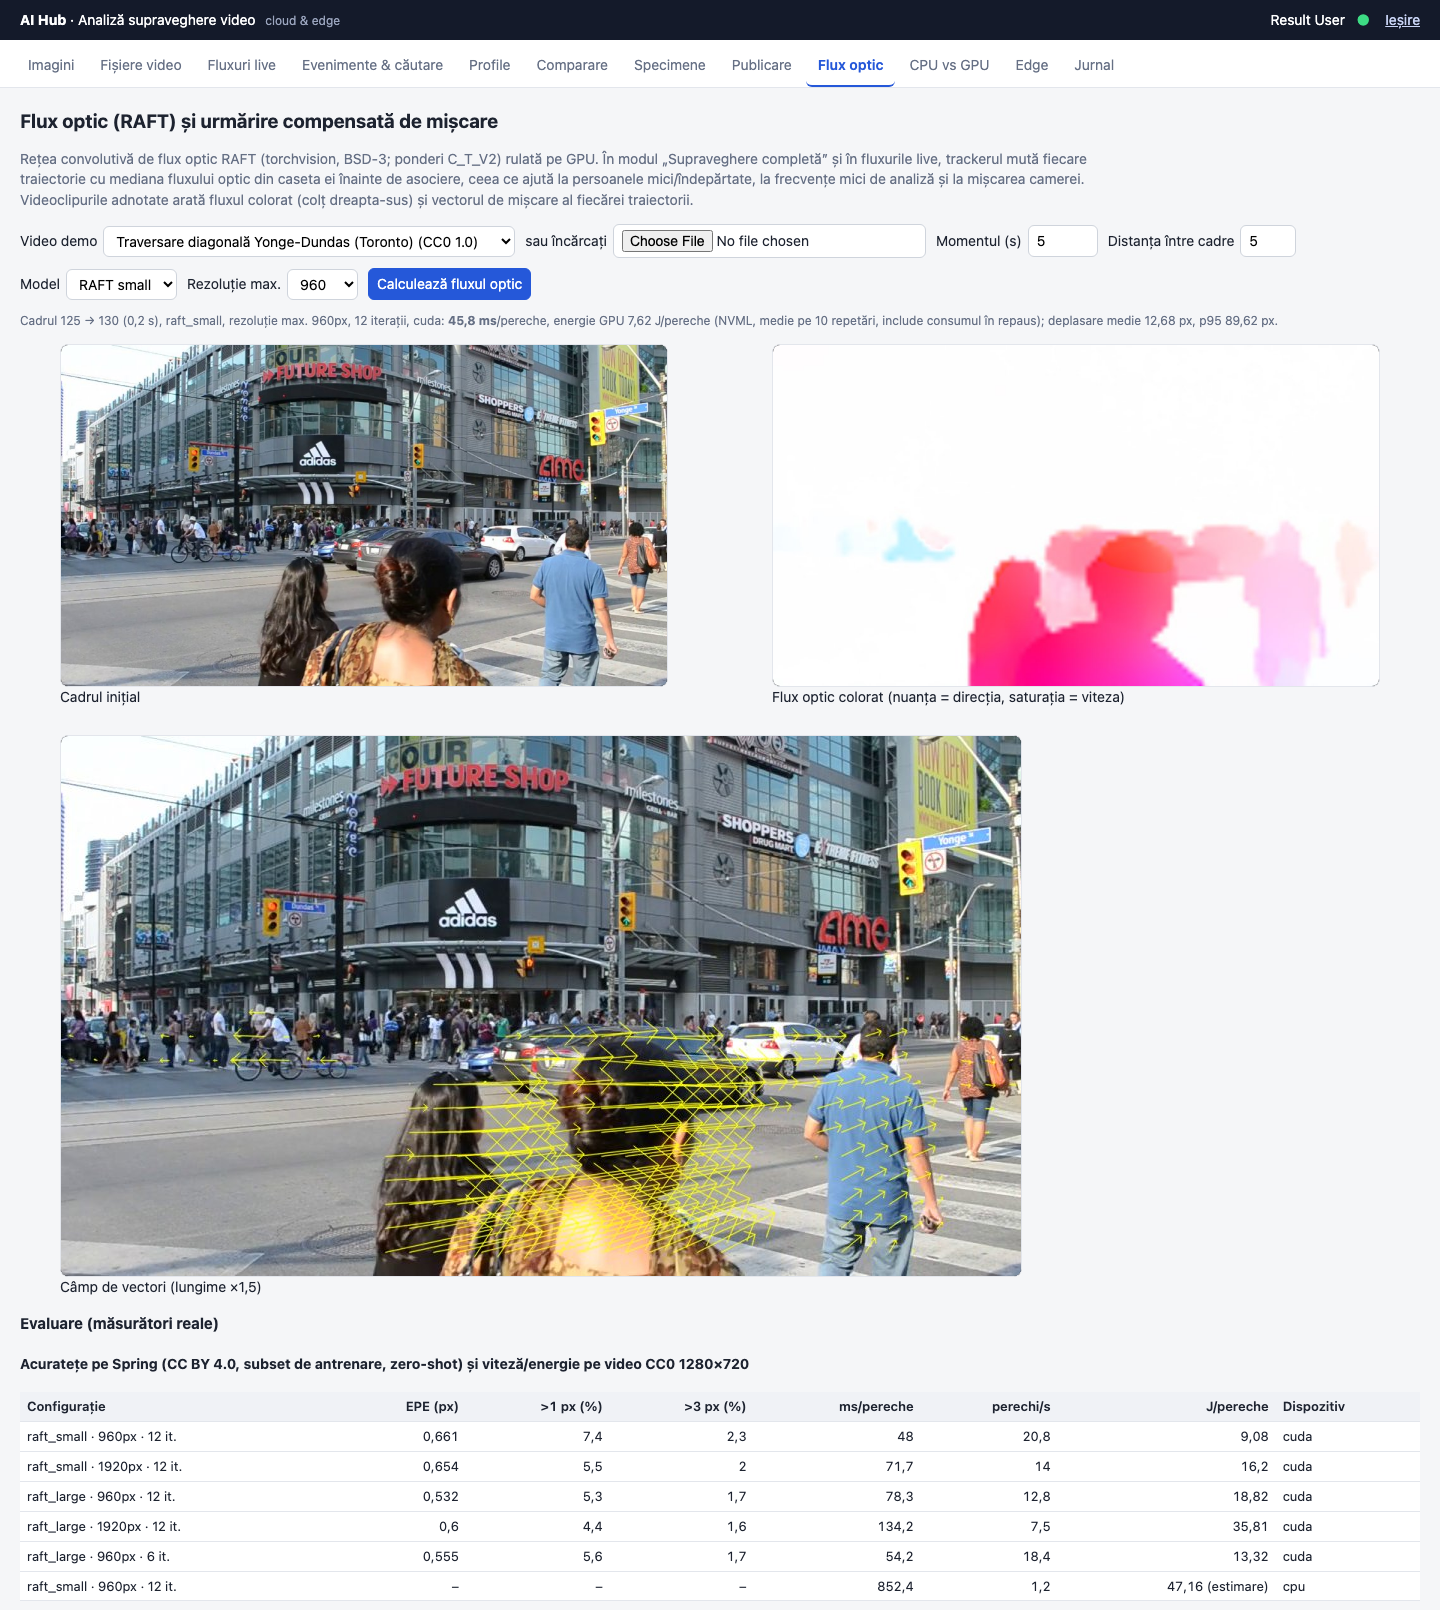
| Urmărire compensată de mișcare (flux optic) | tab-ul Flux optic: harta de flux colorată și câmpul de vectori, cu ms și J; trackerul folosește fluxul RAFT pe GPU | funcțional |
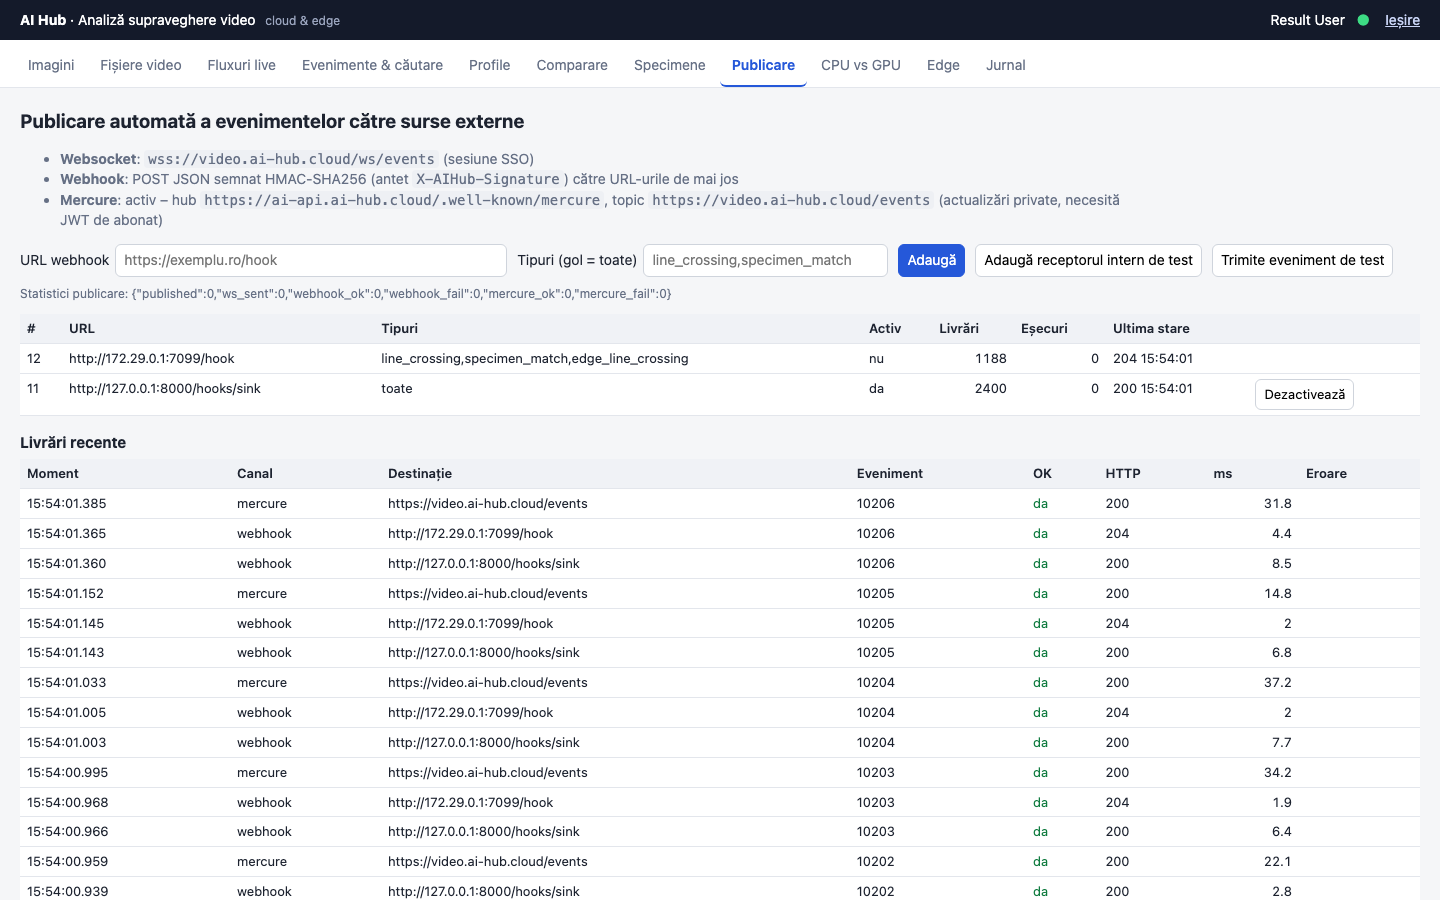
| Publicarea automată a evenimentelor către surse externe | tab-ul Publicare: websocket /ws/events, webhook semnat HMAC-SHA256, Mercure; 1983 de evenimente publicate în testul cap-coadă, 0 eșecuri |
funcțional |
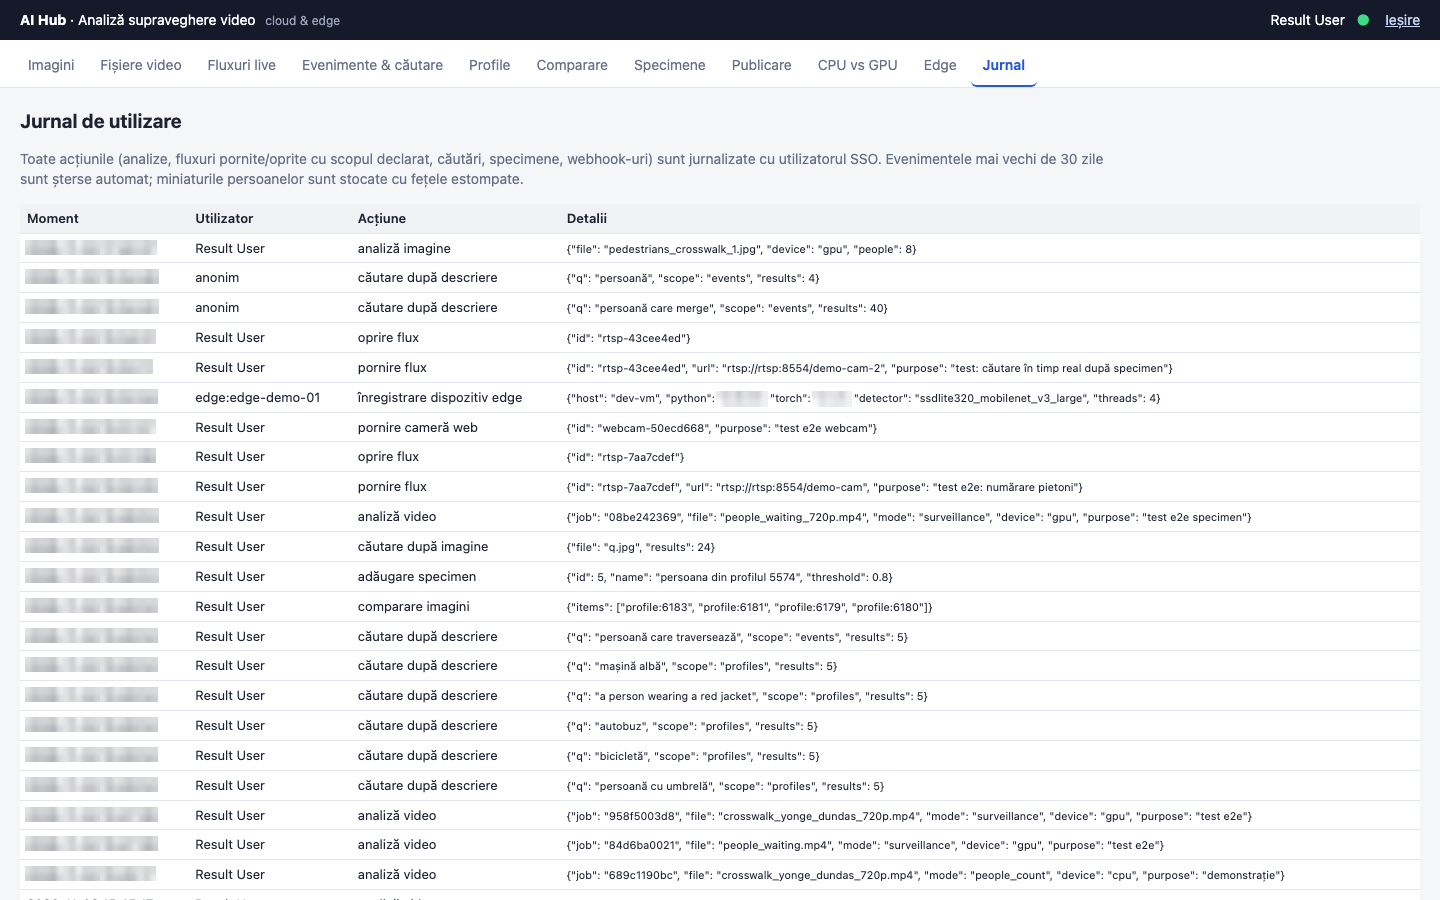
Protecția datelor: miniaturile persoanelor sunt stocate cu fețele estompate; evenimentele mai vechi de 30 de zile se șterg automat; pornirea unui flux cere scopul prelucrării; fiecare acțiune e jurnalizată cu utilizatorul SSO (tab-ul Jurnal).
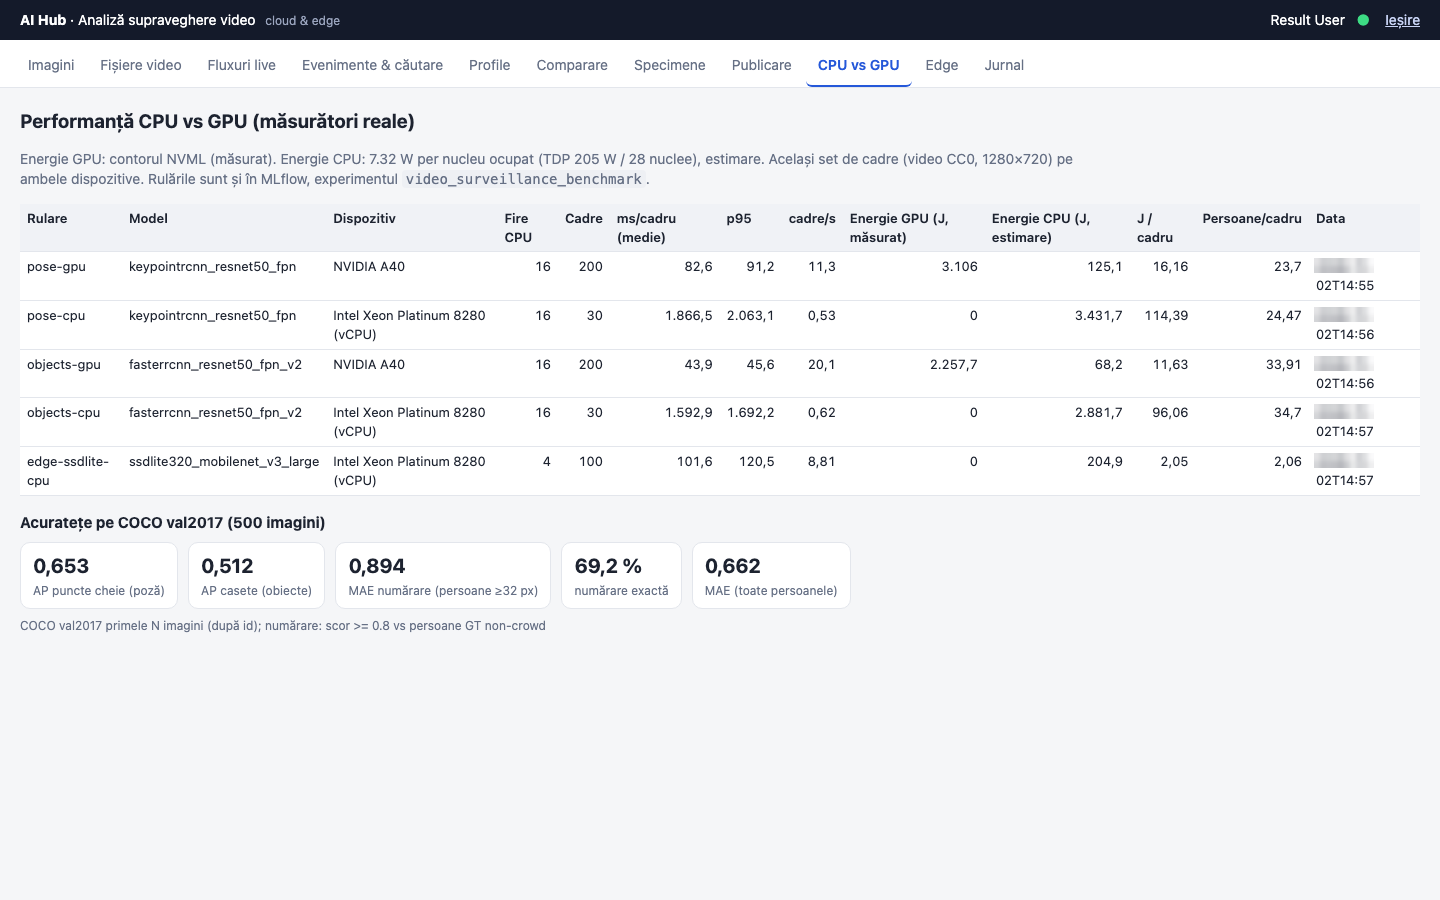
Măsurătoare (MLflow video_surveillance_benchmark) |
ms/cadru | cadre/s | J/cadru |
|---|---|---|---|
| Numărare persoane (poză), GPU A40 | 82,6 | 11,3 | 16,2 |
| Numărare persoane, CPU 16 fire | 1866,5 | 0,53 | 114,4 (estimare) |
| Obiecte, GPU | 43,9 | 20,1 | 11,6 |
| Obiecte, CPU | 1592,9 | 0,62 | 96,1 (estimare) |
| Edge SSDlite, CPU 4 fire | 101,6 | 8,8 | 2,05 (estimare) |
Acuratețe pe COCO val2017 (500 de imagini): AP puncte cheie 0,653, AP casete 0,512, numărare exactă 69,2%.
Flux optic și urmărire (experimentul MLflow video_optical_flow; Spring CC BY 4.0, zero-shot; MOT17 doar pentru
evaluare necomercială):
| Configurație | EPE Spring (px) | ms/pereche | J/pereche |
|---|---|---|---|
| RAFT small, max 960 px (în aplicație) | 0,661 | 48,0 | 9,1 |
| RAFT large, max 960 px | 0,532 | 78,3 | 18,8 |
| RAFT small, CPU 16 fire | – | 852,4 | 47,2 (estimare) |
| Urmărire, 5 cadre/s (implicit în aplicație) | MOTA | IDF1 | HOTA | Schimbări de identitate |
|---|---|---|---|---|
| fără flux | 27,8 | 46,1 | 40,5 | 1343 |
| cu RAFT small | 31,8 | 49,1 | 42,0 | 522 |
Limitări
Re-identificarea și potrivirea după specimen sunt slabe pentru persoane mici (AUC 0,55 la ~69 px, 0,87 la ~330 px); „persoane unice” este o estimare fără adevăr de referință; fluxul optic nu ajută la frecvența completă de cadre (MOTA 29,9 → 29,1) și rulează doar pe GPU; configurația trackerului a fost aleasă pe aceleași secvențe MOT17 pe care raportăm; fluxurile se opresc după cel mult 60 de minute; camera web a fost testată doar scriptat, nu cu o cameră reală. Analiza video folosește PyTorch/torchvision, nu TensorFlow ca exemplul „People counting pose” din planul de test 2023.
Aplicația practică b) Identificare biometrică
bio.onprem.ai-hub.cloud (din portal: Instrumente → Identificare biometrică; toate rolurile).
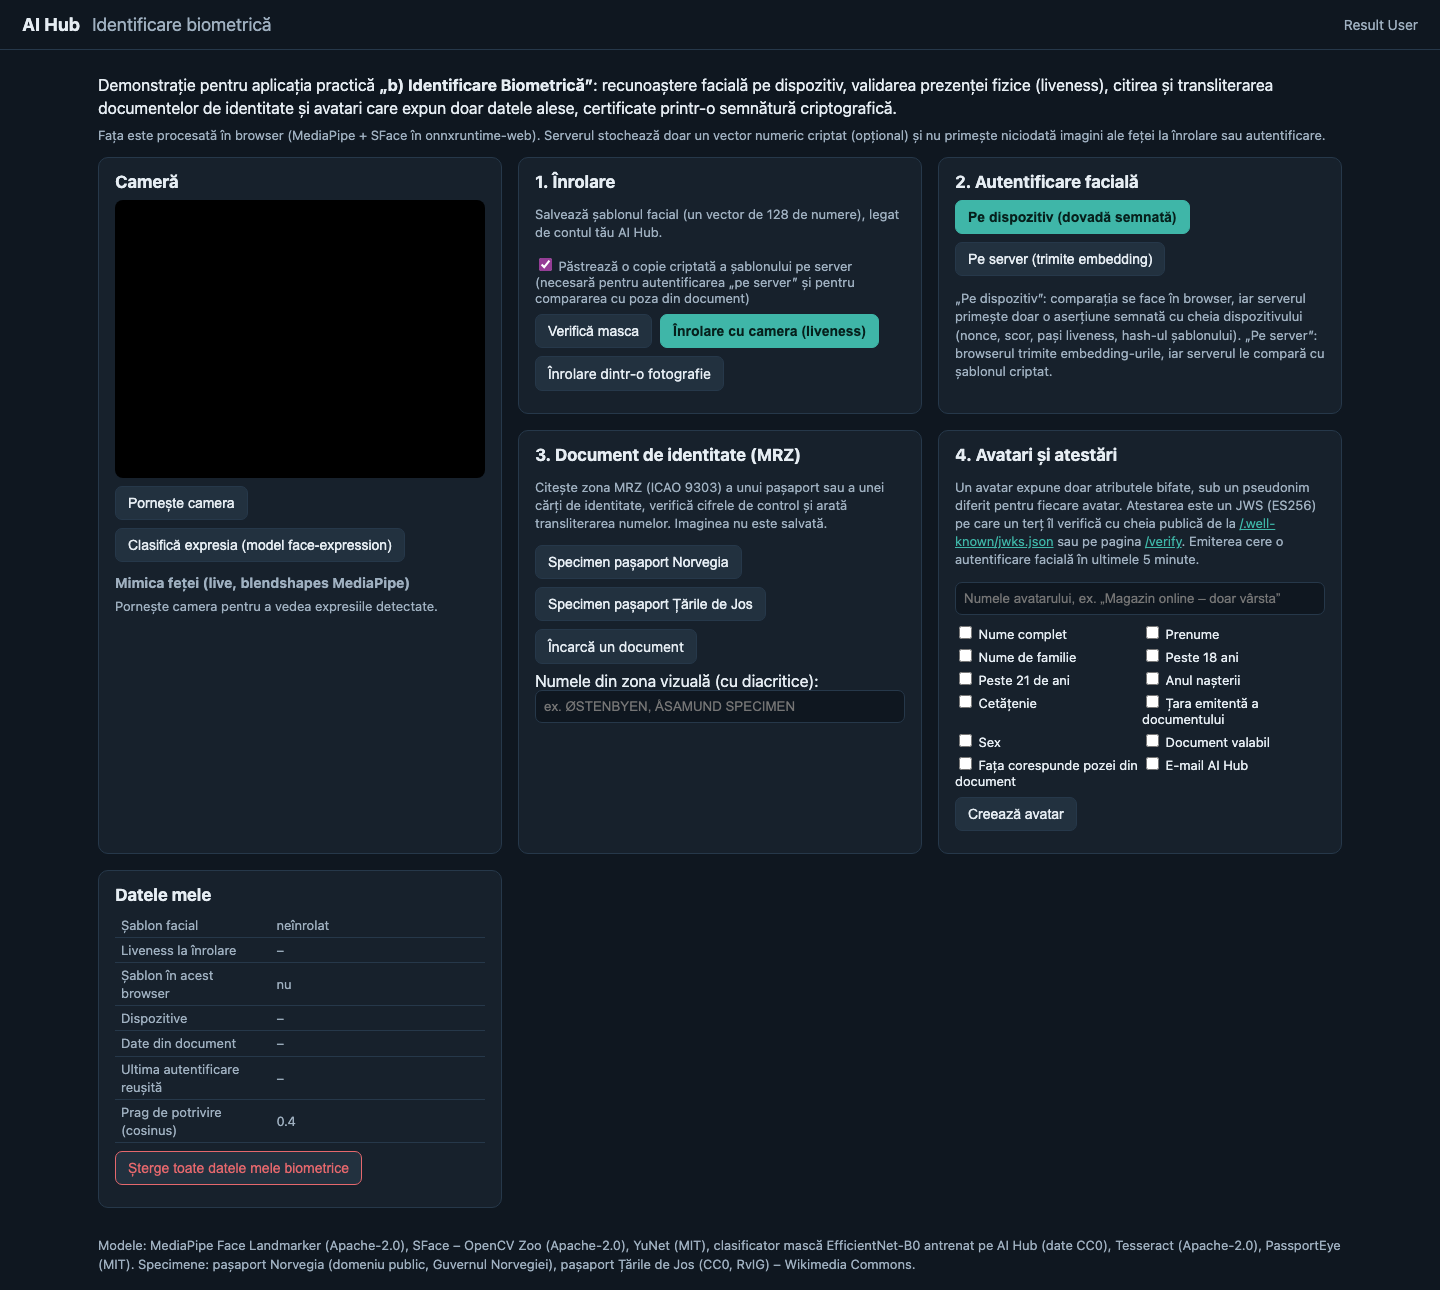
Fața este procesată în browser (MediaPipe + SFace în onnxruntime-web); serverul primește cel mult un vector de 128 de
numere (criptat), iar în modul „pe dispozitiv” nici atât: confirmarea din cloud se bazează doar pe o semnătură ECDSA a
cheii dispozitivului peste nonce și hash-ul șablonului. Atestările sunt JWS ES256, verificabile de oricine cu cheia
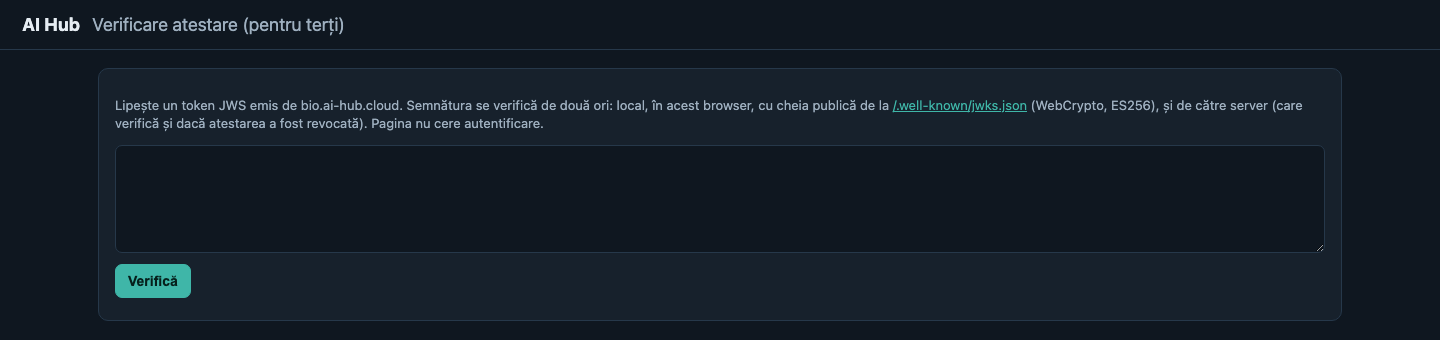
publică (/.well-known/jwks.json, pagina /verify).
| Componentă C.4 | Implementare | Stare |
|---|---|---|
| Aplicație mobilă iOS pentru recunoaștere facială on-device | aplicația React Native din 2023 (ai-hub-demo-react-native, Regula FaceSDK), configurată acum spre bio.onprem.ai-hub.cloud, dar neconstruită; demo-ul web rulează în browserul telefonului cu același flux on-device |
parțial |
| Aplicație mobilă Android pentru recunoaștere facială on-device | aceeași aplicație React Native (Android); demo-ul web pe mobil | parțial |
| Modul de validare a prezenței fizice | liveness verificat pe server: provocare semnată (3 pași aleatori, 2 min, o singură folosire); browserul trimite câte un cadru pe fază, iar serverul verifică acțiunea, o singură față, aceeași identitate, timpii și anti-spoofing-ul pasiv face-antispoofing |
parțial |
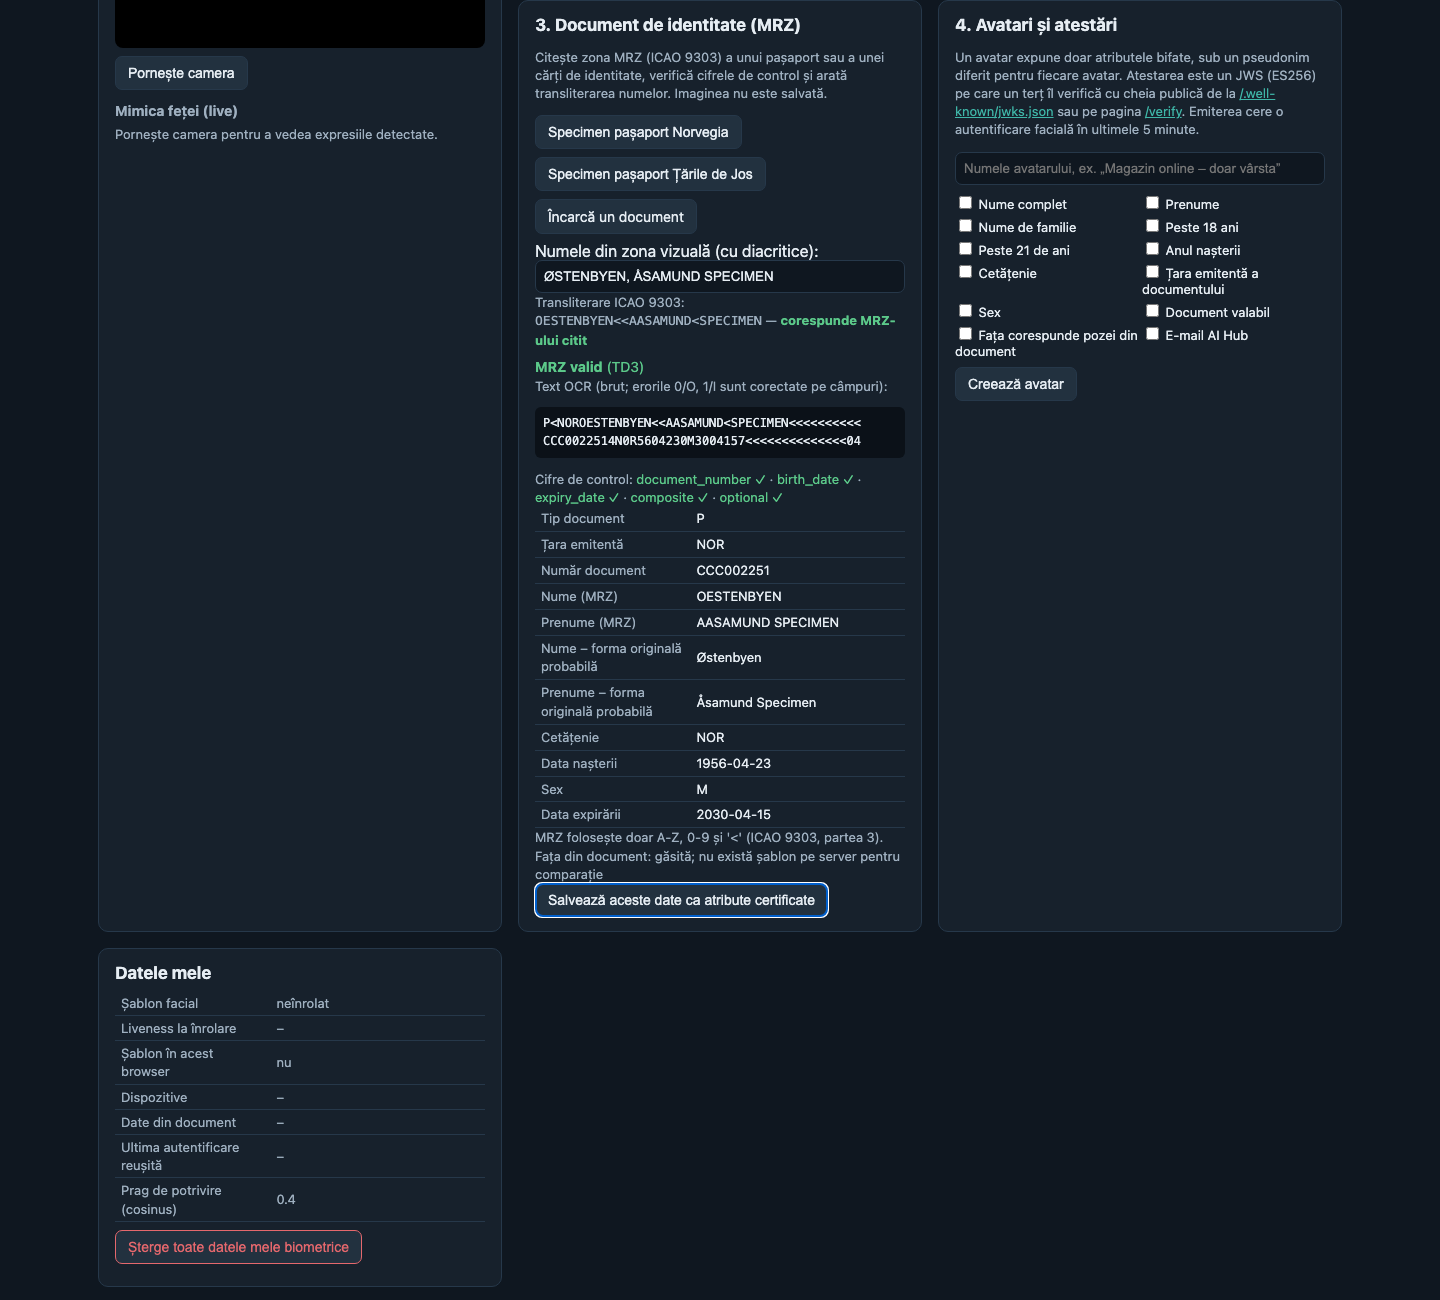
| Modul de transliterare a documentelor de identitate | citire MRZ ICAO 9303 (TD1/TD2/TD3) cu cifrele de control, transliterare ICAO și reconstituirea formei originale (ex. „OESTENBYEN” → „Østenbyen”) | funcțional |
| Avatari care expun doar datele alese, certificate către terți | avatari cu atribute bifate (inclusiv derivate, ca „peste 18 ani”), pseudonim diferit pe avatar, atestare semnată, verificare publică, revocare | funcțional |
Anti-spoofing pasiv (face-antispoofing, MiniFASNet, Apache-2.0), evaluat pe eșantioanele CC BY 4.0 Axon Labs
(131 de probe reale, 277 de atacuri):
| Rulare | BPCER | APCER replay (ecran) | APCER print | APCER mască hârtie | APCER silicon | EER |
|---|---|---|---|---|---|---|
| ansamblu V2 + V1SE (folosit în demo) | 1,53% | 0,00% | 46,43% | 94,56% | 100% | 19,67% |
Detectorul oprește atacurile cu ecran și respinge rar oamenii reali, prinde doar o parte din fotografiile tipărite și nu oprește măștile; contra lor rămâne doar provocarea activă, nemăsurată pe un set public.
Verificare automată (runda 2): testul de API 19/19 pentru liveness-ul verificat pe server (cadre reale din London Set acceptate, anti-spoofing 0,998–0,9996; token reutilizat, modificat, al altui utilizator sau faze în altă ordine respinse; un cadru dintr-un atac cu ecran are scorul 0,0002 și este respins). Runda 1: testul de API 15/15 (înrolare cu liveness, autentificare pe server – aceeași persoană 0,770, altă persoană 0,072 –, respingerea provocărilor reutilizate și a aserțiunilor modificate, MRZ, atestare, verificare publică, revocare); în browser headless: încărcarea modelelor în 1,9–5,0 s, înrolare dintr-o fotografie în 41 ms, citirea ambelor specimene, pagina /verify.
Limitări
- Fluxurile cu camera din browser (provocarea cu trimiterea cadrelor, masca și expresia din cameră) nu au fost testate cu o cameră reală: browserul headless nu are cameră și nici WebGL; partea de server e acoperită de testul de API. Pragurile acțiunilor pe server nu sunt calibrate pe camere reale. Trebuie încercate manual înainte de demo-ul oficial.
- Aplicația React Native nu a fost construită (Xcode și Android SDK indisponibile); depinde de Regula FaceSDK
(licență comercială);
BaseUrlindică acum bio.onprem.ai-hub.cloud, dar ecranele nu folosesc încă API-ul (lipsesc login-ul SSO și cheia dispozitivului), iar ecranul de liveness nu este legat în navigație. - Măștile (hârtie, 3D, silicon) trec de detectorul pasiv; injectarea video (deepfake în timp real) nu poate fi oprită fără atestarea aplicației (Play Integrity / App Attest).
- Documentul nu e verificat criptografic (MRZ, nu cipul NFC); seturile de antrenare ale modelelor faciale preantrenate (MS1M, VGGFace2, CASIA) au termeni de cercetare – pentru uz comercial e nevoie de analiză juridică sau reantrenare.
Licențe
Licențele fiecărui model și set de date sunt pe pagina Licențe și surse de date. Atenție la modelele cu termeni doar de cercetare: ArcFace R100 (antrenat pe MS-Celeb-1M), facenet VGGFace2 (doar comparație), LFW (doar benchmark), ponderile ImageNet folosite ca inițializare.