Training and Operating Model Factory
Portalul AI Hub pentru toți clienții (C.4, componenta 3), legat de MLOps (ZenML) și MLflow. Aici se întâlnesc utilizatorul de rezultat, augmentatorul, operatorul de antrenare, dezvoltatorul de modele și furnizorul de date; aici se văd costul vectorial al antrenării, calitatea și comparațiile între algoritmi.
- Ce este
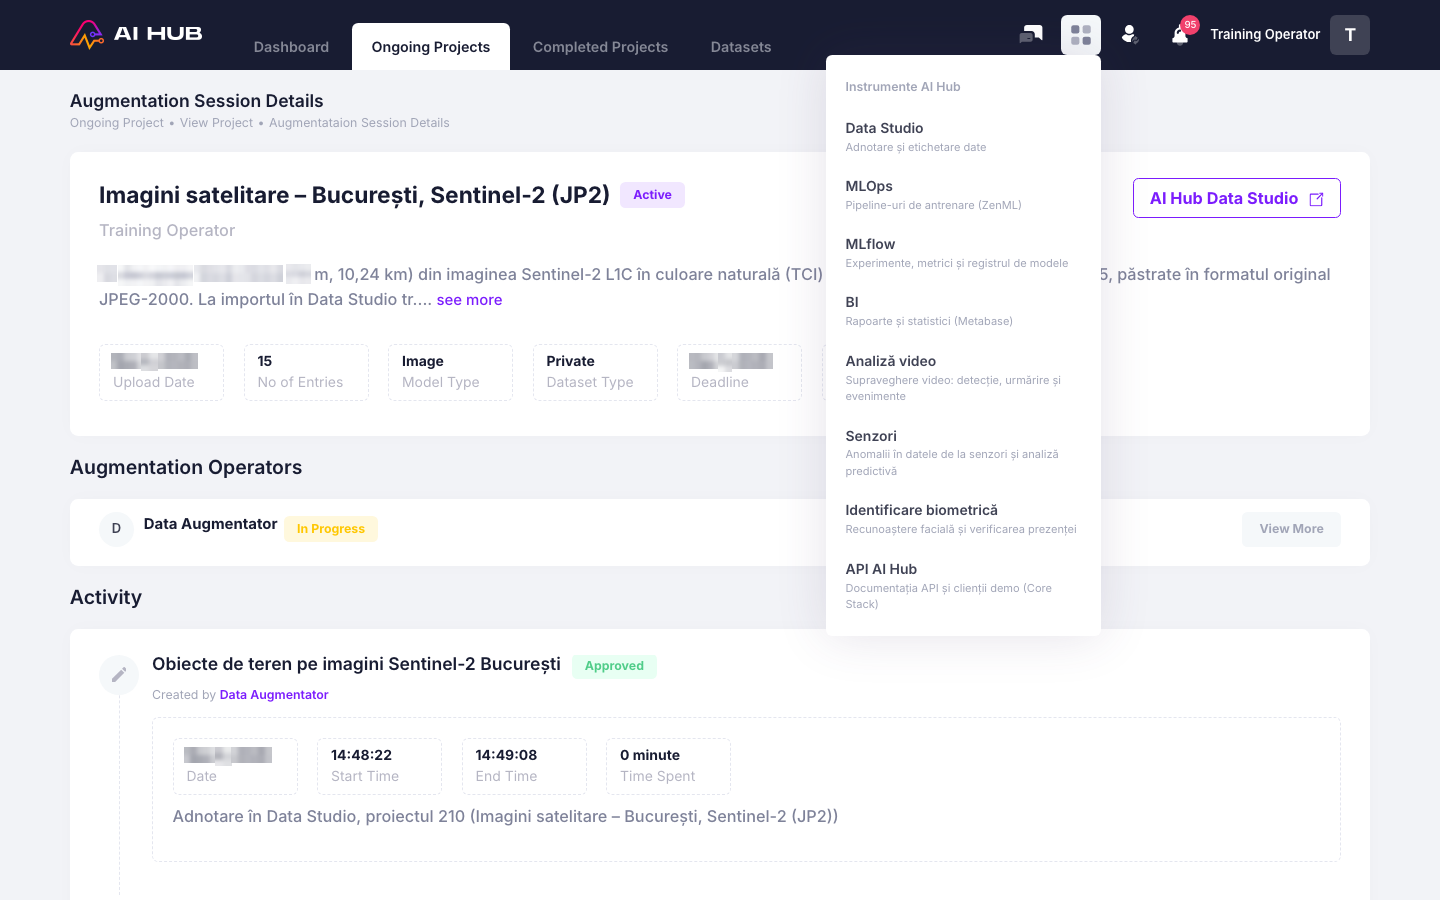
- Rolurile și meniurile
- Proiecte, cereri și aprobări
- Modelul ML cu metrici reale din MLflow
- Costul vectorial al antrenării |K, per epocă
- Calitatea augmentării |Q
- Rapoarte comparative de performanță / cost
- Re-antrenare la fiecare solicitare, cu om în buclă
- MLOps: pipeline-urile
- Cum se demonstrează
Ce este
| Componentă | Adresă | Rol |
|---|---|---|
| Portalul AI Hub (Angular) | onprem.ai-hub.cloud | proiecte, echipe, dataset-uri, sesiuni de augmentare, cereri de resurse și de dezvoltare, modele ML, aprobări, chat, suport, notificări |
| Backend (Symfony / Sonata) | ai-api.onprem.ai-hub.cloud | API REST pe roluri, evenimente live (Mercure), integrarea cu Data Studio și MLflow |
| AI Hub MLOps (ZenML 0.40) | mlops.onprem.ai-hub.cloud | pipeline-uri loader → trainer → evaluator pe GPU, stack-ul ai-hub (S3, MLflow, Data Studio ca adnotator) |
| AI Hub MLflow (3.17) | mlflow.onprem.ai-hub.cloud | rulări, metrici de calitate și cost per pas/epocă, comparații, registrul de modele |
Rolurile și meniurile
| Rol (C.4) | Rol în portal | Meniul de sus | Instrumente AI Hub |
|---|---|---|---|
| Utilizator de rezultat | Result User | My projects, Finished Projects, Data Sets, Wallet, Team Search, Contact (AI Hub ASK, User ASK, My Tickets) | Analiză video, Senzori, Identificare biometrică, API AI Hub |
| (administrare proiect) | Project Admin | Ongoing / Invited / Completed Projects, Marketplace, Datasets, Team Search | Data Studio, MLflow, BI, Analiză video, Senzori, Identificare biometrică, API AI Hub |
| Operator de antrenare | Training Operator | Dashboard, Ongoing / Completed Projects, Datasets | Data Studio, MLOps, MLflow, BI, Analiză video, Senzori, Identificare biometrică, API AI Hub |
| Augmentator de date | Data Augmentator | Invited / My / Proposed Projects, Balance, Contact | Data Studio, Identificare biometrică, API AI Hub |
| Dezvoltator de model ML | ML Model Developer | Dashboard, Invited Projects, My Projects, ML Model List | Data Studio, MLOps, MLflow, Analiză video, Senzori, Identificare biometrică, API AI Hub |
| Furnizor de date | Data Supplier | Dashboard, Data Set Form, List of Data sets | Data Studio, Identificare biometrică, API AI Hub |
| (suport) | Support Specialist | Tickets | BI, Identificare biometrică, API AI Hub |
Pe toate paginile, bara de sus are chat-ul, meniul Instrumente AI Hub, notificările și profilul. Fluxurile pas cu pas, cu capturi pentru fiecare rol, sunt pe pagina Fluxuri pe roluri.
Proiecte, cereri și aprobări
| Flux | Cine | Unde | Exemplu real |
|---|---|---|---|
| Creare proiect | Result User | New Project (/project/new): nume, descriere, livrabil, buget, termen, dezvoltatori ML, dataset propriu |
4 proiecte: Whisper RO, Gemma extracție, Gemma call-center, Augmentare C.4 |
| Echipa | Result User → Project Admin → restul | pagina proiectului → Invite / Invite Now; acceptare din notificări sau Invited Projects | toți cei 5 membri au acceptat pe proiectul Whisper |
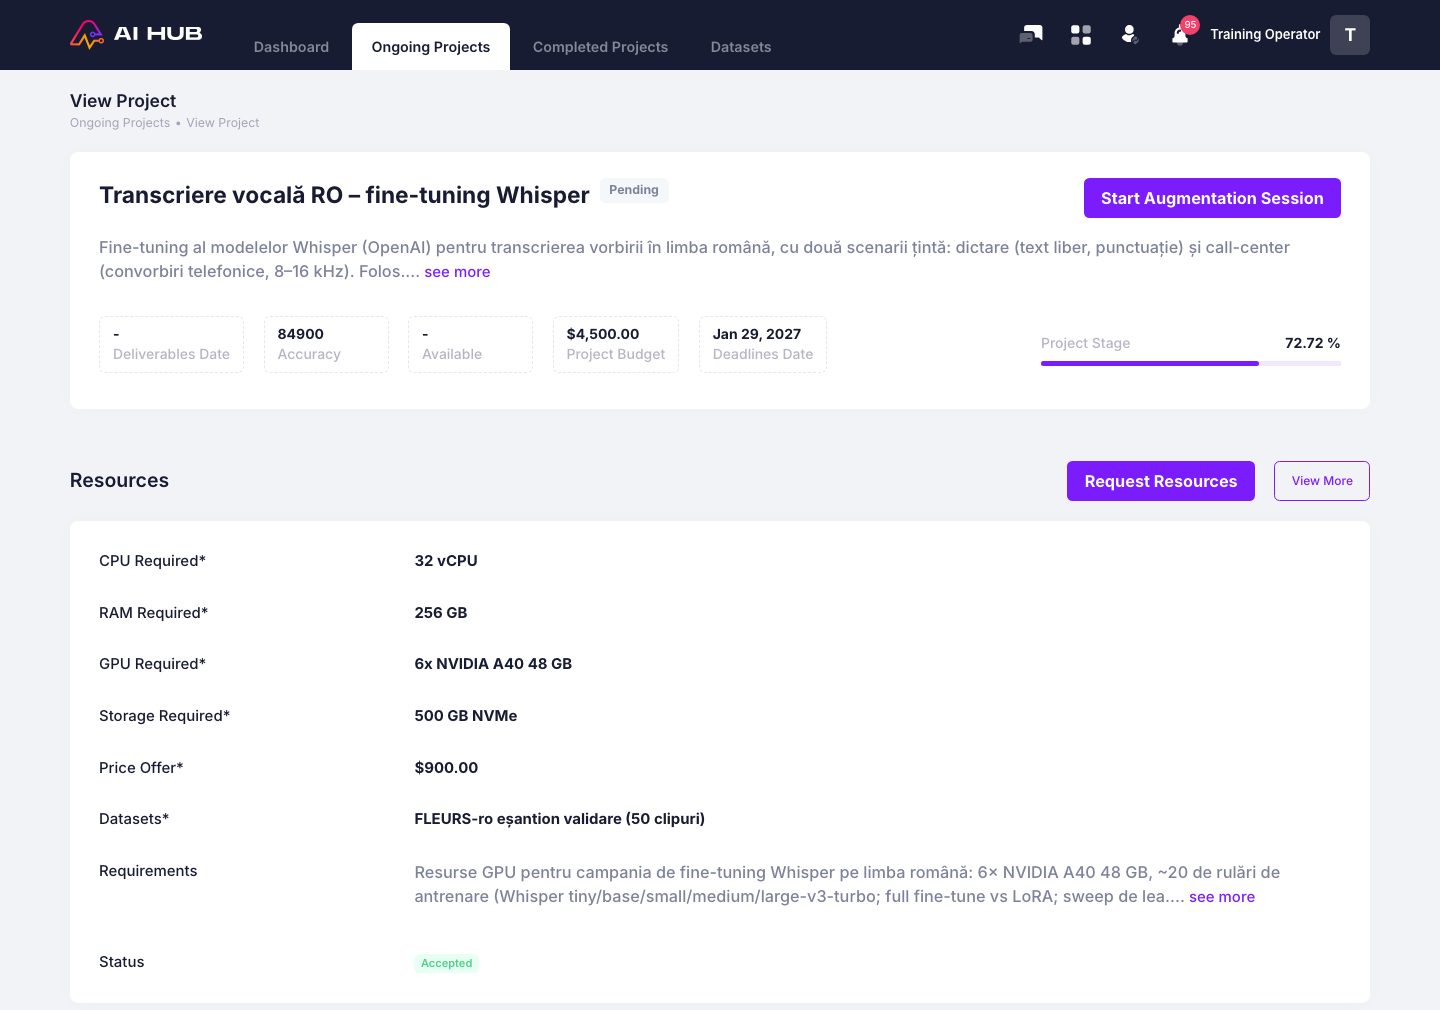
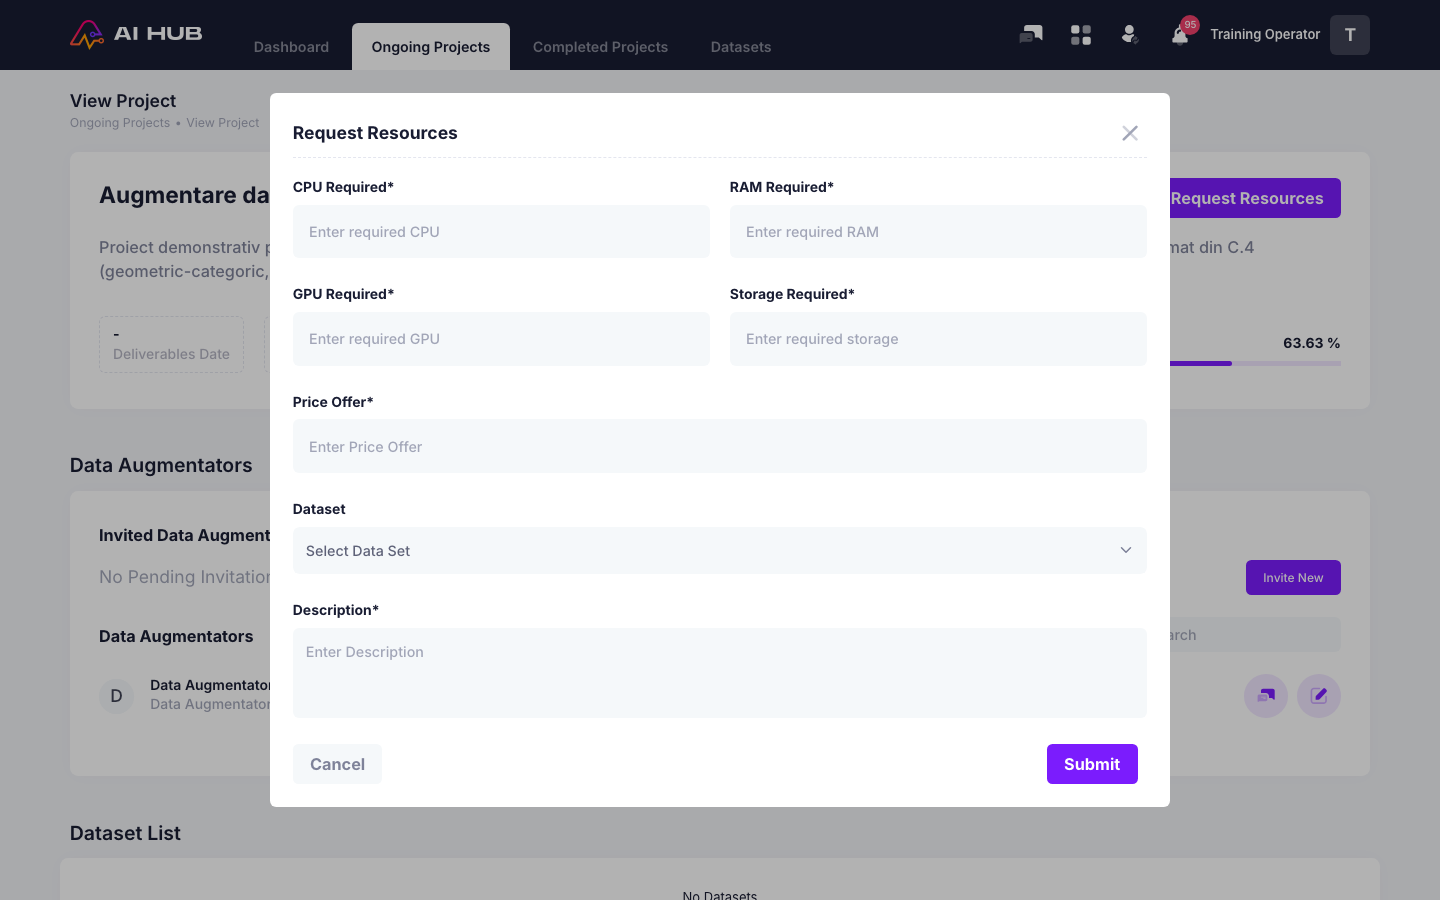
| Cerere de resurse | Training Operator → Project Admin / Result User | proiect → Request Resources: CPU, RAM, GPU, stocare, ofertă de preț, dataset, descriere | „6× NVIDIA A40 48 GB, 32 vCPU, 256 GB RAM, 500 GB NVMe, ~20 rulări, ~30 ore GPU”, status Accepted |
| Dataset-uri | Training Operator / Project Admin → Result User | Datasets / Marketplace → sugerare; gratuitele se adaugă direct, cele cu plată devin cerere | FLEURS-ro (proiectul Whisper), 9 seturi C.4 |
| Sesiune de augmentare | Training Operator → Data Augmentator | proiect → Augmentation Sessions | vezi Marketplace |
| Cerere de dezvoltare | Training Operator → ML Model Developer | sesiune „Ready to use” sau proiect → Development Request | 4 cereri (Whisper v1, v2, Gemma extracție, Gemma call-center) |
| Model ML propus și aprobat | ML Model Developer → Result User | ML Model List / formularul de model → Send Suggestion; Result User → Accept | 5 modele „Approved” (inclusiv whisper-ro v5), v4 respins |
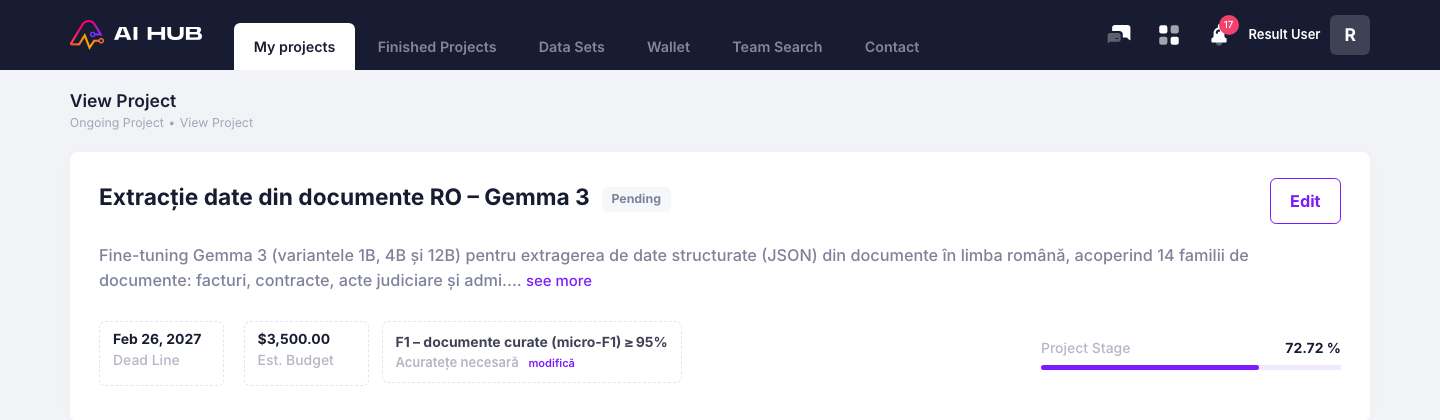
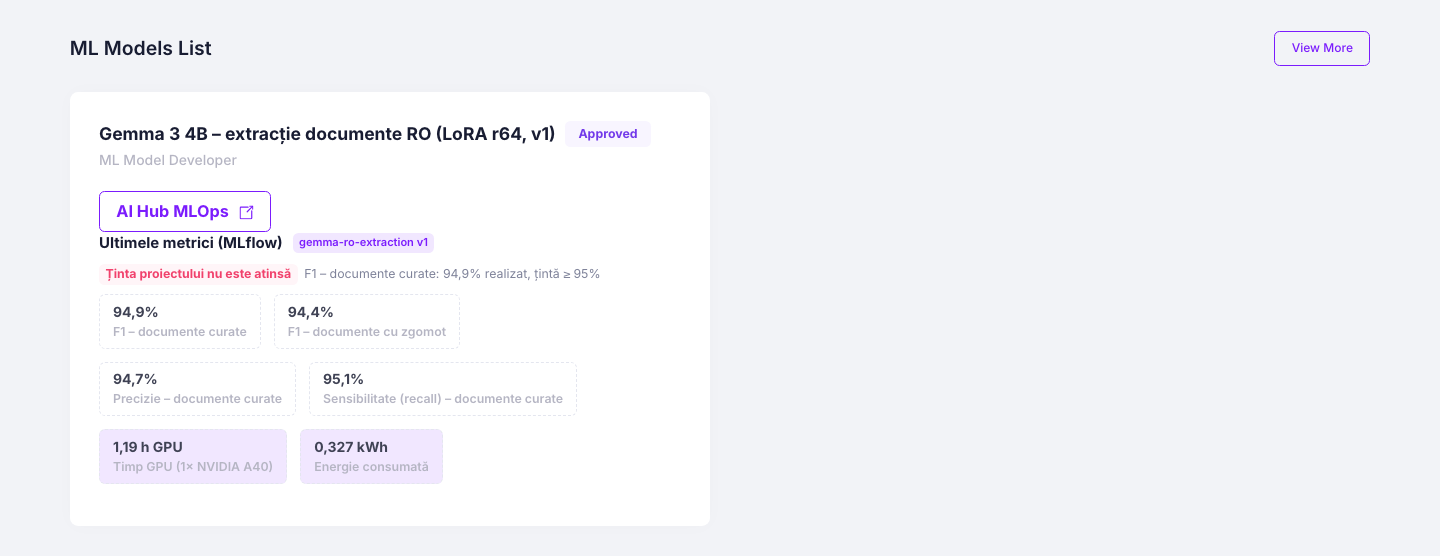
| Acuratețea necesară | Result User | New Project sau pagina proiectului → „Acuratețe necesară”; cardurile modelelor arată „ținta atinsă / nu este atinsă” | proiectul de extracție: F1 ≥ 95%, modelul are 94,9% → nu este atinsă |
| Cotație și comandă | Training Operator → Result User | proiect → Cotație → Generează → Trimite; Result User → Acceptă (comandă) | Whisper: revizia 1 (2.869,26 USD) și revizia 2, suplimentare (3.317,46 USD), acceptate |
Modelul ML cu metrici reale din MLflow
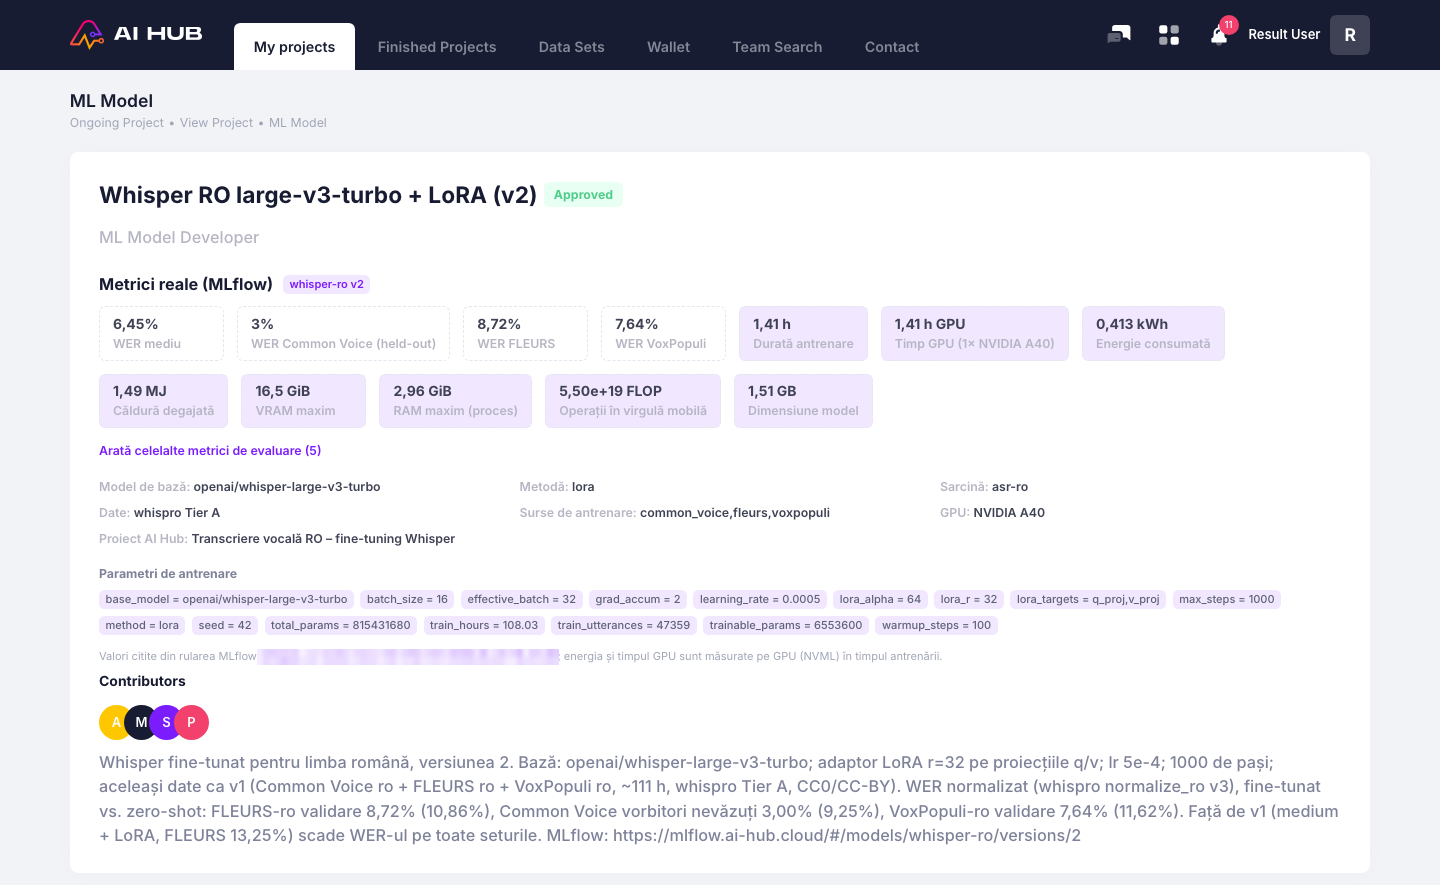
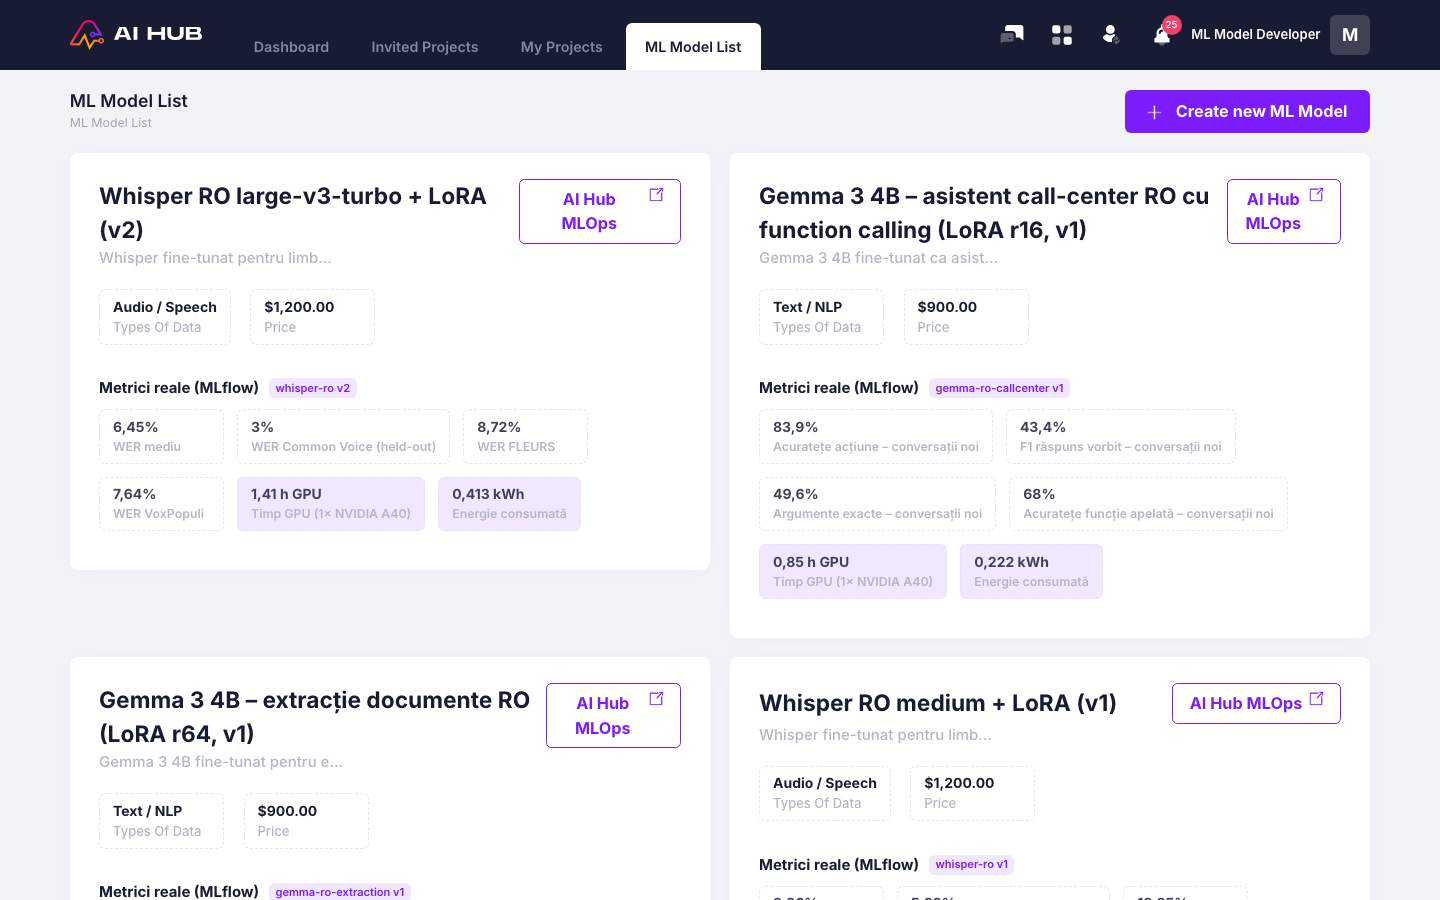
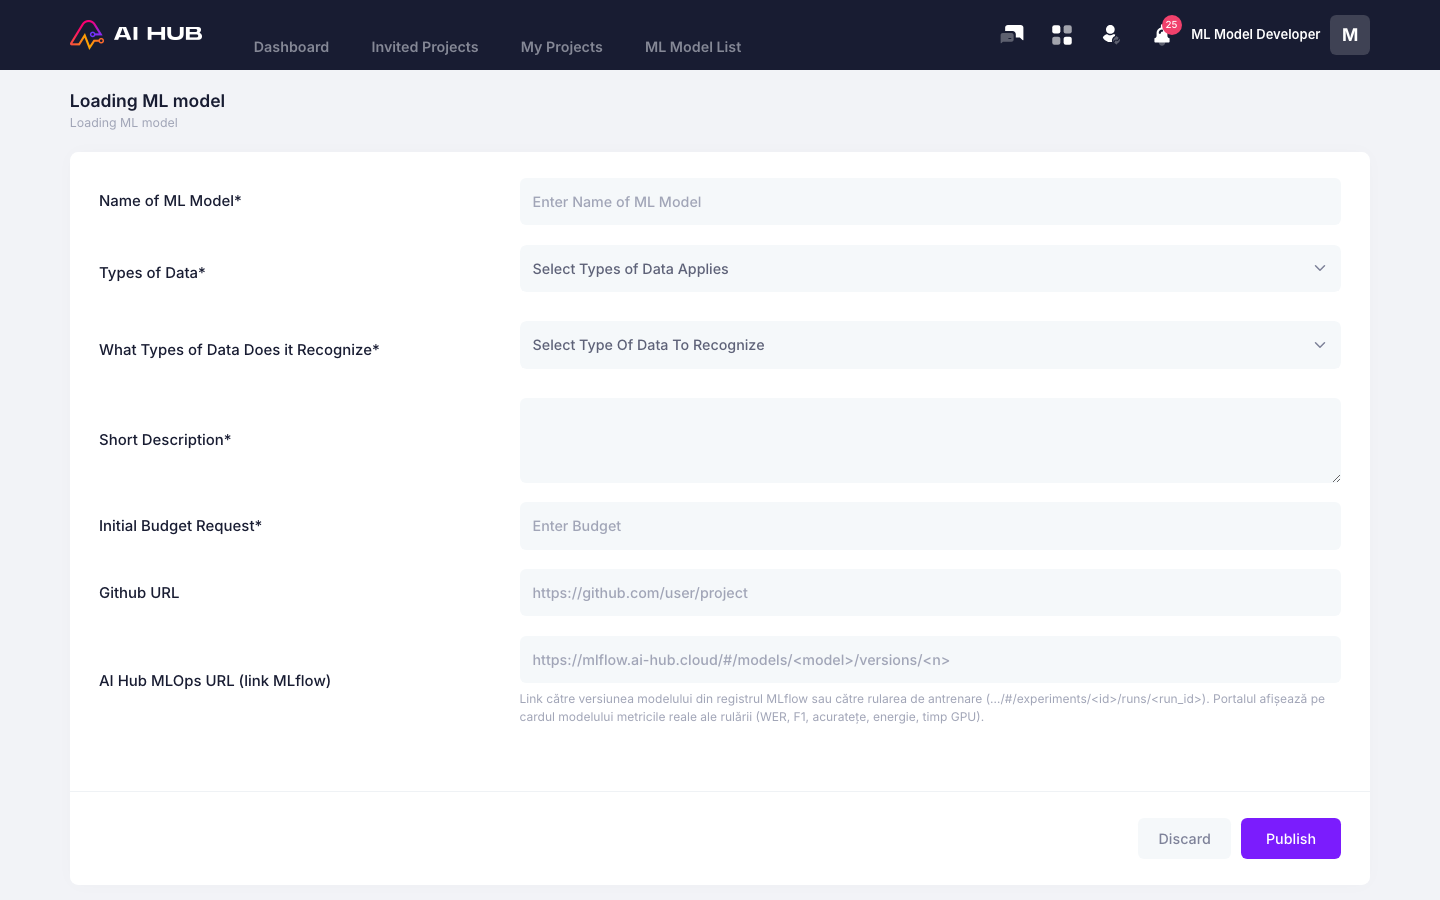
Formularul de model ML are câmpul AI Hub MLOps URL (link MLflow): link la versiunea din registrul MLflow
(https://mlflow.onprem.ai-hub.cloud/#/models/<model>/versions/<n>) sau la rularea de antrenare. Backend-ul rezolvă link-ul prin
API-ul MLflow și afișează „Metrici reale (MLflow)”:
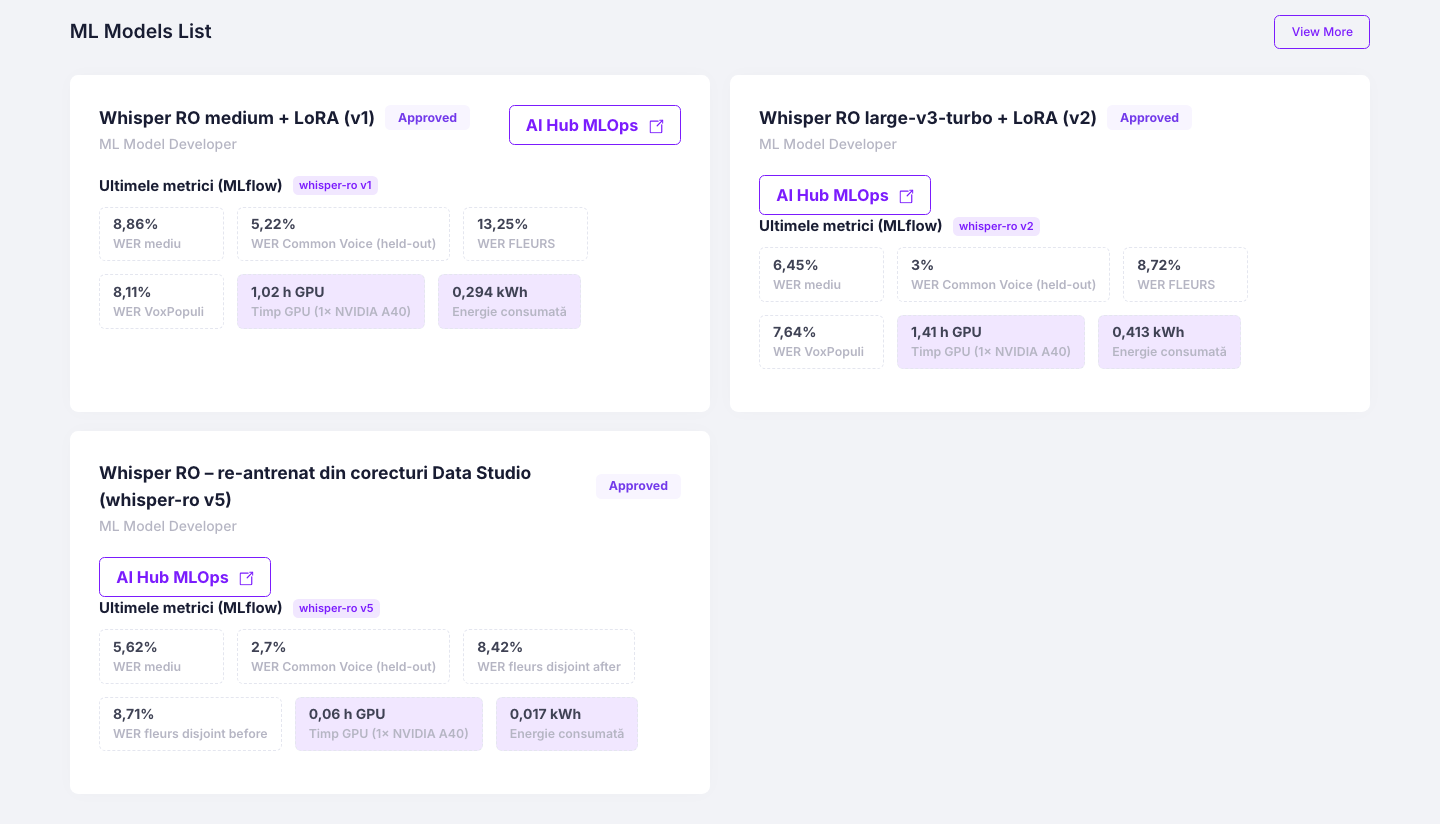
- pe card: metricile principale (WER, F1, acuratețe), timpul GPU, energia în kWh;
- pe pagina modelului: tot vectorul de cost |K (durată, timp GPU, energie, căldură, VRAM și RAM maxime, FLOP, dimensiunea modelului), restul metricilor, tag-urile (model de bază, metodă, date, GPU, proiect AI Hub) și parametrii;
- prin API:
GET /api/v1/{result-user|project-admin|training-operator|ml-model-developer}/ml-model/{id}/metrics.
Tipurile de date ale modelului: Computer Vision, Audio / Speech, Text / NLP, Tabular / Sensors. Modelul are și un preț (câmpul „Initial Budget Request”), stabilit de dezvoltator.
Costul vectorial al antrenării |K, per epocă
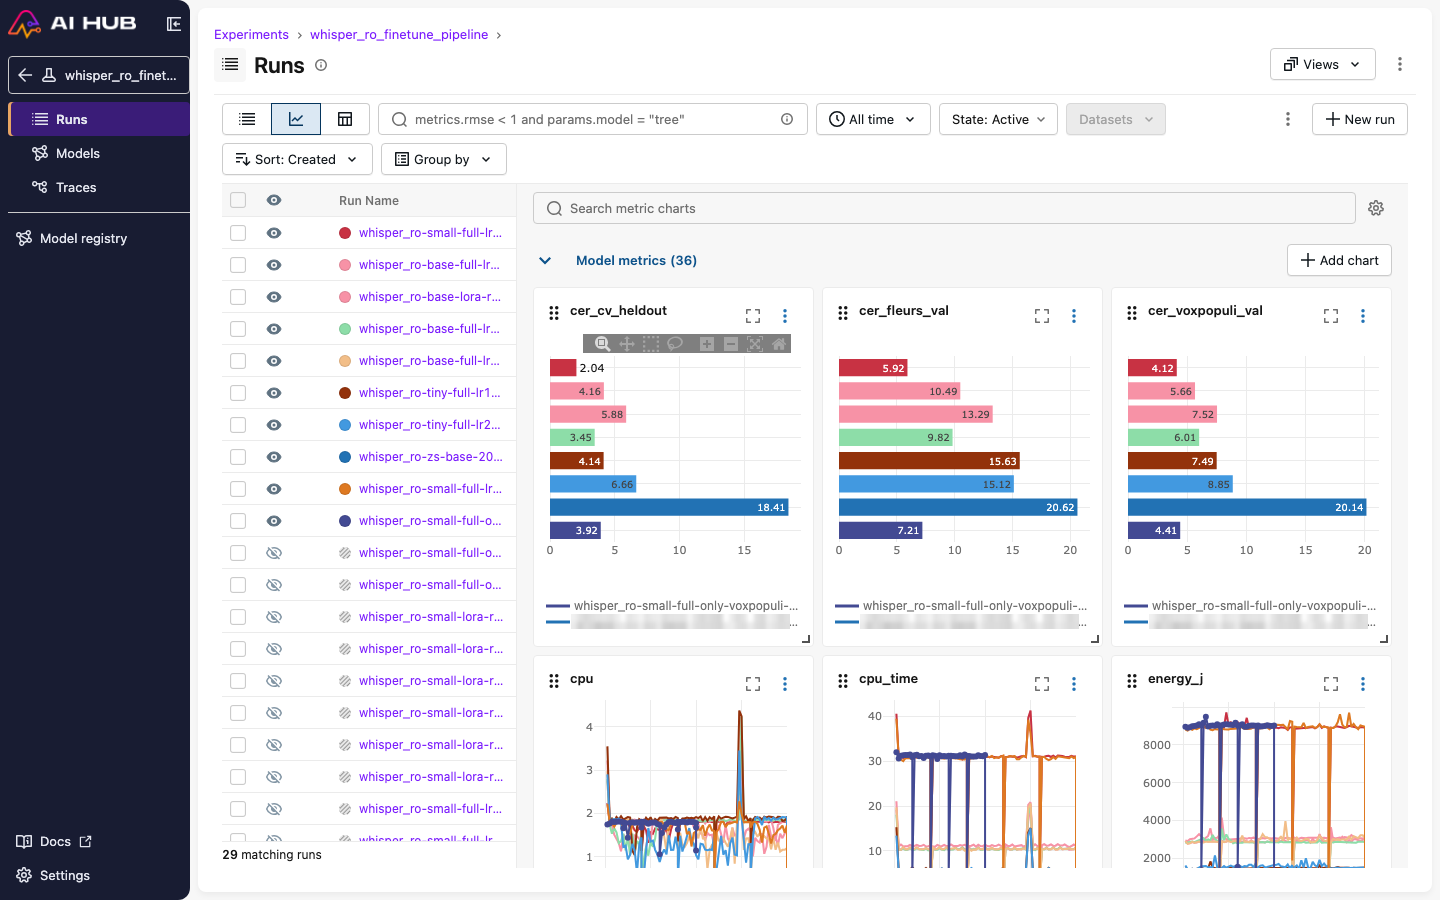
Fiecare pipeline de antrenare are un pas ResourceMonitor care loghează în MLflow, pe fereastră de pași sau
pe epocă, metrici măsurate (NVML pentru GPU, psutil pentru proces):
Un singur monitor comun (training/common/resource_monitor.py), copiat identic în fiecare pachet de antrenare, măsoară
toate elementele C.4; drumul critic se calculează din DAG-ul ZenML pentru toate cele 112 rulări ZenML.
| Element C.4 | Metrica MLflow | Stare |
|---|---|---|
| Durata drumului critic | critical_path_s, pipeline_wall_time_s, parallelism, step_<pas>_s, tag-ul critical_path (cel mai lung drum ponderat din DAG) |
funcțional |
| Durata de ocupare a resurselor (CPU, GPU, memorie volatilă, persistentă, magistrală, I/O) | cpu_time, gpu_time, cpu, gpu, memory, gpu_memory; persistent_mb, fs_used_gb; pcie_rx_mb, pcie_tx_mb (NVML); io_read_bytes, io_write_bytes (cgroup v2), timp de disc, net_recv_bytes, net_sent_bytes |
funcțional |
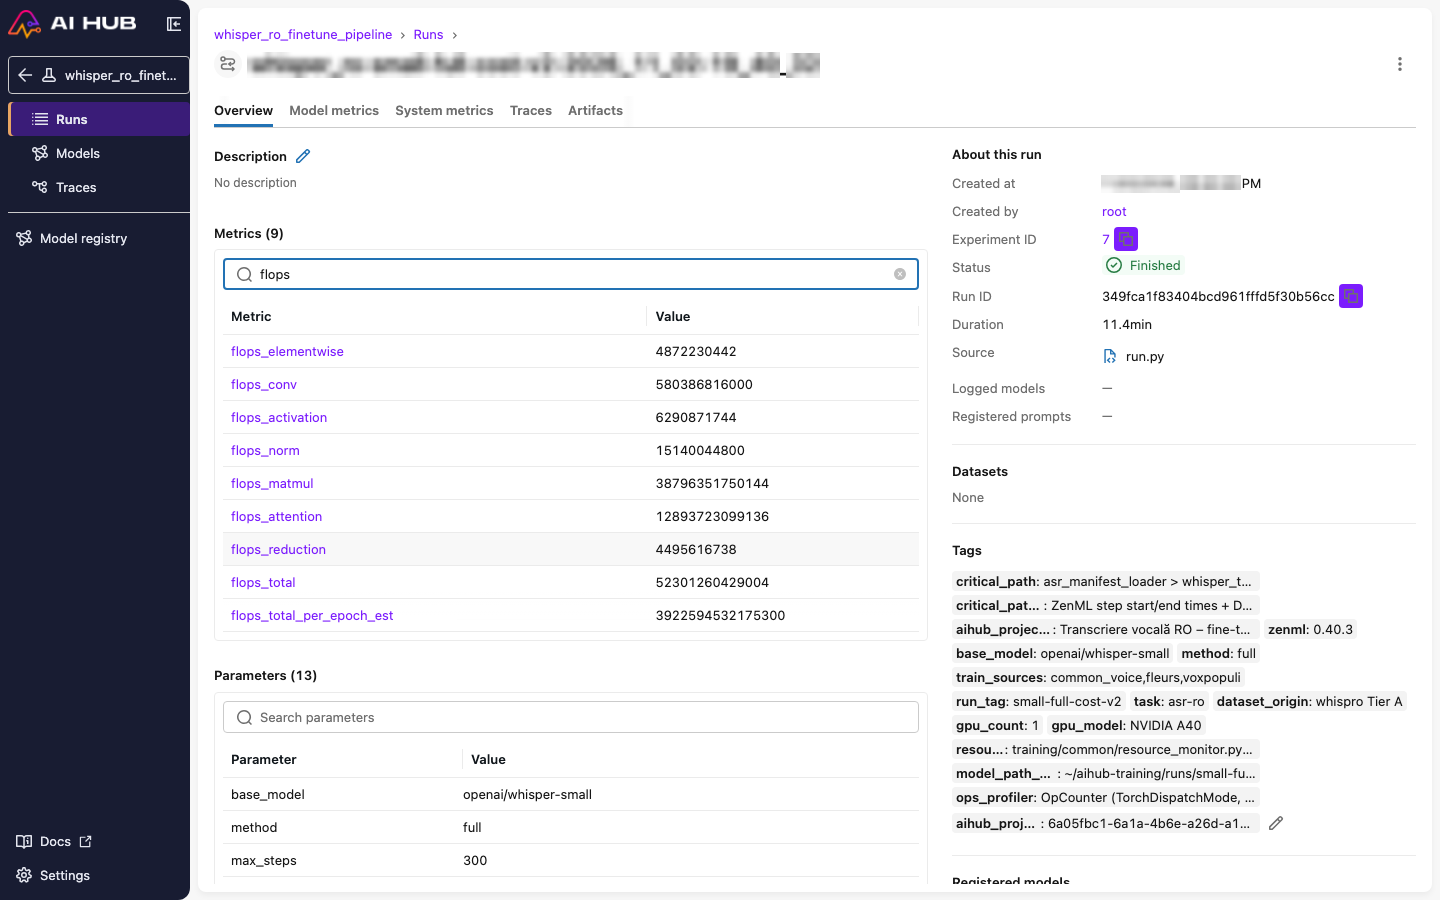
| Numărul operațiilor discrete, per tipuri | ops_<categorie>, flops_<categorie> (matmul, conv, attention, norm, activation, elementwise, reduction, memory), flops_total, flops_total_per_epoch_est |
funcțional |
| Consum de memorie RAM | memory (MiB, per fereastră) |
funcțional |
| Consum de memorie VRAM | gpu_memory (MiB, per fereastră) |
funcțional |
| Efort-mașină pentru antrenare / validare / calibrare | gpu, cpu (utilizare %), gpu_time, cpu_time |
funcțional |
| Energia consumată (J) | energy_j (per fereastră), total_energy_j; epoch_energy_j per epocă la detecție, segmentare și mască |
funcțional |
| Căldura degajată (J) | total_heat_j (egală cu energia electrică a GPU, toată transformată în căldură) |
funcțional |
Rulări reale noi, cu vectorul complet, pe GPU 4:
| Rulare MLflow | Drum critic | Per epocă (măsurat) | Operații pe tipuri | Rezultat |
|---|---|---|---|---|
whisper_ro-small-full-cost-v2 (4 epoci) |
686 s = loader 2 s > trainer 526 s > evaluator 158 s | 117,6 kJ GPU în total; PCIe host→GPU 25,9 GB, GPU→host 5,2 GB; VRAM max 11,8 GB | 5,26·10¹³ FLOP pe pas (matmul 3,90·10¹³, atenție 1,30·10¹³); ≈ 3,9·10¹⁵ FLOP pe epocă | WER mediu 19,95% |
gemma_ro-ext-gemma3-1b-lora-r16-cost-v2 (2 epoci) |
3.563 s = loader 5 s > trainer 1.846 s > evaluator 1.712 s | 454,8 kJ în total; PCIe 73,5 / 20,0 GB; VRAM max 46 GB | 2,56–3,00·10¹⁴ FLOP pe pas; 275.300 de operații pe pas | F1 0,860 (curat) |
mushroom_classifier_pipeline TF (20 de epoci) |
233 s = loader 124 s > trainer 99 s > evaluator 10 s | ~176 J și 1,5 s pe epocă; scriere pe disc 143,7 MB în prima epocă | 3,33·10⁹ FLOP conv pe batch; ≈ 1,9·10¹² FLOP pe epocă | acuratețe validare 0,109 (rețeaua din 2023 supra-învață) |
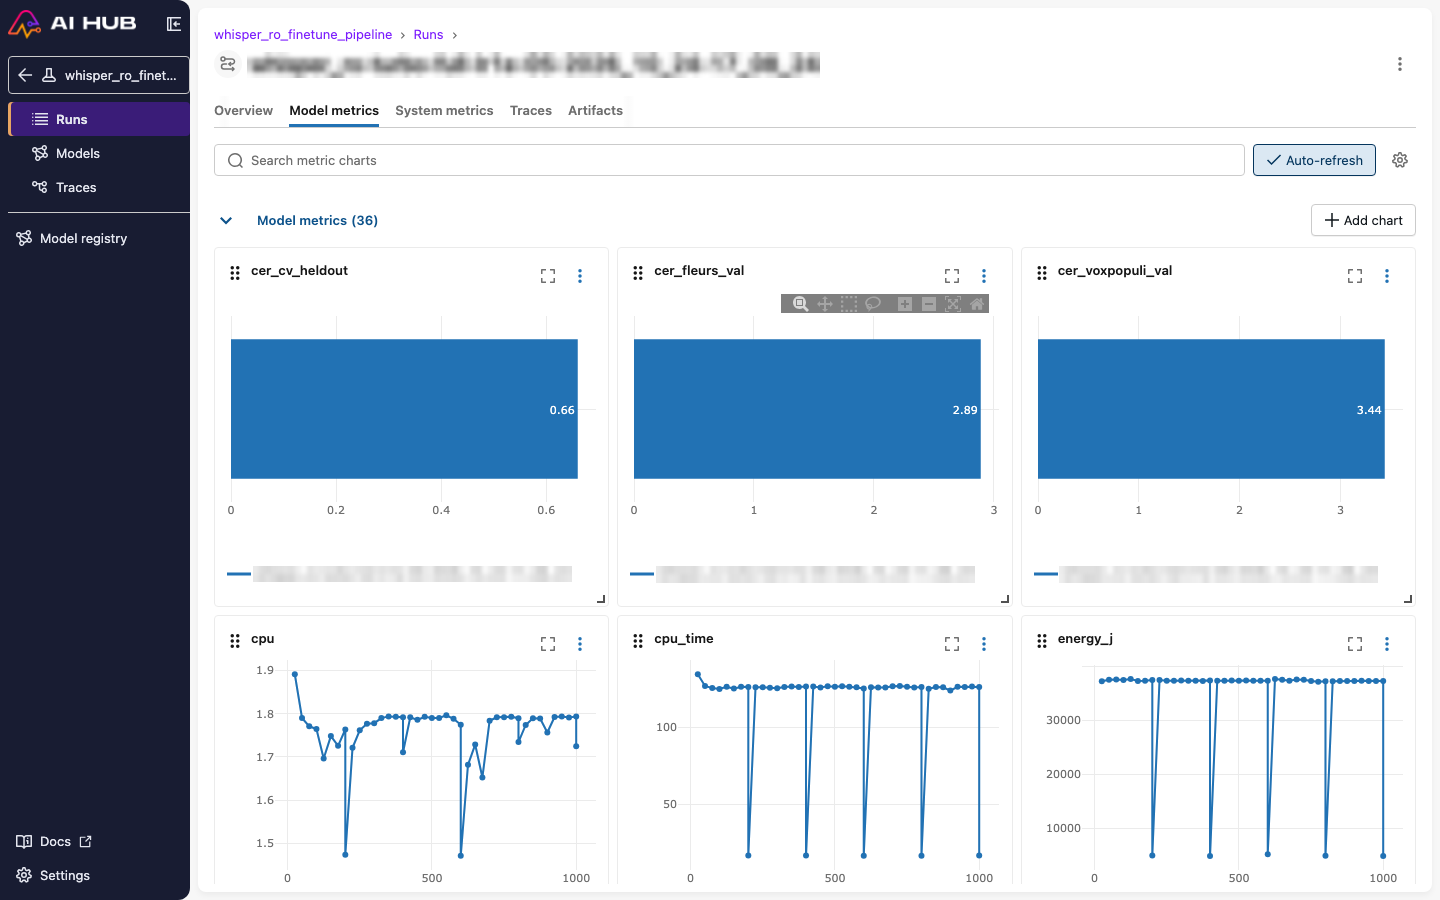
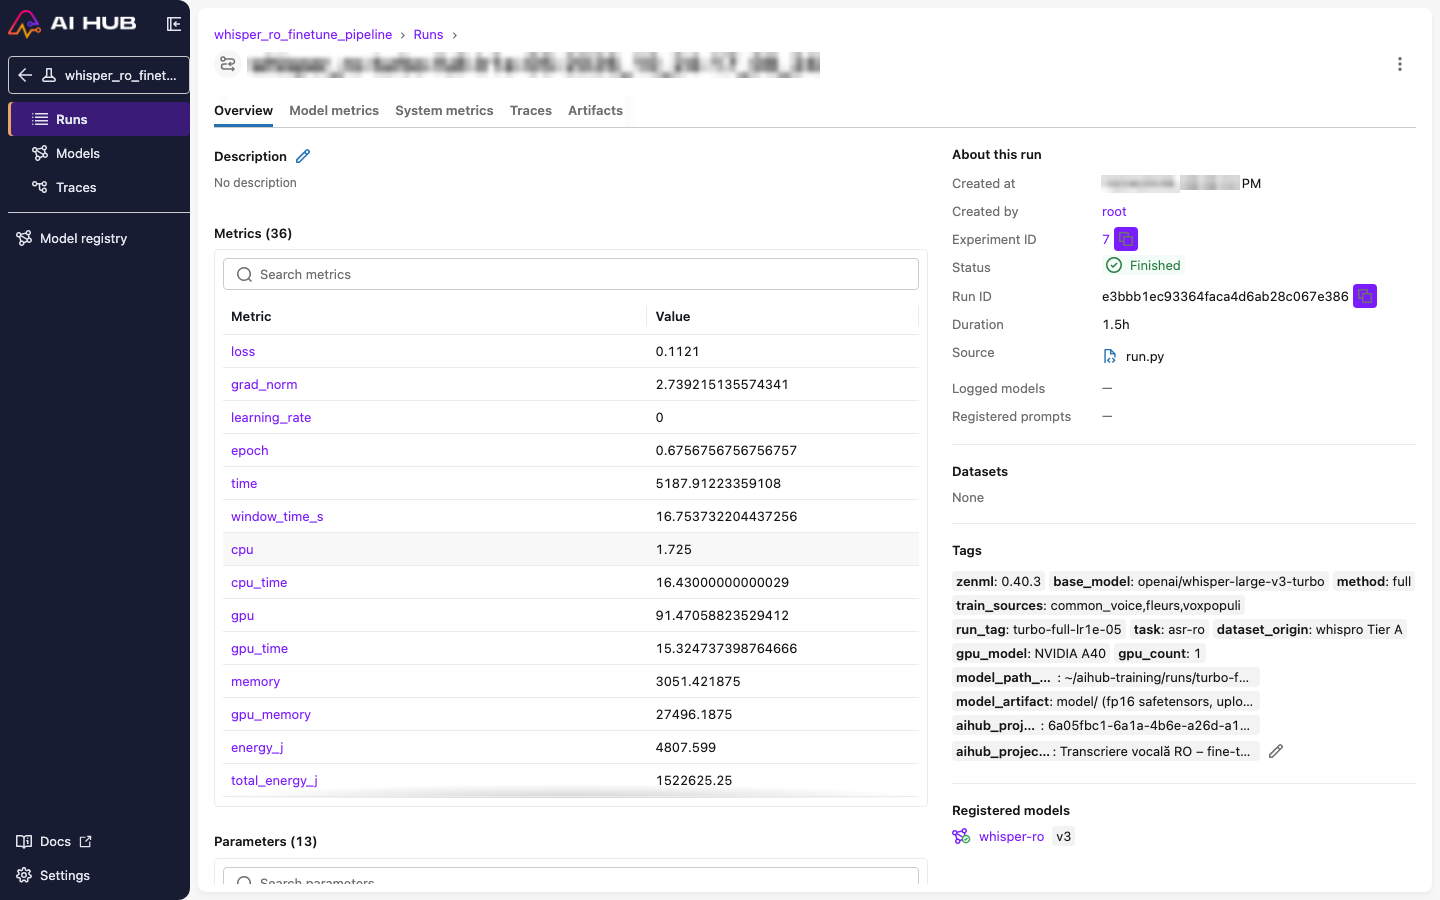
Exemplu real, whisper_ro-turbo-full-lr1e-05 (whisper-ro v3): 1,5 h pe 1× A40, utilizare GPU 91%, VRAM 27,5 GB,
energie totală 1,52 MJ (0,42 kWh); vectorul complet e în MLflow.
Limitări
- Serverul este o mașină virtuală fără contor RAPL: energia CPU nu se măsoară (la senzori și video e estimată din timpul CPU × 7,32 W/nucleu și marcată ca estimare). Energia GPU este a întregii plăci, inclusiv consumul în gol.
- VRAM/RAM „maxime” sunt maximele eșantioanelor, nu vârfuri instantanee.
- I/O de bloc apare 0 când datele vin din page cache; FLOP-urile pe tipuri sunt numărate pe un pas profilat per epocă și extrapolate la epocă.
Calitatea augmentării |Q
Este același raport ca la aplicația de augmentare: BI → „Data Studio Augmentation Raport Performanta” (întrebarea 2). Detalii și limitări: Data Augmentation → Calitate |Q.
Rapoarte comparative de performanță / cost
| Unde | Ce se compară |
|---|---|
| MLflow → experiment → Compare sau modul grafic | orice metrică (WER, F1, energie, timp) între rulări, unul lângă altul |
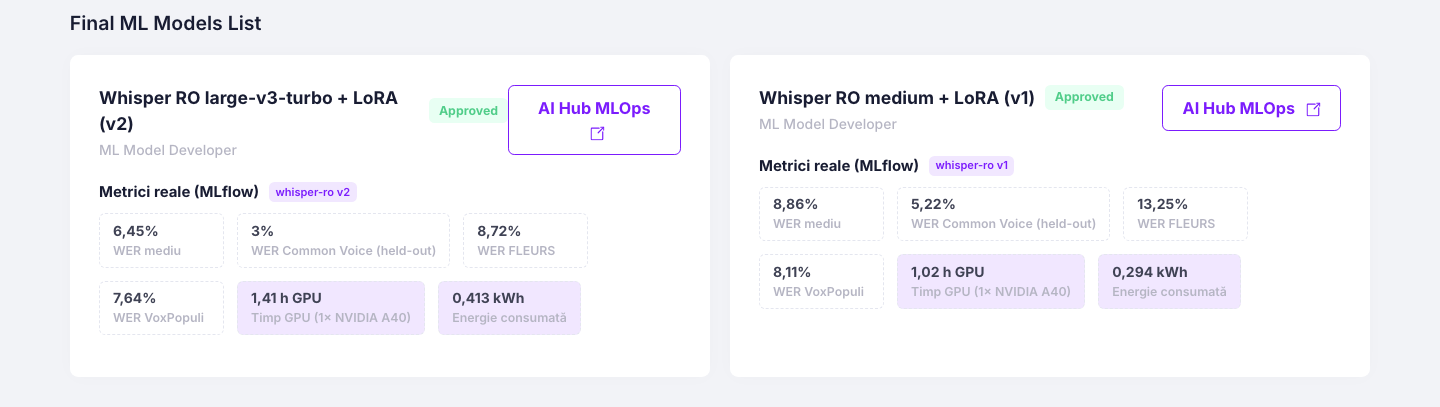
| Portal → proiect → Final ML Models List | modelele propuse pe același proiect, cu tipul de date și metricile reale |
| BI → întrebarea 15 | ore GPU și energie pe proiect |
| Pagina Rezultate | toate modelele, pe tipuri de date |
Exemple: Whisper v1 (WER mediu 8,86%, 0,294 kWh) față de v2 (6,45%, 0,413 kWh); Gemma 3 1B / 4B / 12B la extracție (F1 0,885 → 0,949 → 0,941); 5 modele de sentiment; 6 modele de recunoaștere facială; 5 configurații pentru senzori.
Re-antrenare la fiecare solicitare, cu om în buclă
Serviciul de re-antrenare declanșată de evenimente (container aihub-retrain) urmărește la fiecare 60 s
backend-ul AI Hub (sesiuni de augmentare trecute în „Ready to use”, seturi închiriate, cereri de dezvoltare), Data Studio
(adnotări noi în proiectele seturilor) și cererile operatorului. Regulile leagă fiecare proiect de un pipeline; jobul
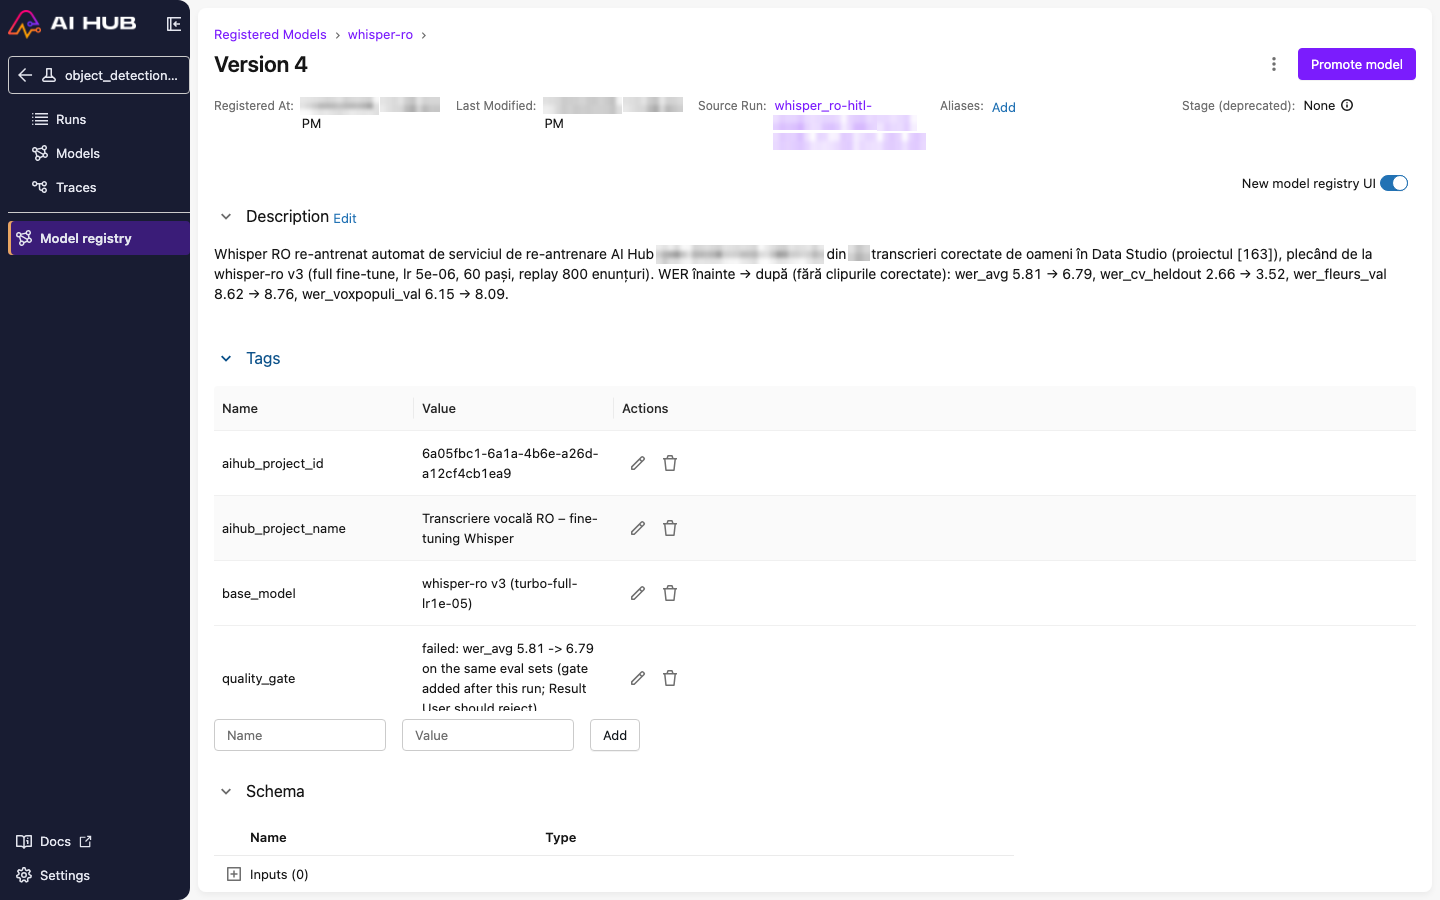
rulează pe GPU 4, rulările au tag-urile aihub_project_id și retrain_trigger, iar modelul nou e înregistrat în MLflow
și propus în portal, după o poartă de calitate (nu se propune un model mai slab decât cel servit).
| Moment | Eveniment |
|---|---|
| 19:51 | 26 de corecturi umane trimise în Data Studio 163 → job whisper-hitl pe GPU 4 |
| 21:08 | whisper-ro v4: WER mediu 5,81 → 6,79 (mai slab) → marcat quality_gate: failed; Result User l-a respins |
| 21:10 | poarta de calitate adăugată; două joburi pornite de reguli prea largi, anulate |
| 21:20 | whisper-ro v5 (lr 1e-6, 40 de pași): WER mediu 5,81 → 5,62 → poartă trecută, propus în portal; Result User l-a aprobat |
Jurnalul complet: GET https://api.onprem.ai-hub.cloud/v1/retrain/events (cheie API sau SSO), 60 de evenimente.
Limitări
Setul de corecturi este mic (26). Pe cele 316 clipuri FLEURS disjuncte de corecturi, WER scade doar de la 8,71 la
8,42 (pe cele 45 cu aceleași propoziții, de la 8,04 la 5,67: memorarea textului). Prima configurație a stricat
modelul; poarta de calitate și decizia Result User-ului sunt protecțiile. API-ul de inferență servește încă
whisper-ro v3.
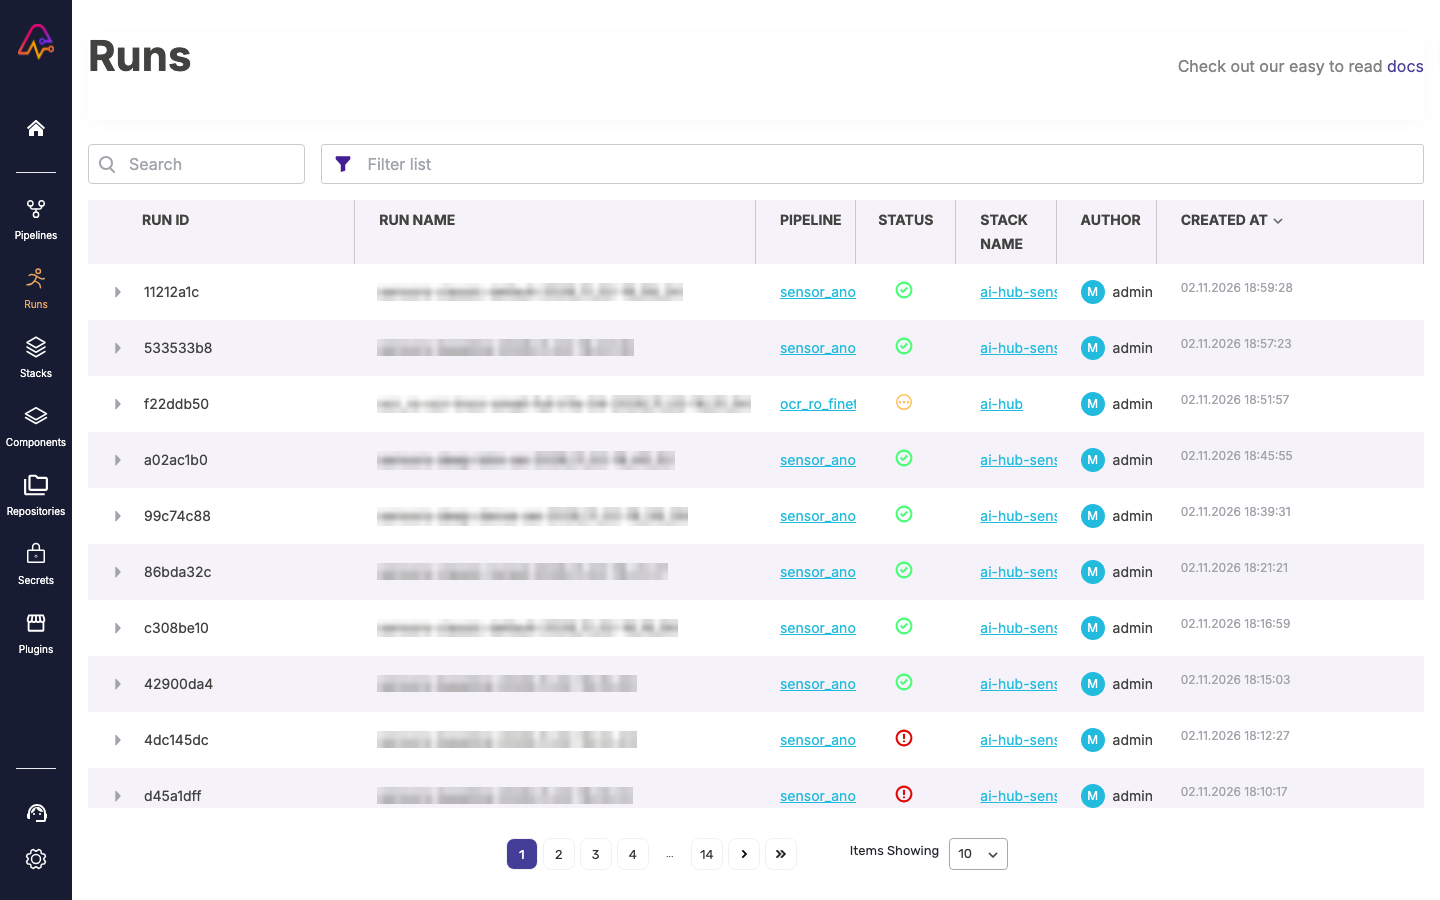
MLOps: pipeline-urile
| Pipeline ZenML | Ce face | Experiment MLflow |
|---|---|---|
whisper_ro_finetune_pipeline |
fine-tuning Whisper (tiny … large-v3-turbo, full / LoRA), re-antrenări cu om în buclă | whisper_ro_finetune_pipeline (34 de rulări) |
gemma_ro_extraction_pipeline, gemma_ro_callcenter_pipeline |
Gemma 3 1B/4B/12B, extracție JSON și agent call-center | 13 + 7 rulări |
ocr_ro_finetune_pipeline, object_detection_pipeline |
OCR românesc (TrOCR) și detecție de obiecte | 6 + 6 rulări |
semantic_segmentation_pipeline, promptable_segmentation_pipeline |
segmentare semantică (mobil / GPU) și cu prompt (SAM) | 2 + 3 rulări |
face_expression_pipeline, face_pad_eval_pipeline |
expresii faciale, anti-spoofing pasiv | 3 + 3 rulări |
video_optical_flow |
flux optic RAFT și urmărire | 8 rulări |
aot_allocation_pipeline, gdpr_anonymization_pipeline |
alocarea AoT a atenției, anonimizarea GDPR | 4 + 26 de rulări |
face_recognition_eval_pipeline, face_mask_pipeline |
recunoaștere facială (evaluare), mască (antrenare) | 6 + 6 rulări |
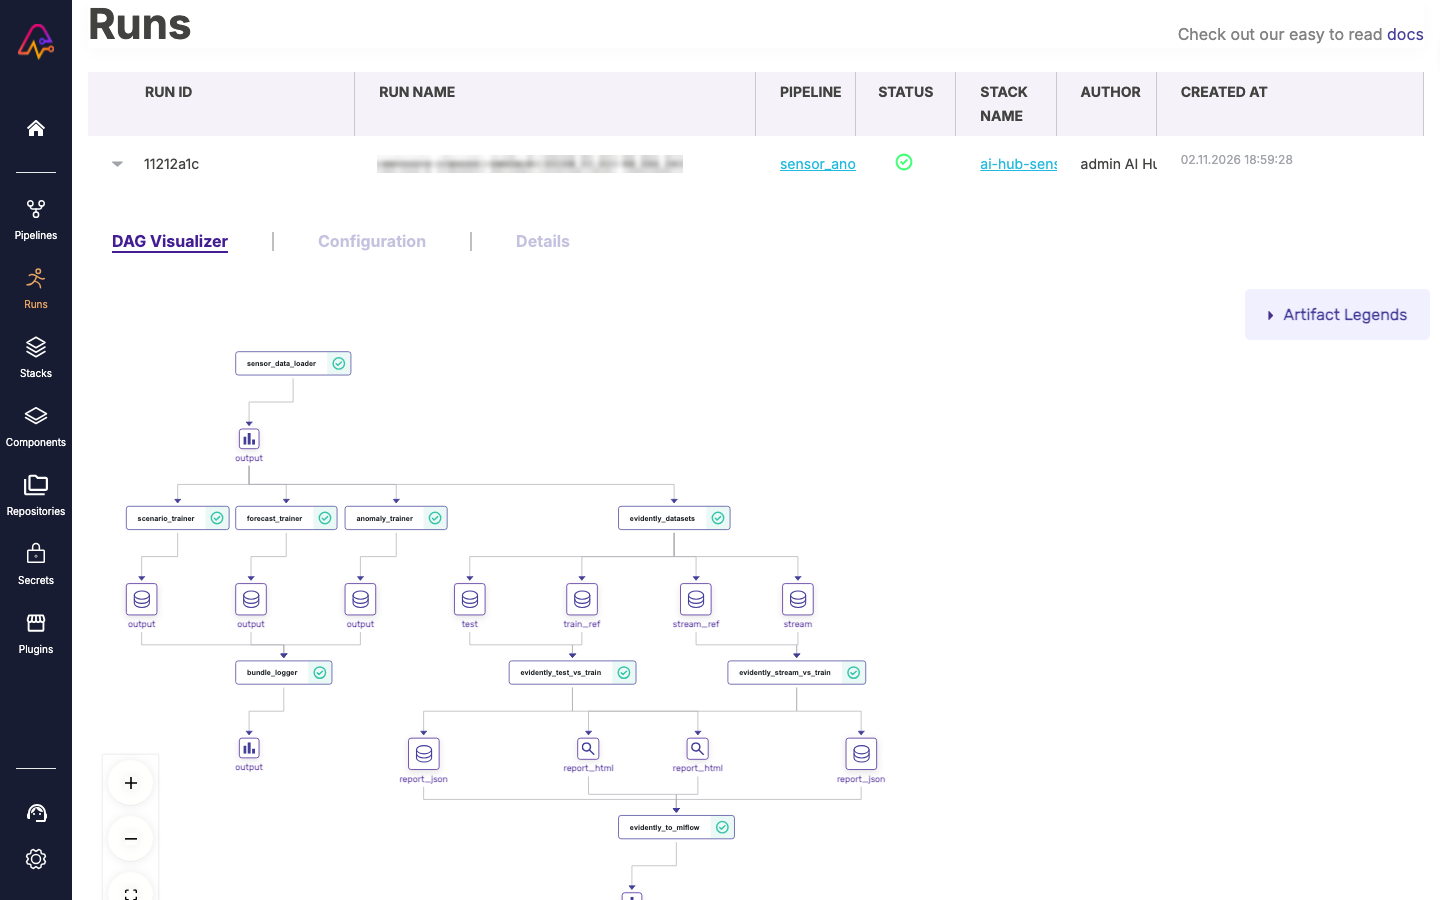
sensor_anomaly_scenario_pipeline |
anomalii, prognoză, scenariu, rapoarte Evidently | 9 rulări |
format_adapters_pipeline, attention_forecast_pipeline |
adaptoare de format, prognoza atenției | 3 + 2 rulări |
Cum se demonstrează
Cum se demonstrează
- Result User: My projects → proiectul „Transcriere vocală RO – fine-tuning Whisper”: stadiul, echipa, dataset-ul închiriat și cele două modele aprobate cu metrici reale.
- Training Operator: Ongoing Projects → același proiect → Request Resources (formular) și cererea aprobată.
- ML Model Developer: ML Model List → un model → pagina cu metrici și Edit (doar pentru creator).
- ML Model Developer: Instrumente → MLflow →
whisper_ro_finetune_pipeline→ o rulare → Model metrics (gpu,gpu_memory,energy_j,total_heat_j); apoi selectează mai multe rulări → Compare. - Training Operator: Instrumente → MLOps → Runs → o rulare → DAG-ul pașilor.
Limitări
- Modelele din 2023 nu au link-uri MLflow valide și afișează „Nu există metrici”.
- Pagina
project-admin/ongoing/ml-model-detailși lista „Finished Projects → ML model” sunt machete din 2023 cu date fixe, nelegate de date reale; secțiunea de comentarii de pe pagina modelului este tot o machetă. - Câmpul „Accuracy” din antetul proiectului la Training Operator (din 2023) afișează o valoare care nu provine din cererea utilizatorului; acuratețea necesară reală este câmpul nou „Acuratețe necesară”.
- Emailurile de notificare se generează, dar nu pleacă (furnizorul de email din 2023 a fost dezactivat); notificările din portal funcționează.